Epoch AI 分析:华为 AI 芯片到 2030 年仍落后 Nvidia 约 4 年
How far behind Nvidia is Huawei?
Epoch AI 报告估算,2026 年华为总 AI 算力产出约为 Nvidia 的 1/25,Ascend 950 性能约为 B300 的 1/7、2022 年 H100 的一半。报告认为即便华为路线图全部兑现并计入走私 HBM 情景,到 2030 年其在芯片性能和算力产出上仍落后 Nvidia 约 4 年,出口管制是主要制约因素。
报告用量化估算比较双方芯片性能、产量和 HBM 供给,读者可以据此理解出口管制下差距的成因与走向。
这是一份更详细报告的摘要,可在我们的网站上查阅。
中美AI竞争涵盖从模型、数据中心到芯片及制造芯片所用设备的方方面面。芯片和制造设备构成这一技术栈的基础,并决定双方能部署多少算力。
这就是为什么半导体出口管制一直是美国AI政策的核心,也是为什么中国本土芯片产业与美国相比处于何种水平如此重要。
华为是中国领先的AI芯片设计公司,去年公布了其芯片路线图,并在上周的年度大会上展示了加速版本。该路线图雄心勃勃:计划在每颗芯片中集成更多算力,将更多芯片连接成单一高速系统,并完善决定这些硬件实际利用率有多高的软件。
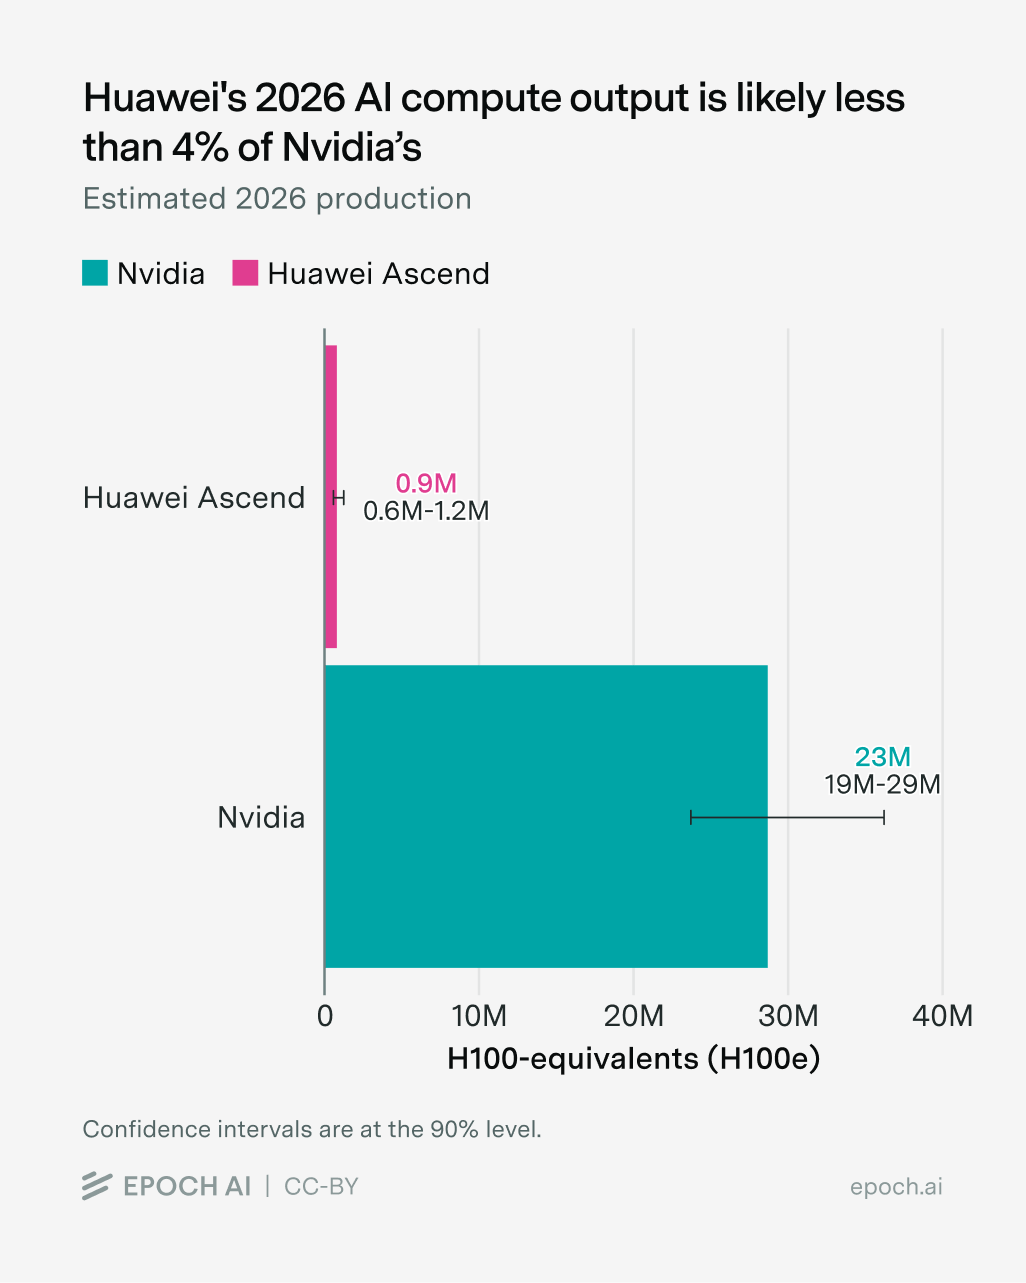
但华为目前在单芯片性能和芯片产量两方面都落后于Nvidia。将两者相乘,华为2026年的总算力产出将比Nvidia少约25倍。美国出口管制限制了华为提升这两项因素的能力,而Nvidia则继续推进前沿。
随着Nvidia不断取得进展,华为能缩小差距吗?
在核算数据后,我们认为几乎肯定不能。从现在到2030年,华为在芯片性能和算力产量两方面可能都将落后约四年。
华为2026年的起点
2026年,华为明显落后于Nvidia。要了解华为需要追赶多远,我们可以比较华为和Nvidia各自产出的总算力,即各自生产的芯片数量乘以这些芯片的性能。我们将所有性能指标换算为等效的Nvidia H100芯片数量,称为H100等效(H100e)。
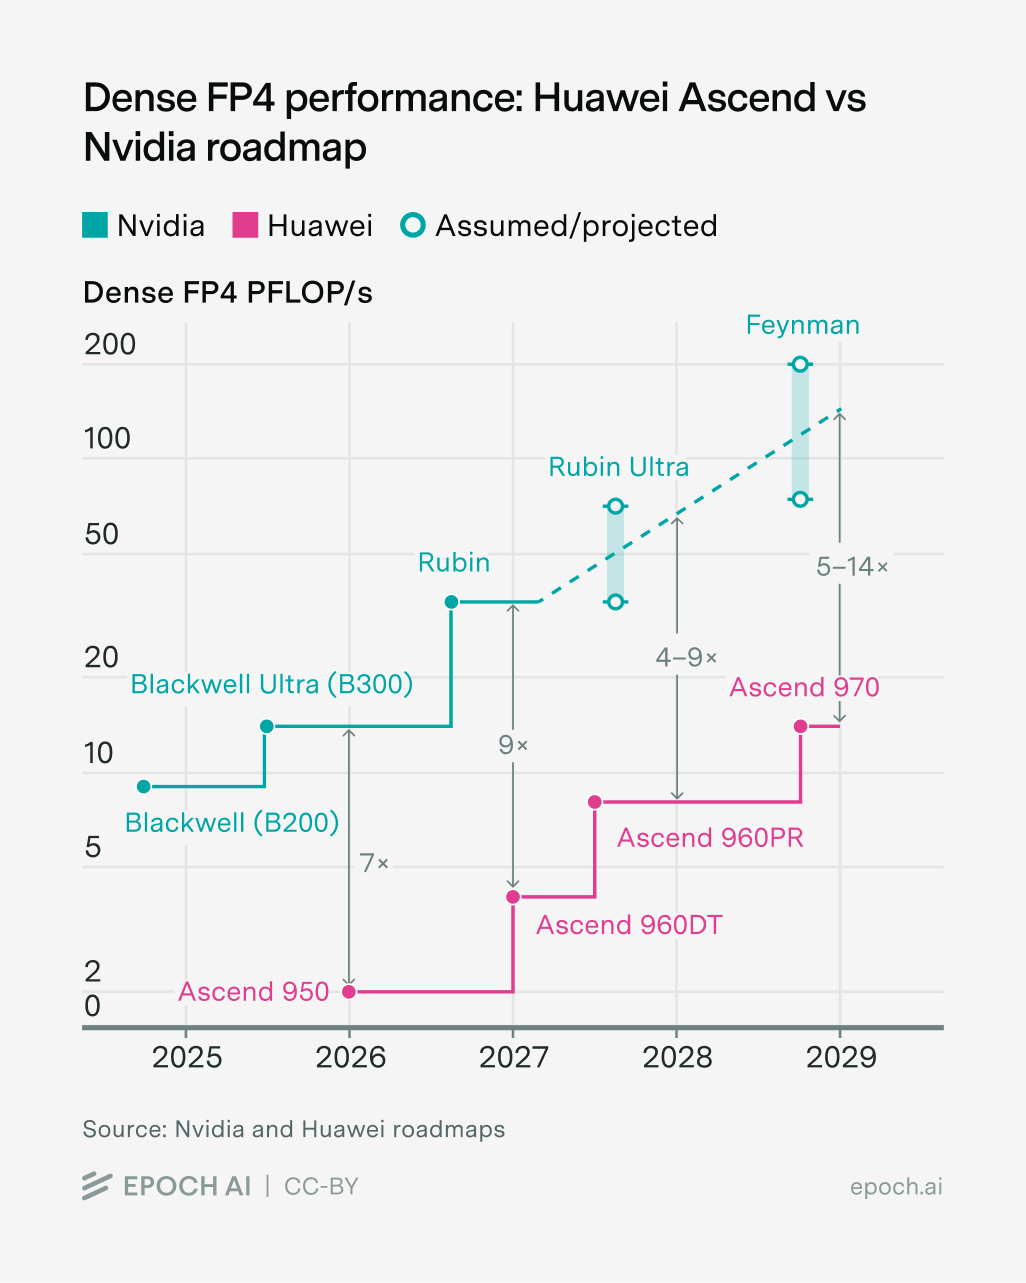
性能:华为2026年的旗舰AI芯片Ascend 950的算力吞吐量比Nvidia的B300少约7倍,仅为Nvidia 2022年H100的一半。换言之,华为最新、最强大的GPU性能仅为Nvidia两代前、2022年开始出货的芯片的一半,这表明华为的芯片性能目前落后Nvidia四年。1
产量:对于2026年,我们估计华为将生产150万颗芯片——为Nvidia约600万颗的四分之一。
总算力:芯片数量为四分之一,每颗芯片性能为七分之一,华为2026年的算力产出将比Nvidia少约25倍。
华为到2030年提升性能的路线图
缩小这一差距需要在单颗芯片和连接它们的系统两方面都取得重大进展——华为已制定了一份雄心勃勃的路线图来同时提升这两方面。
芯片性能
华为在芯片性能上一开始就处于劣势,因为华为的制造合作伙伴中芯国际无法像英伟达的合作伙伴台积电那样密集地封装晶体管。晶体管是芯片性能的构建基础,因此更高的晶体管密度能让工程师在单颗芯片上集成更多算力。
美国出口管制限制向中国销售生产最密集芯片所需的先进光刻机,而中国在国内生产这些机器的努力可能要到2030年之后才会实现。
华为的路线图目标是在两代昇腾芯片上实现7倍的性能提升。由于昇腾芯片无法足够快地提升晶体管密度,它必须从其他方法中获得性能提升。
更大的芯片:首先,华为可以通过把芯片做得更大、为每颗芯片封装更多或更大的逻辑裸片(执行计算的部分)来让芯片更强大,但代价是成本更高、缺陷更多。与此同时,英伟达也在扩大其封装规模,鉴于其工艺更成熟,缺陷可能更少。defects
芯片架构:华为更新的昇腾路线图针对更低精度格式优化了性能,很可能是为了匹配前沿工作负载的发展方向。这一架构更新将使昇腾芯片在相同硅片面积下执行更多计算,显著提升昇腾运行前沿AI工作负载的性能。
垂直堆叠:华为的长期重大押注是将逻辑裸片垂直堆叠,从而在给定面积内装入远超中芯国际单层工艺所能印刷的晶体管数量。堆叠还能缩短芯片内部的通信时间,使芯片能以更低功耗运行得更快。然而,这项被华为称为 LogicFolding 的技术要到 2030 年才会应用于昇腾系列。英伟达预计于 2028 年推出的 Feynman 代产品,据报道将至少堆叠两层其更先进的逻辑裸片,比首款昇腾尝试此举早两年。这将把晶体管密度带来的 2 倍优势叠加为 4 倍优势。
更快的系统
与所有主要芯片设计商一样,华为专注于优化整个计算系统,而不仅仅是单颗芯片。
十年前,前沿模型可以在少量GPU上训练。如今,训练前沿模型需要数万颗AI芯片。在这种规模下,性能在很大程度上取决于芯片之间通信的速度,以及软件在芯片之间协调工作的效率。华为正在同时推进这两方面。
更大的系统:华为计划在单个域内连接更多芯片。域是一组紧密连接在一起的芯片,使它们的行为更像一个巨大的系统,从而减少等待系统其他部分通信所花费的时间。
英伟达的域侧重于在一个72颗芯片的机架内实现极快的链路。在机架内部,任何芯片都能以全速与任何其他芯片通信。由于英伟达更优越的芯片能将通信密集型工作保持在更少的芯片内,它无需为了更大的域规模而牺牲通信速度。
华为走的是另一条路,用更大的域来弥补芯片性能的不足;其规划中的“SuperPoDs”将连接8192颗芯片。然而,要让数千颗芯片同时保持高带宽通信,需要付出难以承受的代价。因此,华为采用了一种通信层级结构:距离更近的芯片拥有更高带宽,距离更远的芯片则必须经过多跳。这种做法能否表现良好,取决于华为的软件能否更好地将通信保持在本地。遗憾的是,由于华为尚未公布关键性能指标,很难说SuperPoD在实际中会有多好的表现。
更好的软件:在芯片之间协调工作负载的软件可以将性能提升10倍以上,而这目前是英伟达最有力的杠杆之一。华为对标英伟达CUDA的产品名为CANN,于2018年首次发布,使用昇腾芯片时颇为困难。当DeepSeek尝试在昇腾芯片上训练其R2模型时,华为派出了自己的工程师,却仍未能完成一次训练运行,促使DeepSeek转回英伟达。不过,如果华为能够借助中国实验室使用其芯片而非英伟达芯片所形成的反馈闭环,软件差距可能会迅速缩小。但就目前而言,这种可能性仍处于萌芽阶段:CANN仍落后CUDA数年,而尽管中国实验室正 越来越多地 使用国产芯片,只要能拿到英伟达硬件,它们仍会转向英伟达硬件。
华为在芯片性能上将落后三到四年
从纸面数据看,英伟达B300的计算性能约为华为昇腾950系列的7倍。随着英伟达从Blackwell芯片转向Rubin和Rubin Ultra,到2027年,两家公司最强芯片之间的差距将扩大到约9倍。首款在峰值性能上有望接近B300的昇腾芯片是970,计划于2028年底出货。鉴于B300于2025年推出,这意味着即便到2029年,华为在芯片层面仍将落后英伟达约三到四年。
华为能否靠产量弥补差距?
假设华为把这一切都做到了:昇腾系列达到路线图目标,SuperPoD在扩展到8000颗芯片时表现良好,CANN也成熟起来。即便如此,其芯片性能仍将落后英伟达数年,因为英伟达是在更先进的基础上拉动同样的杠杆。
如果华为无法在性能上匹敌英伟达——无论是单芯片对单芯片,还是系统对系统——它能否通过生产更多芯片来弥补?
使用国产HBM:华为目前受限于高带宽内存(HBM),因为中国领先的存储制造商CXMT和规模较小的XMC才刚刚开始提升HBM产量,其供应尚无法满足中国芯片设计公司的需求。
在2026至2028年间,我们估计Nvidia每年可生产数千万颗H100等效芯片,到2028年将增至近1亿颗。华为以CXMT和XMC作为其唯一的HBM来源,到2028年可将产量提升至每年约150万颗H100e,约为Nvidia产量的1.5%。
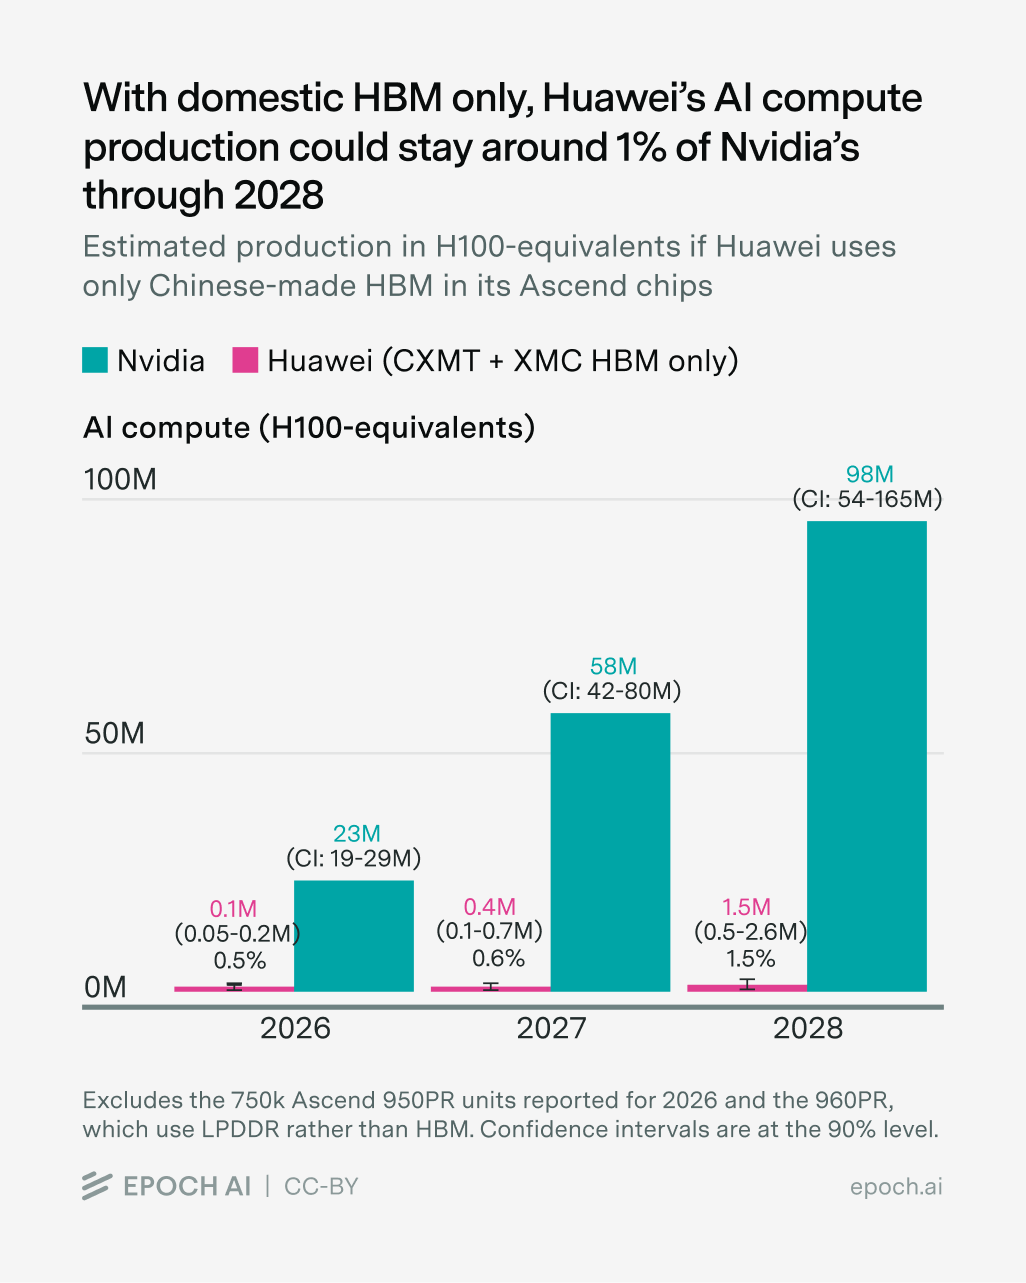
到2030年,中国国产HBM产量预计将大幅提升——乐观情况下可达其2026年产量的18倍。然而,我们的粗略计算表明,华为2030年乐观情形下的算力产量大约相当于Nvidia今年的产量。换言之,华为的算力产出将继续落后Nvidia约4年。
计入走私HBM:2025年,这一缺口由非法获取的组件以及中国企业在2024年12月出口管制生效前积累的逾1000万堆叠外国HBM库存填补。2该库存预计将在2026年耗尽,迫使中国AI芯片产量回落至CXMT的产能加上中国能够走私的数量。
那么,更多走私能否成为解决方案?假设华为在2028年走私的HBM达到其国产量的十倍——这是一个大到不合常理的规模,即便按2025年HBM价格计算也将耗资逾400亿美元。在此情形下,华为的产量将从150万颗H100e增至约1600万颗,仍仅约为Nvidia当年产量的16%。
无论来自走私还是国产,更多的HBM供应能提升华为的产量,但无法弥合差距。
出口管制正在发挥作用
2026年初,华为生产的AI算力约为Nvidia的1/25。其芯片大约落后三到四年,生产这些芯片的供应链也无法与Nvidia匹敌。
从现在到2030年,华为在芯片性能和算力产量上可能都将落后约四年。出口管制在很大程度上造成了这一劣势,同时打击了产量和性能。出口管制虽未完全阻止华为的进步,却使其竞争变得困难得多、缓慢得多、昂贵得多。
与此同时,Nvidia正在扩大其领先优势。Nvidia的HBM供应商——SK Hynix、Samsung和Micron——将在2030年前投入数千亿美元建设晶圆厂。Nvidia的Feynman很可能较Rubin带来显著的性能提升,而到2030年Nvidia甚至可能开始出货Feynman的继任者。
华为是全球最有能力的工程组织之一,它最终或许能够追赶上来——通过在垂直堆叠上超越Nvidia、大幅改进其软件以缩小与CUDA的差距、获得尖端光刻机,以及大幅扩大产量。但克服这些劣势需要时间,而现有信息强烈表明,到2030年这不会发生。
本文是一份更详细报告的摘要,该报告可在我们的网站上查阅。
英伟达的真实领先优势很可能比这一比较所显示的还要大,因为华为的 CANN 软件栈远不如英伟达的 CUDA 成熟,因此昇腾芯片的潜力被利用的比例更低。
迄今为止,昇腾的大部分生产都依赖外国组件。据报道,一项拆解发现,昇腾 910C 部件使用的是台积电的逻辑芯片以及三星或 SK 海力士的 HBM,而非完全国产的硅片。即便华为在其未来的昇腾路线图上达成性能目标,中国的国内供应链能否以生产数百万颗昇腾芯片所需的规模提供关键组件,仍是一个悬而未决的问题。
来源:Epoch AI:Gradient Updates · epochai.substack.com