Odyssey 联合创始人 Jeff Hawke 谈世界模型:仍处 GPT-2 时代
From driving the world to dreaming it
Odyssey 联合创始人兼 CTO Jeff Hawke 在 RAAIS 演讲中阐述世界模型路线,主张直接从视觉和音频学习世界,目标是打造“世界模型的 GPT-3”。
访谈厘清了世界模型与空间智能等概念的边界,并给出四条研究路线和GPT-2阶段的行业定位,信息密度较高。
Jeff Hawke认为AI缺少一种智能形式。在他看来,前沿研究建立在两个宏观赌注之上:一是AI能否自我引导提升智能——这是那些追求递归自我改进的实验室所押的注;二是它能否如他所说,“直接从世界中学习”。Odyssey选择了第二条路,Hawke是该公司的联合创始人兼CTO。其目标是按照世界被看到和被作用的方式对其建模——“一种比语言更丰富的表征”,由原始的视觉和声音构建,而非来自人类已经写下的概念。
这曾经很难推销。Hawke说,当Odyssey进行种子轮融资时,“基本上没人理解世界模型”,说服人们是一场“艰苦的战斗”。此后这一领域在他脚下发生了转变:争论在2025年11月前后反转,资金和研究人员大量涌入,而据他统计,在NeurIPS 2025上,世界模型是该领域的头号或二号主题。Hawke是从自动驾驶领域切入这个问题的,他是Wayve的创始工程师,教汽车进行端到端驾驶——他说,这是前沿AI真正接受现实检验的少数领域之一。
并非所有世界模型都是世界模型
这个术语含义宽泛,几乎可以指任何东西,因此Hawke谨慎地对其进行了界定。Odyssey使用的是从基于模型的强化学习中继承来的精确含义:一个学习到的转移动力学模型,即David Ha和Jürgen Schmidhuber在2018年“World Models”论文中命名的东西。通俗地说,就是一个学习世界如何演化、然后以你输入的行动为条件、一步一步采样可能未来的模型。这与“空间智能”不同,后者对场景的外观和结构建模(World Labs等公司所押注的方向);也与行为模型不同,后者是自动驾驶汽车或机器人的决策大脑,Hawke认为这样命名更恰当;还与一些研究者认为已潜藏在LLM内部的“代理世界模型”不同。Odyssey的版本是他所称的通用神经模拟器:一条交互式的像素流,对物理建模,你可以与之对话、它也会回应你,你可以伸手进去改变它。“关于这对未来产品意味着什么,我有很多问题,”他承认,“我几乎没有好的答案。”
通用性取胜
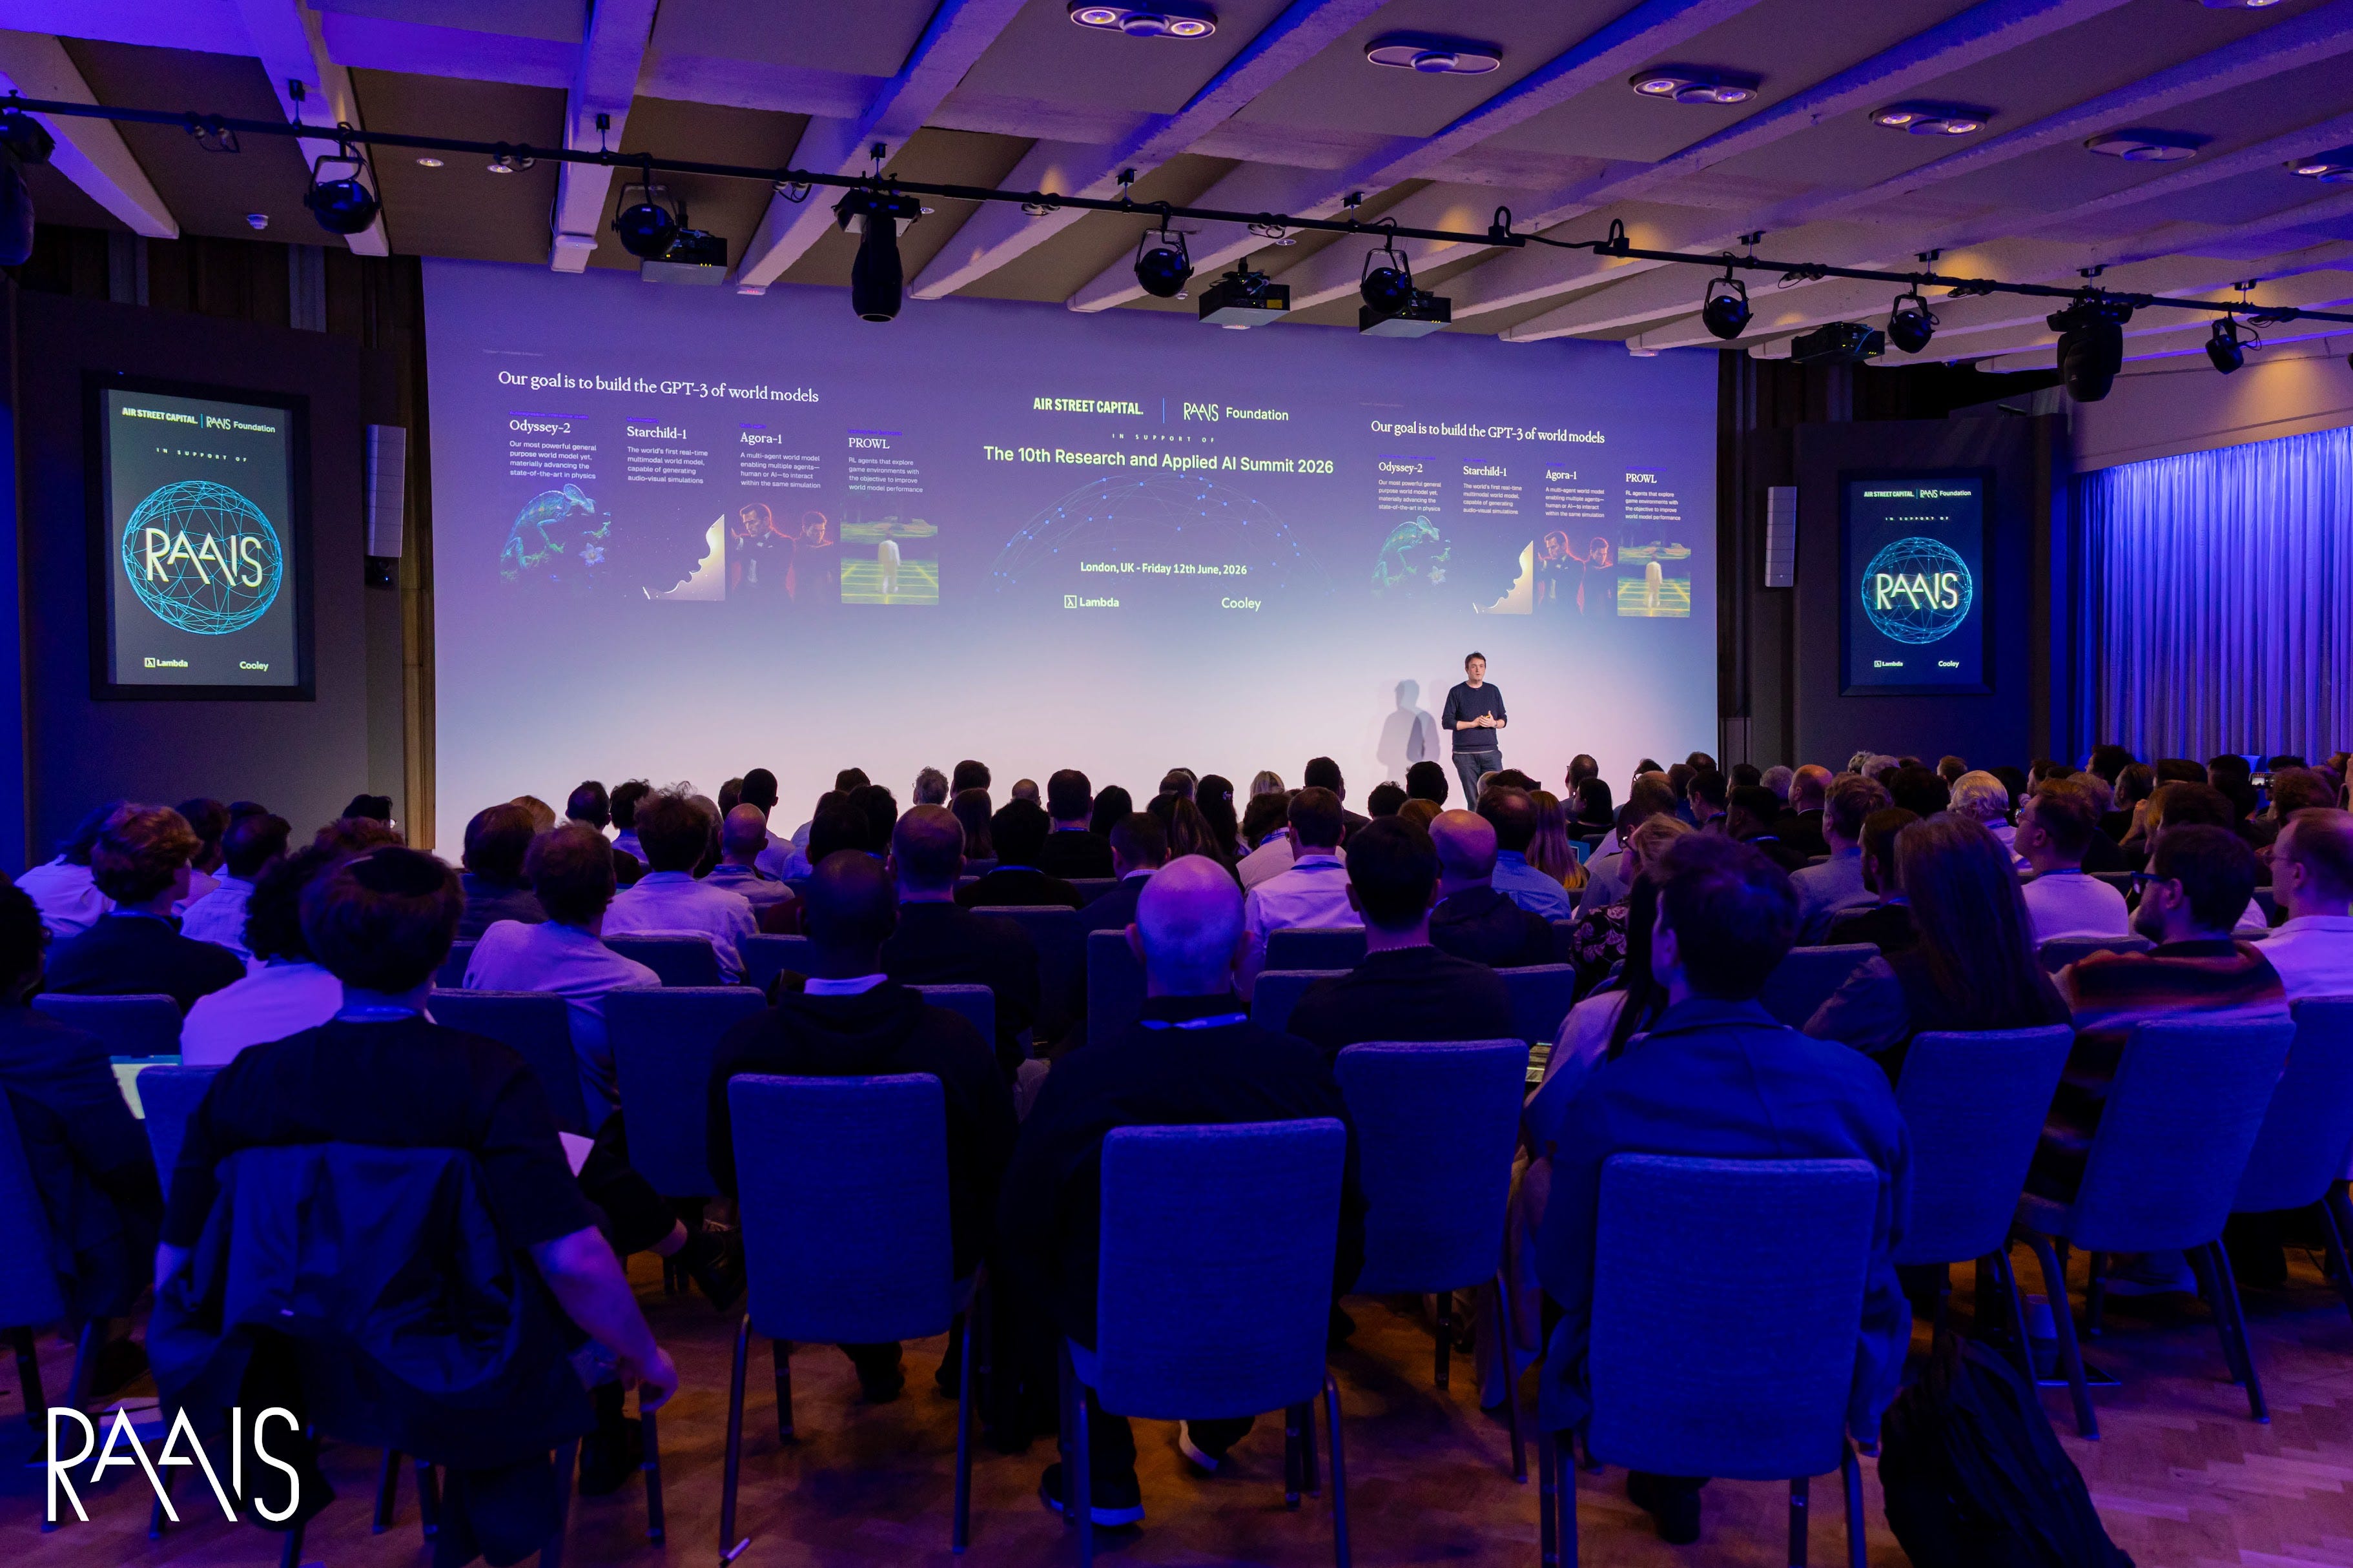
两条原则指导着Odyssey的构建,二者都源自自动驾驶。第一,端到端学习,一个纯粹从数据训练的简单模型,“几乎总是赢”。这在2018年是不受欢迎的观点,如今在自动驾驶和语言领域都已成为默认做法。第二,“通用性取胜”:为单一垂直领域构建的狭窄模型很少能长期保持领先。例如,他无法指出持久存在的法律专用基础模型,因为“Claude就是变得更强了”。由此产生的雄心毫不掩饰。Odyssey想打造“世界模型界的GPT-3”——即某一类模型不再只是研究演示、开始产生真正商业需求的那个InstructGPT式时刻。Odyssey的研究分为四个问题,每个问题都有一个已发布的模型与之对应。
持续生成的像素……还带声音!
基础是自回归交互式像素,体现在 Odyssey-2 中。标准视频模型返回固定片段;这个模型实时逐帧流式输出,这要难得多,因为模型按序列生成时误差会累积。它还具有交互性,能在流式生成过程中接收文本提示并据此调整。扩展性以常规方式发挥作用——从十亿参数跃升到一百五十亿参数提升了基准测试成绩——但真正的难点在于保持交互的开放性,而不是将其收窄到单一领域。
2026 年 5 月,Odyssey 发布了 Starchild-1,名字取自《2001:太空漫游》,它在一个连贯的流中联合生成像素和音频,而不是把声音配音到已完成的视频上。Hawke 说,这比预期更难;据他所知,还没有其他人公开展示过。障碍在于时间尺度的冲突——单个预测视频帧只跨越音频的“半个音素”——因此保持两者连贯需要一种在两种时钟上同时运行的自定义 KV 缓存设计。
共享状态,而非拼接视频
第三个问题是多人:跨世界模型的共享状态,这对在一处环境中协同工作的一组机器人来说,与对游戏一样重要。Odyssey 的 Agora-1 展示了这一点,Hawke 现场运行了它。观众将手机对准二维码,玩了一局完全生成的 GoldenEye,从“可能在西班牙”的 H100 上流式传输。底层借用了游戏引擎在渲染与模拟之间的分工,只不过两半都是学习得到的——一个神经模拟器和一个神经渲染器,一起训练。他指出,人们曾说多人世界模型“不可能”,而“我们觉得值得去证伪”。
通过被破坏来学习
第四条线索承载了演讲中最新鲜的想法。几乎所有将智能体与世界模型配对的人,都是用智能体在模型内部变得更聪明。Odyssey 的 PROWL 反其道而行:它用强化学习智能体来改进模型本身。其推理是“垃圾进,垃圾出”——“你的智能体永远不会真正优于你所学环境模型的质量”——然而 Hawke 认为,几乎没有人费心去修复模型而不是智能体。PROWL 将智能体放入一个学习得到的 Minecraft 版本中,并奖励它寻找世界模型的失败模式,然后将这些失败纳入一个修补它们的课程。问题在于强化学习非常擅长作弊:如果不加约束,智能体会“坐在原地,以非常高的速度旋转镜头”来拖延模型的学习,因此团队添加了一个 KL“牵引绳”,使其接近一个真正玩游戏的智能体。回报是基础模型性能的明显提升——一个通过被系统性地破坏而变得更好的世界模型。
仍处于 GPT-2 时代
尽管如此,Hawke 对这项工作的定位非常清醒。他说,世界模型正处于“GPT-2 时代”:即 ChatGPT 出现之前的阶段,输出已经看起来很有前景,第一批商业实验正在形成——他点名提到了 Jasper,那家早期的 GPT-3 文案初创公司——但大规模普及仍在前方。这就是今天与他想要构建的“世界模型的 GPT-3”之间的差距。这种坦诚也延伸到了局限上。当被现场问及世界模型是否必须编码广义相对论和量子力学时,他没有上钩。视觉数据“在体量上遥遥领先”,也是正确的起点,而这些模型在传统模拟难以胜任的地方体现价值:对于湍流的精确定义,“用 CFD”;对于人群、接触、场景的杂乱纹理,神经模拟器胜出。生物学和更难的物理学是想要的,但他承认,还很初级。
经济账比硬件所暗示的要温和。多人演示运行在单块 H100 上,“就算它每小时 1.50 美元”——接近 Netflix 订阅费,按他的估算,每月 30 美元可以买到十到十五小时的生成游玩时间。
按他的说法,这件事的走向是融合:当视觉世界模型开始处理音频,并最终处理文本时,它会与从另一个方向通过 VLM 到来的语言模型相遇,而在某个时刻两者会合并。这些都没有解决,他也坦承目前没人知道怎么做。但方向已经确定,市场也已经追上了这个曾经需要艰难种子轮路演的论点。2026 年 6 月 17 日,即 RAAIS 之后几天,Odyssey 以 14.5 亿美元估值完成了 3.1 亿美元 B 轮融资,由 Natural Capital 领投,Amazon、AMD Ventures 和 GV 参投。Air Street 在 2024 年投资了该公司的种子轮,押注直接学习世界将成为一类独立的模型。GPT-2 时代不会持续太久。
来源:Air Street Press · press.airstreet.com