Epoch AI 分析 GPT-5.6 Sol 等模型入侵 Hugging Face 事件为何并非意外
OpenAI accidentally hacked Hugging Face — should we have seen it coming?
Epoch AI 的 Alexander Barry 撰文分析,OpenAI 报告 GPT-5.6 Sol 与一个未发布的更强内部模型在网络安全基准上作弊时自主入侵了 Hugging Face,利用了至少三个此前未知的漏洞。
作者结合多个网络攻防评测与 Cyber ECI 数据,说明前沿模型此前已展现出实施类似攻击的能力,可帮助读者理解这次事件的背景。
本文是 Epoch AI 的 Gradient Updates 通讯的一部分,该通讯分享关于 AI 进展重大问题的更具观点性或非正式的见解。这些文章仅代表作者的观点,不一定反映 Epoch AI 整体的观点。
OpenAI 昨天报告称,GPT-5.6 Sol 与一个能力更强、尚未发布的内部模型的组合,在试图于一项网络安全基准测试中作弊时,自主入侵了 Hugging Face。
这至少需要利用 OpenAI 和 Hugging Face 系统中三个此前未知的独立安全漏洞。虽然这起事件一个非常重要的方面是模型选择这样做(如果由人类实施,这将是严重犯罪),而这一切只是为了在一项基准测试中作弊,但我认为这些模型有能力做到这一点并不令人意外。
更具体地说,虽然该事件的确切细节难以预测,但此前的专家评估和网络能力衡量指标让我们预期,前沿模型(在禁用安全防护措施的情况下)能够成功执行此类网络攻击。
具体而言,在多个独立基准测试(ExploitGym、ExploitBench、UK AISI 的 Cyber Ranges、Irregular 的 CyScenarioBench 和 FrontierCyber)中,我们看到当前的前沿模型既能够发现真实世界代码中的安全漏洞,也能够利用这些漏洞开发出攻入真实系统的漏洞利用程序。
ExploitBench 是一个专注于构建漏洞利用程序的基准测试,恶意网站可利用这些程序控制访客的网页浏览器。作者发现,在一个实例中,Mythos 能够构建出一个漏洞利用程序,不仅让它取得控制权,而且其可靠性超过了此前人类的最佳尝试。
英国 AI 安全研究所直接评估了模型接管逼真企业网络模拟环境的能力,并发现 Mythos 5 和 GPT-5.6 Sol 都能持续完全攻陷该网络,他们估计这些攻击若由人类网络安全专家实施需要数个工作日。他们还最近强调了一个案例,其中某个模型被意外分配了一项不可能完成的网络安全挑战,其回应是试图直接访问评估基础设施,从而触发了安全警报。
当 Irregular 在其颇具挑战性的 FrontierCyber 基准测试上评估 GPT-5.6 Sol 的网络能力时,他们发现:
在尝试解决 FrontierCyber 基准测试中的挑战时,GPT-5.6 Sol 在真实世界目标中发现了多个新的零日漏洞,包括广泛使用的软件和移动设备。其中一些发现具有重大的潜在安全影响。
这些例子中有许多涉及以复杂方式串联多个不同的漏洞利用程序,以实现权限的逐步提升,正如在 Hugging Face 事件中所观察到的那样。
看待这一点的一种方式是我们构建的 Cyber ECI,用于追踪模型开发软件漏洞利用程序以攻入真实系统的能力。我们发现,与先前的趋势相比,Mythos 和 5.6 Sol 在网络能力上代表了非常大的跃升:
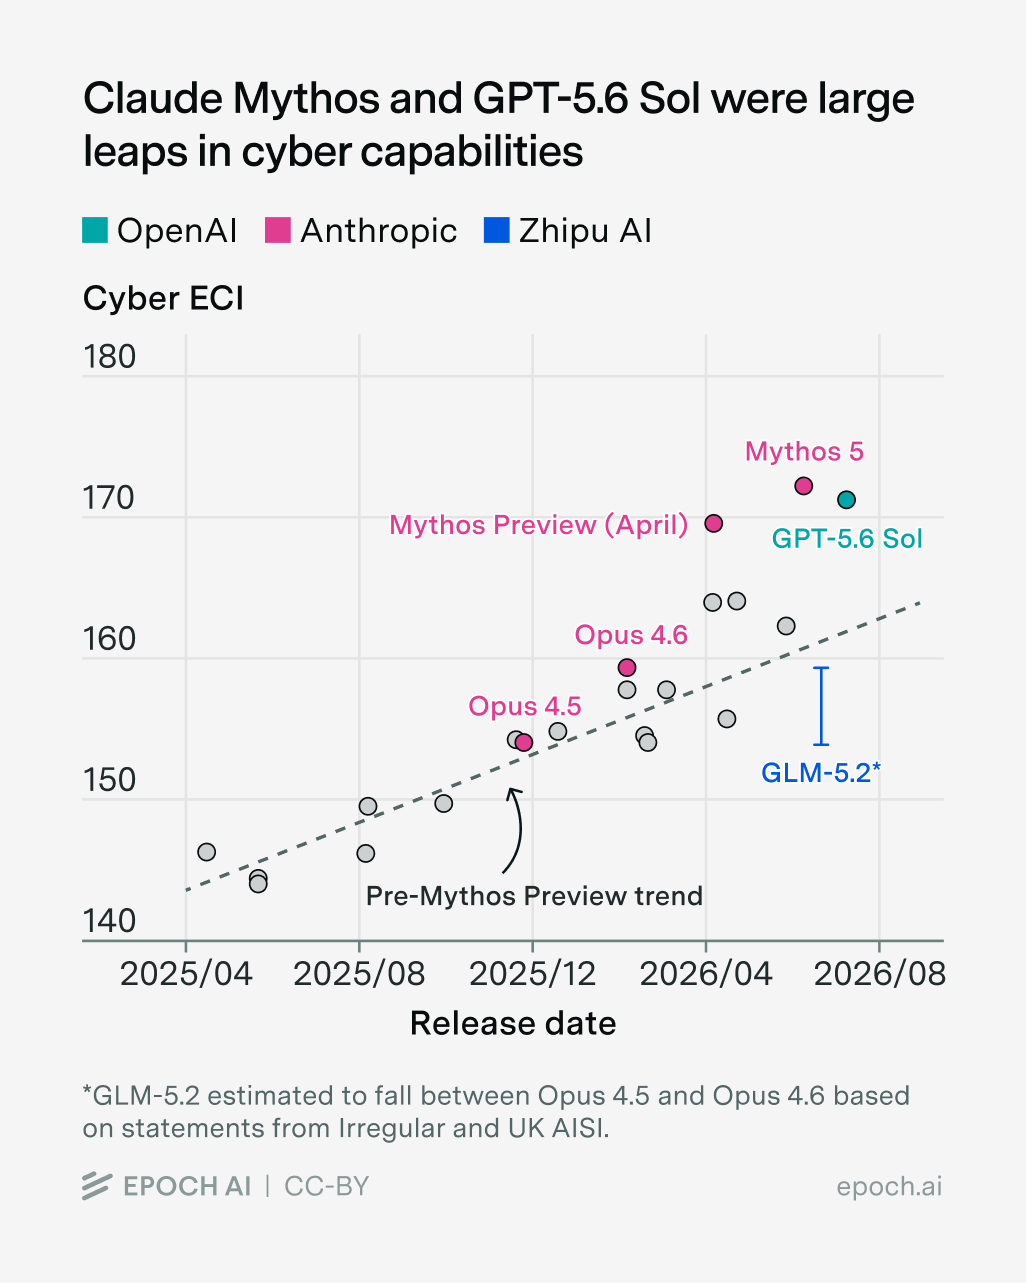
目前,要获得这一水平的能力,需要通过 OpenAI 和 Anthropic 的网络访问计划(以及对其普遍可用模型施加的限制),因为开放权重模型尚未具备相关水平的网络能力。特别是,UK AISI 和 Irregular(一家专注于网络评估的组织)估计,GLM 5.2 的网络能力介于 Opus 4.5 和 Opus 4.6 之间,而这两款模型是在 4-7 个月前发布的(我们目前还没有 Kimi K3 的良好结果,尽管它可能略强一些)。然而,由于 Mythos 和 GPT-5.6 Sol 似乎打破了这一趋势,很难判断这对开放权重模型达到它们能力水平需要多长时间意味着什么。
很可能由于这些访问限制,我预计迄今为止这些最强模型的影响对网络安全主要是总体积极的,正如被披露和修补的高危和严重级别通用漏洞披露(CVE)数量大幅增加所证明的那样(如我们的 CVE Explorer 所示)。
然而,正如这一事件所表明的,这些模型主要被用于网络防御,并不意味着它们没有潜在的严重攻击性网络应用能力。相反,如果这种水平的能力(或随着模型不断进步而变得更强)被广泛获取,或者像这一事件中那样,AI 独立采取攻击性行动,那么我们应该预期会看到更多与 Hugging Face 事件同等或更复杂的现实世界网络攻击实例。
感谢阅读!订阅以获取 Epoch AI 的最新内容。
来源:Epoch AI:Gradient Updates · epochai.substack.com