Black Forest Labs 发布 FLUX 3,从视频生成延伸到机器人控制
FLUX 3: from video generation to robot control
Black Forest Labs 发布多模态基础模型 FLUX 3,单一架构内联合学习图像、视频和音频,可单次生成最长 20 秒带音频视频,其初步人偏好评测中优于 Runway Gen-4.5(77%)和 Grok Imagine Video(69%)。
原文把 FLUX 3 的多模态训练与其在工业机械臂上的控制实验串联起来,并给出冻结骨干的消融数据,可帮助读者理解视频表征迁移到机器人操作这条路线。
在奥迪的生产实验室里,一条机械臂将电子控制单元嵌入紧密贴合的固定装置中。当抓取失败时,它会自我纠正,再次抓取并完成任务。这条机械臂及其控制栈来自 mimic,一家总部位于苏黎世的机器人公司,正在为工业操作构建视频-动作模型。系统的核心是视频生成器的骨干:FLUX 3,来自 Black Forest Labs 的全新多模态基础模型。
FLUX 3 经过训练,用于预测场景如何演变。要做到这一点,它必须学习并表征物体如何持续存在、材料如何形变,以及当一个物体与另一个物体接触时会发生什么。FLUX-mimic 测试这些内部表征是否也能在现实世界中支持机器人控制。
Air Street 投资组合公司 Black Forest Labs 于上周发布了 FLUX 3。该模型在单一架构内联合学习图像、视频和音频。每种模态都提供其他模态所缺乏的信息:图像捕捉空间结构,视频增加时间与运动,音频有助于定位诸如语音和撞击之类的事件。BFL 正在将同一底层模型扩展到动作预测,并通过选定的研究和商业合作伙伴提供。
mimic 同期发布了 FLUX-mimic。该系统将 FLUX 3 的视频骨干与 mimic 的机器人操作数据、动作解码器、硬件和部署栈相结合。FLUX 3 Video 现已开放早期访问,图像生成和编辑将随后推出,动作预测将通过选定的合作伙伴提供,同时还计划推出开放权重的多模态骨干。该模型系列将为 BFL 迄今为止超过五亿次下载的开放权重记录增添更多深度。
一个模型,统摄视觉、声音与动作
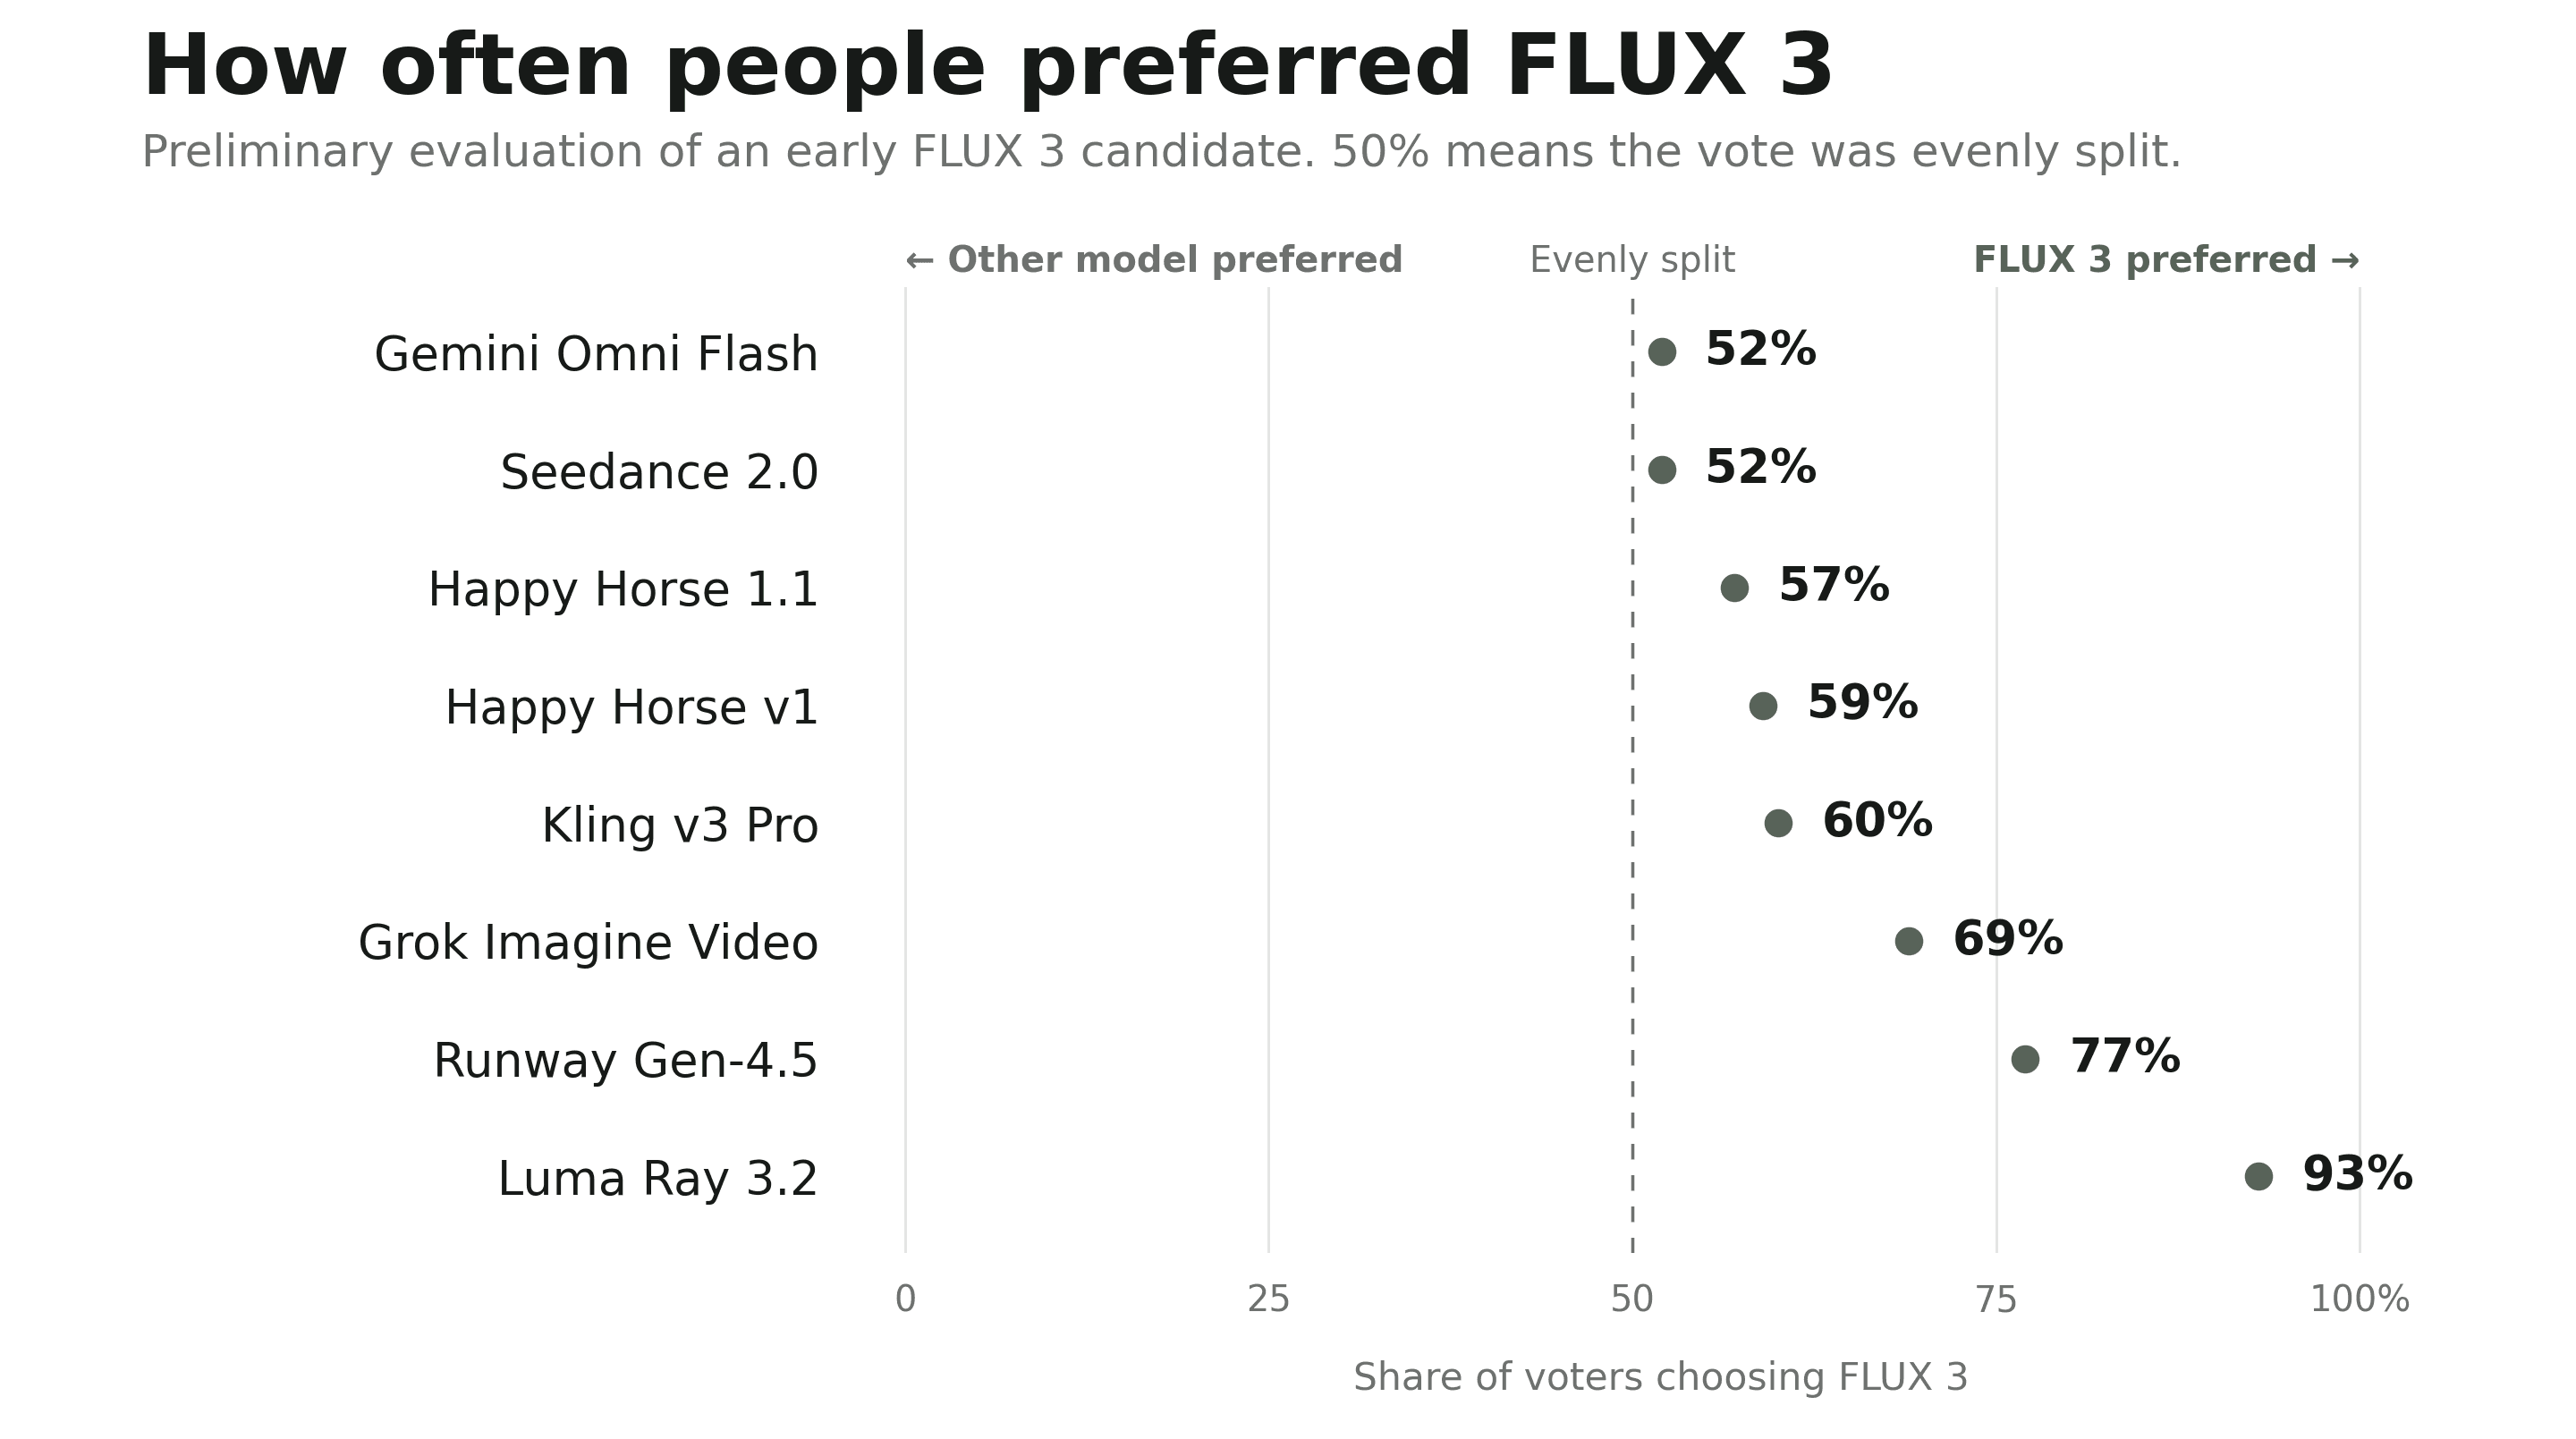
新的视频模型通常通过成对人类偏好测试来评估:评分者观看由同一提示词生成的两段视频,并选择他们更喜欢的一段。在 BFL 对带音频的 10 秒、720p 文本到视频片段的初步评估中,FLUX 3 在 77% 的对比中优于 Runway Gen-4.5,对 Grok Imagine Video 最高达 69%,与最强系统的差距则更小:对 Kling v3 Pro 为 60%,对 Seedance 2.0 和 Gemini Omni Flash 为 52%。
该模型可在单次生成中产出最长 20 秒的带音频视频。它可基于文本、图像或视频工作;在多镜头序列中保持角色和其他视觉参考;渲染排版文字;并生成多种语言的同步对话。
生成一段令人信服的视频需要对场景的内部描述。物体离开画面后必须持续存在。线缆必须在手握处弯曲。零件卡入外壳的声音应与掉落地面的声音不同,且声音必须与可见的撞击同时发生。联合训练让每种模态约束其他模态:
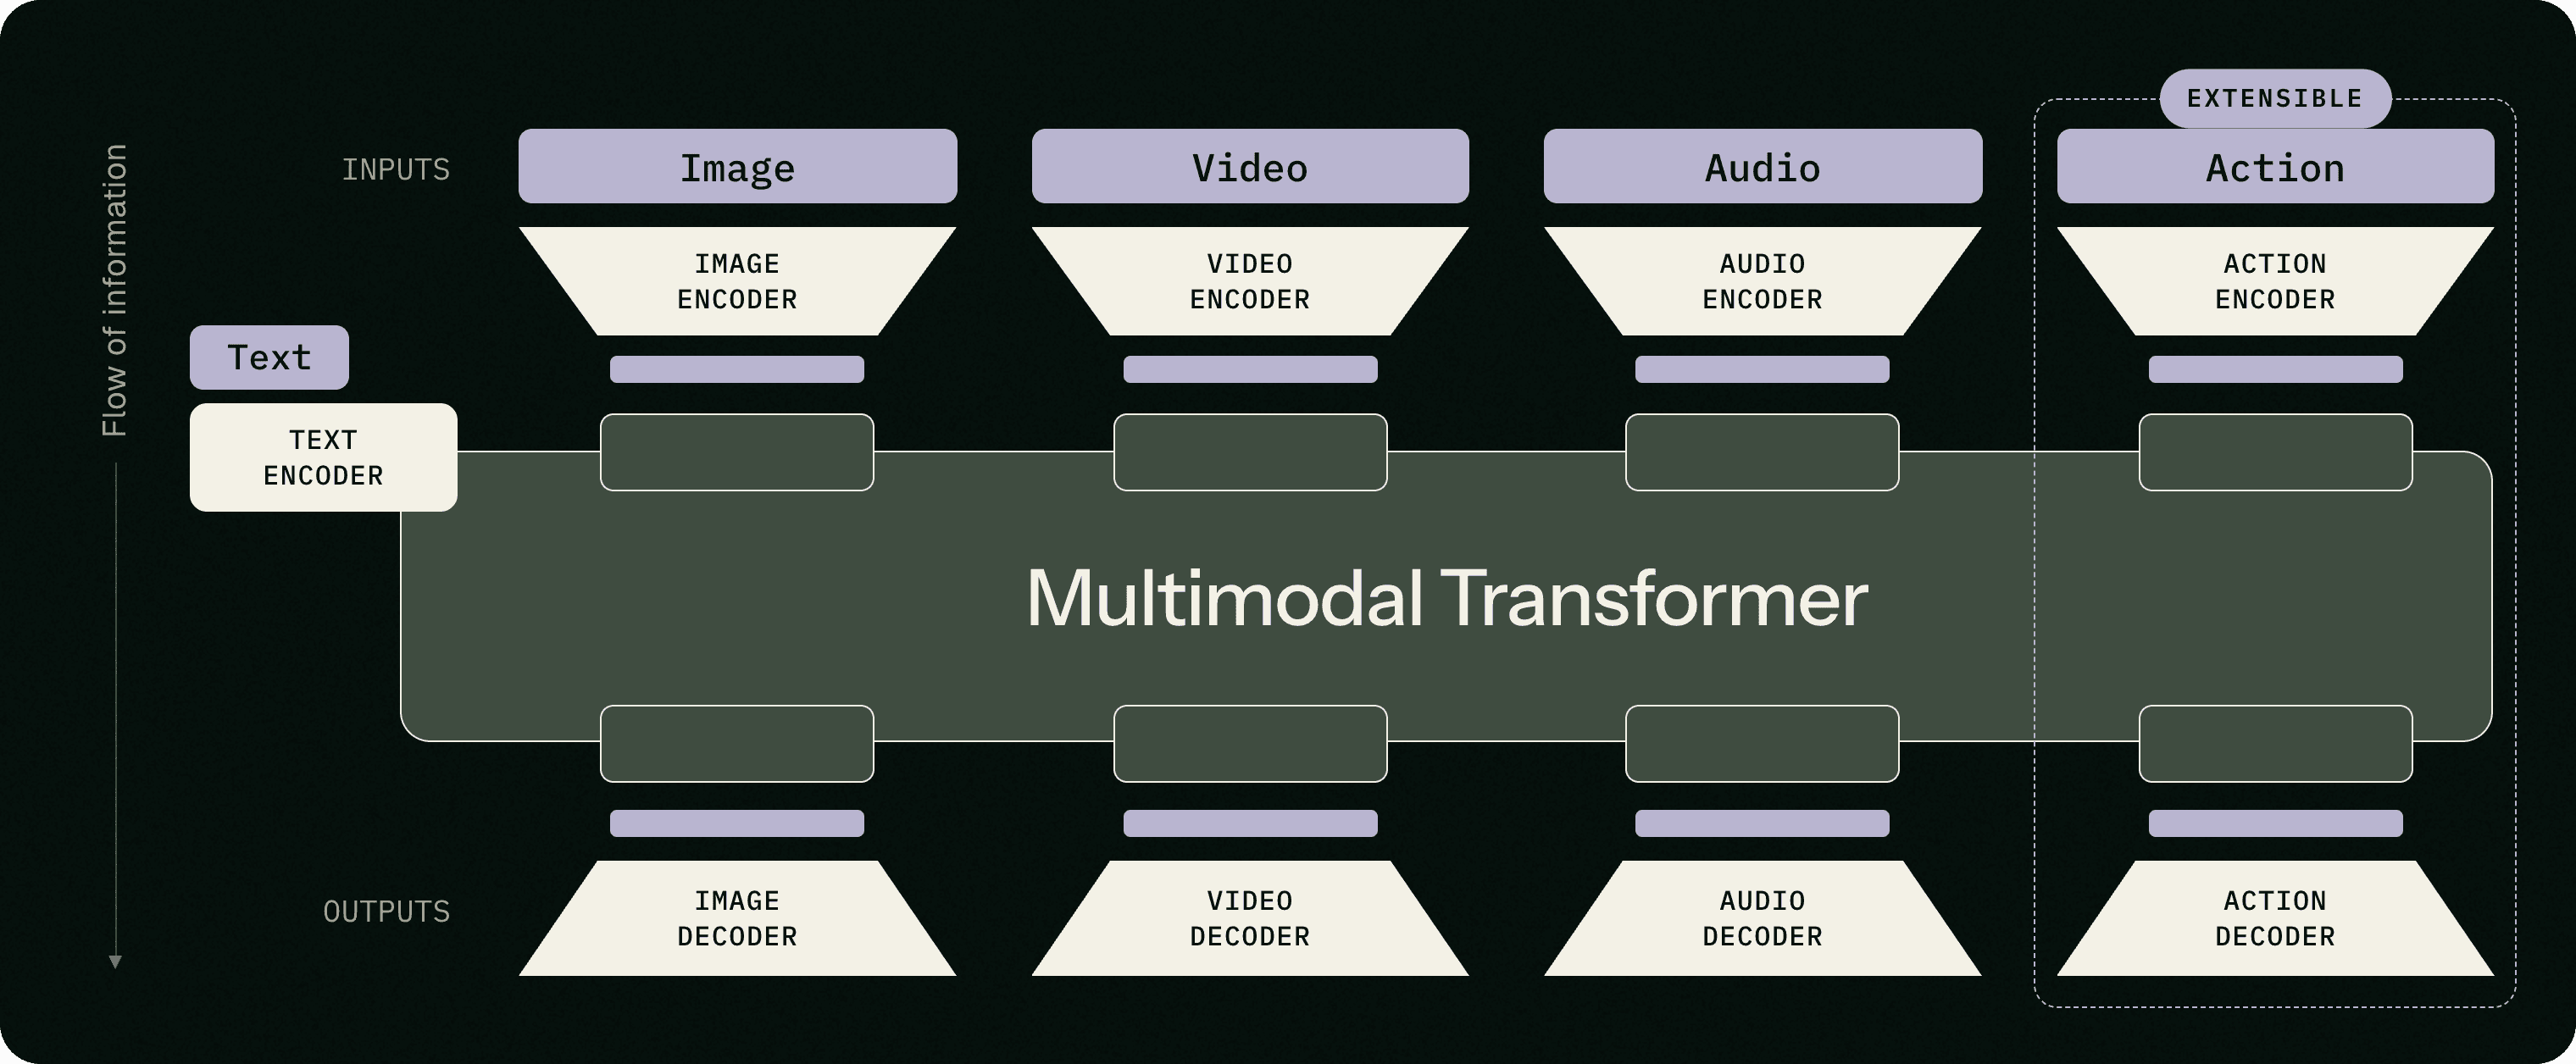
BFL 在数千万小时的通用视频上训练了 FLUX 3,其中包括数十万小时专注于人类和机器人操作的视频。生成质量提供了模型所学内容的一个视角。机器人实验则测试这些知识是否足够可及,以指导动作。
从预测到行动
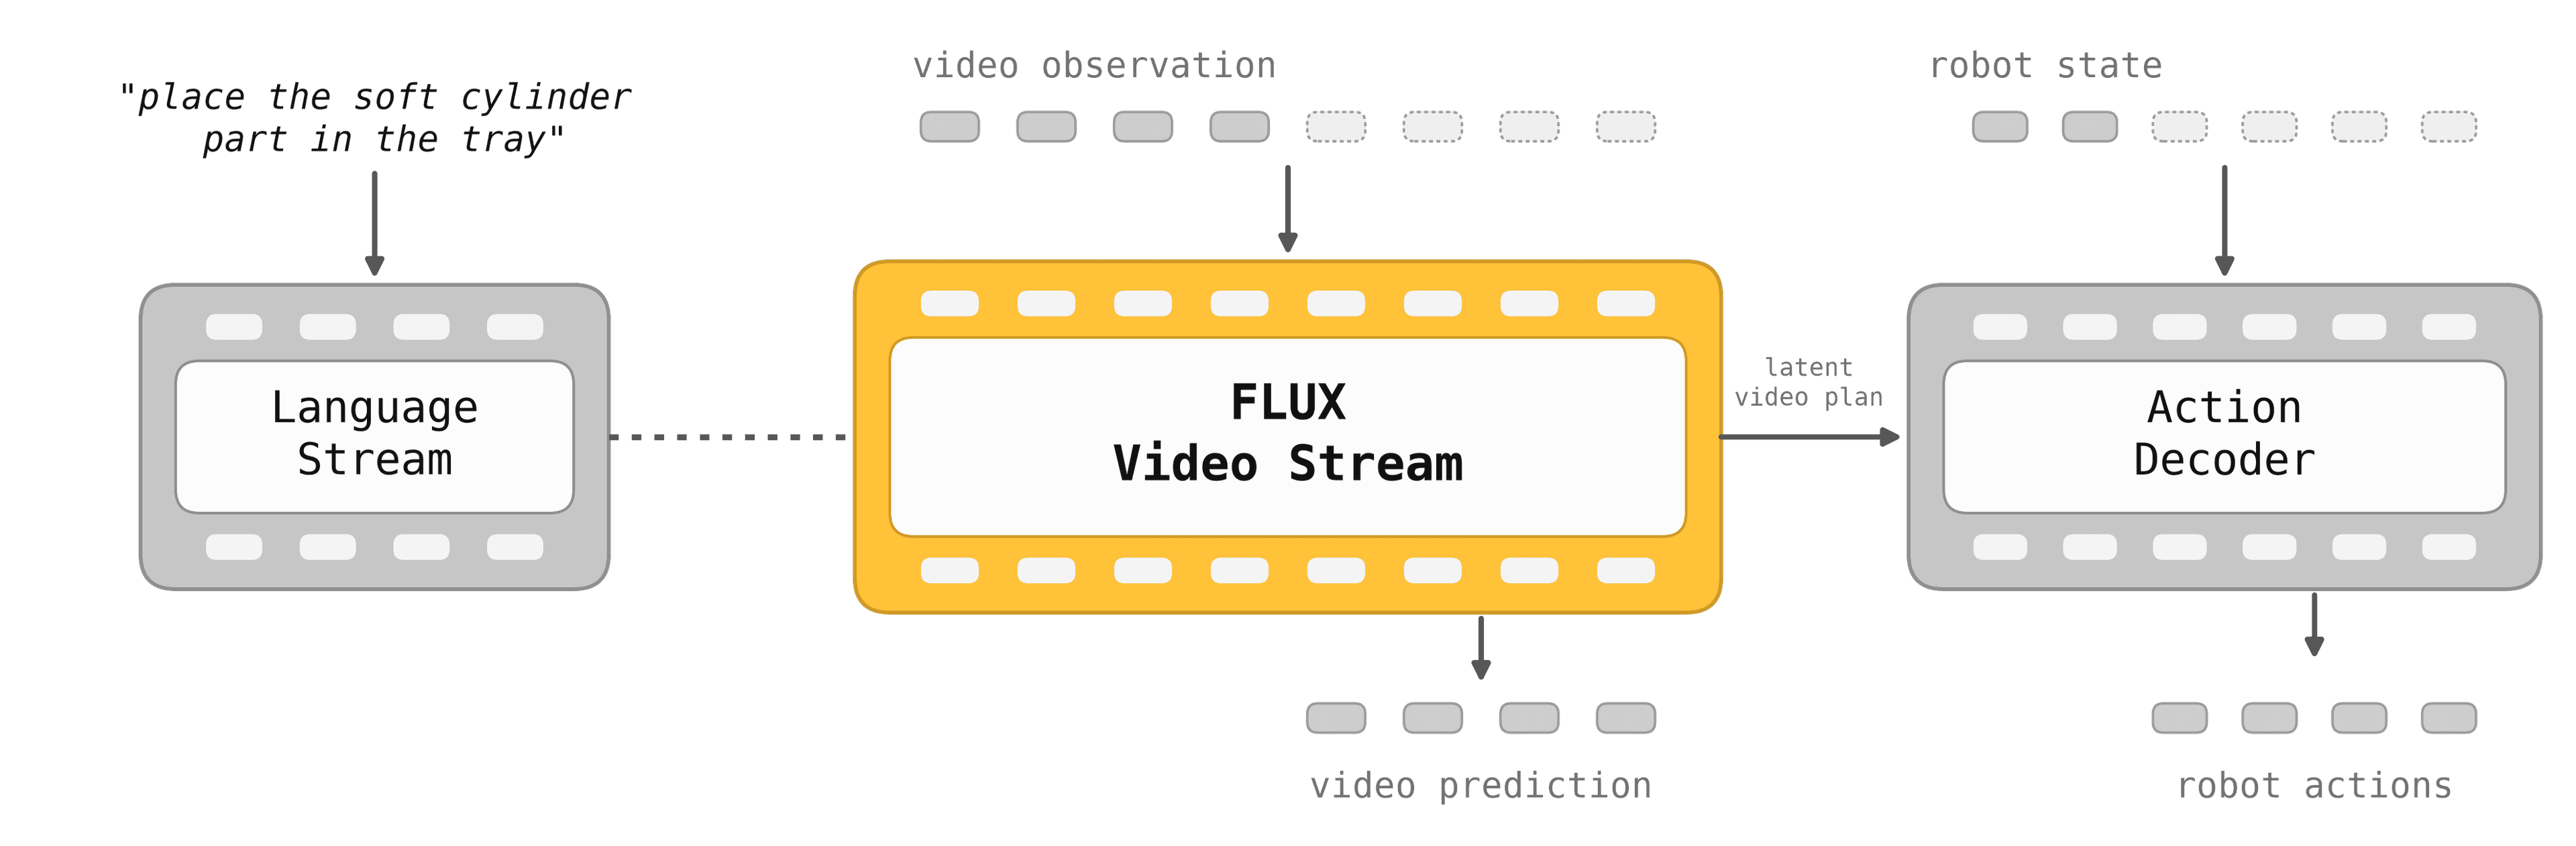
FLUX-mimic 在从 FLUX 3 视频预测路径提取的中间特征上放置了一个轻量级动作解码器。主干网络形成对场景将如何演变的预期,而解码器将该表示转换为机器人动作块。它在推理时从不生成视频,因此一个动作块只需通过主干网络进行一次前向传播,而不是完整的视频推演。
mimic 在一项使用真实机器人的软体套件装配任务上对预览版本进行了基准测试。该公司报告称,在无需单任务微调或后训练的情况下成功率达到 95%,而基于相同数据混合训练的适配版 π0.5 模型为 55%,在该任务上经过大量后训练的流匹配策略为 70%。
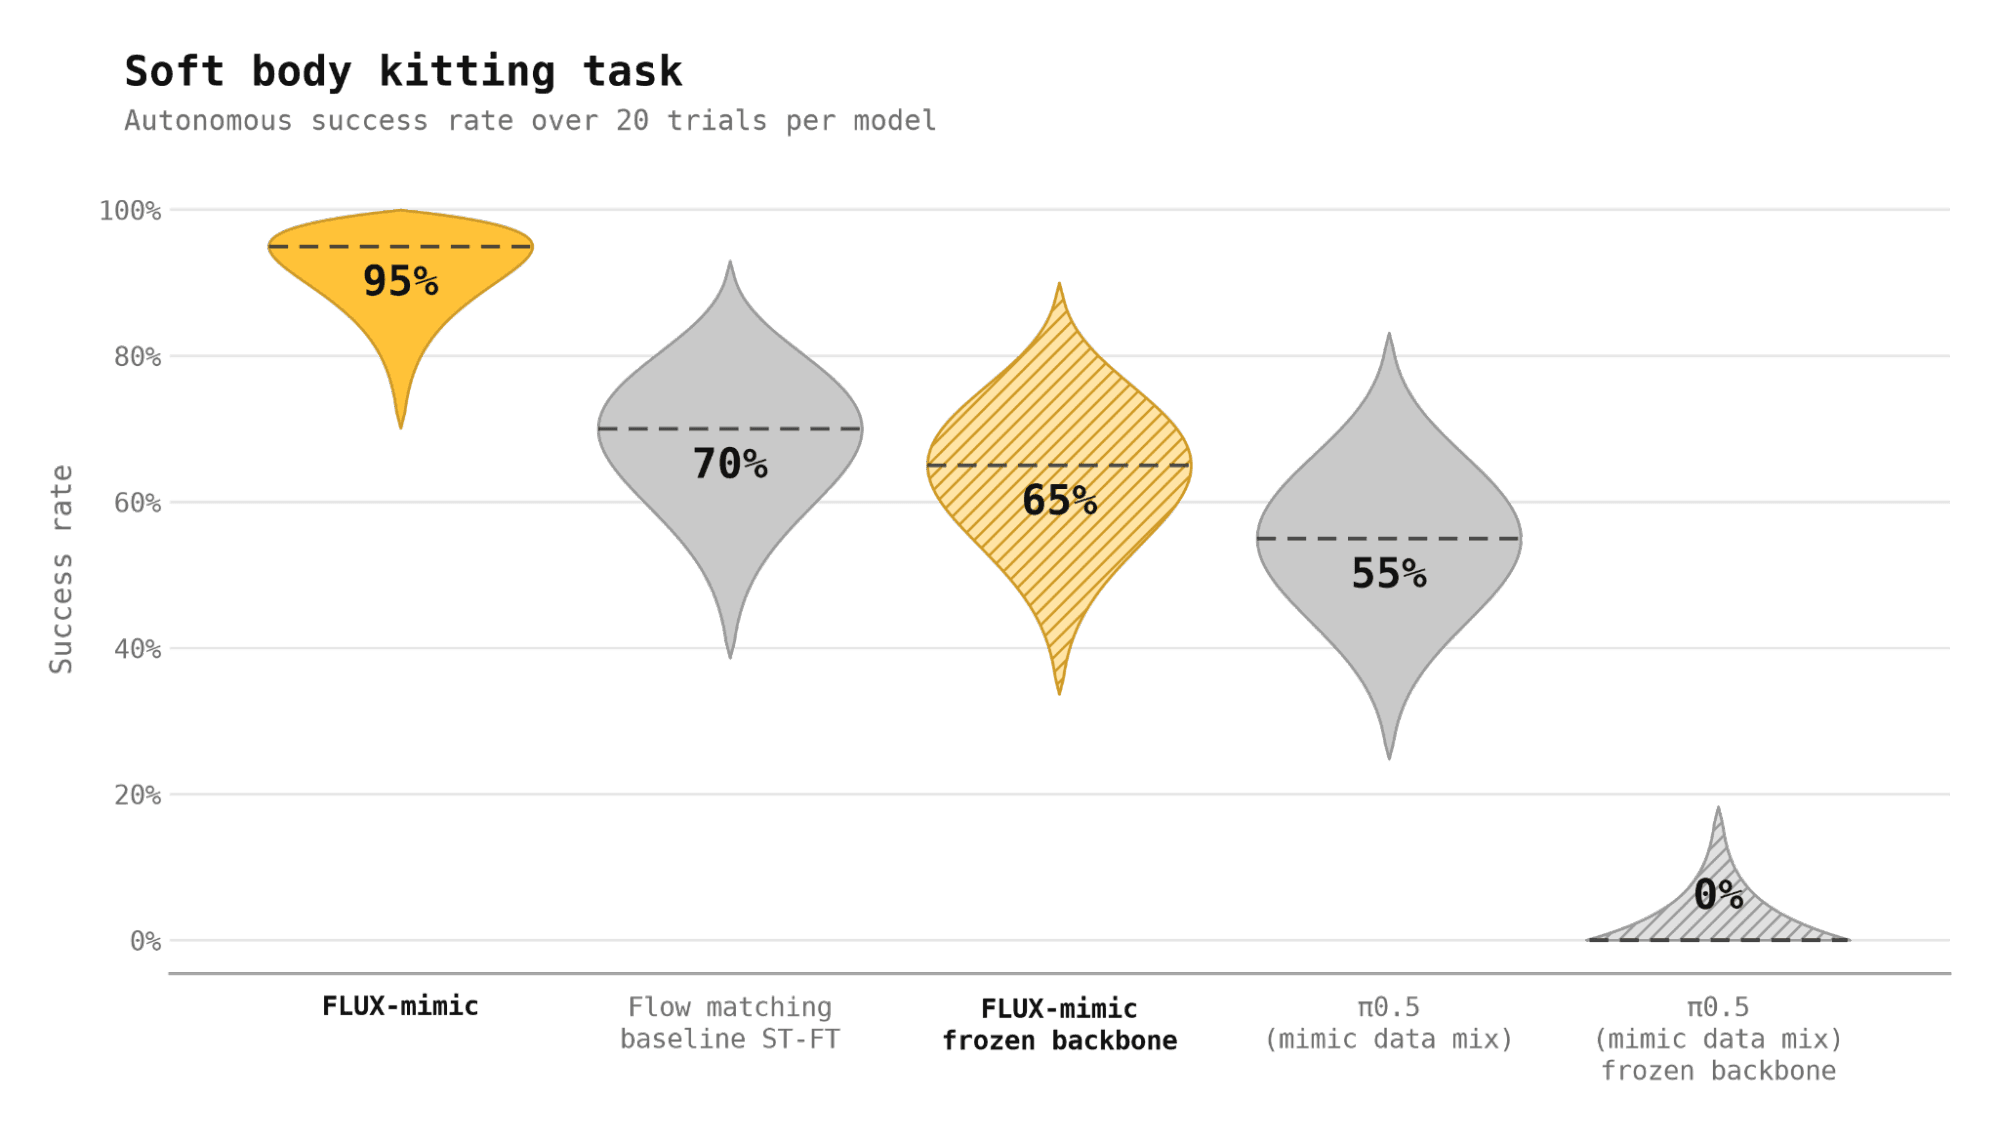
一项单独的消融实验更能揭示表示本身。在 FLUX 主干网络冻结的情况下,FLUX-mimic 仍保持竞争力,而 π0.5 动作解码器没有记录到任何成功的任务完成。结果表明,关于操作的有用信息在预训练视频主干网络被适配到特定任务之前就已经存在。
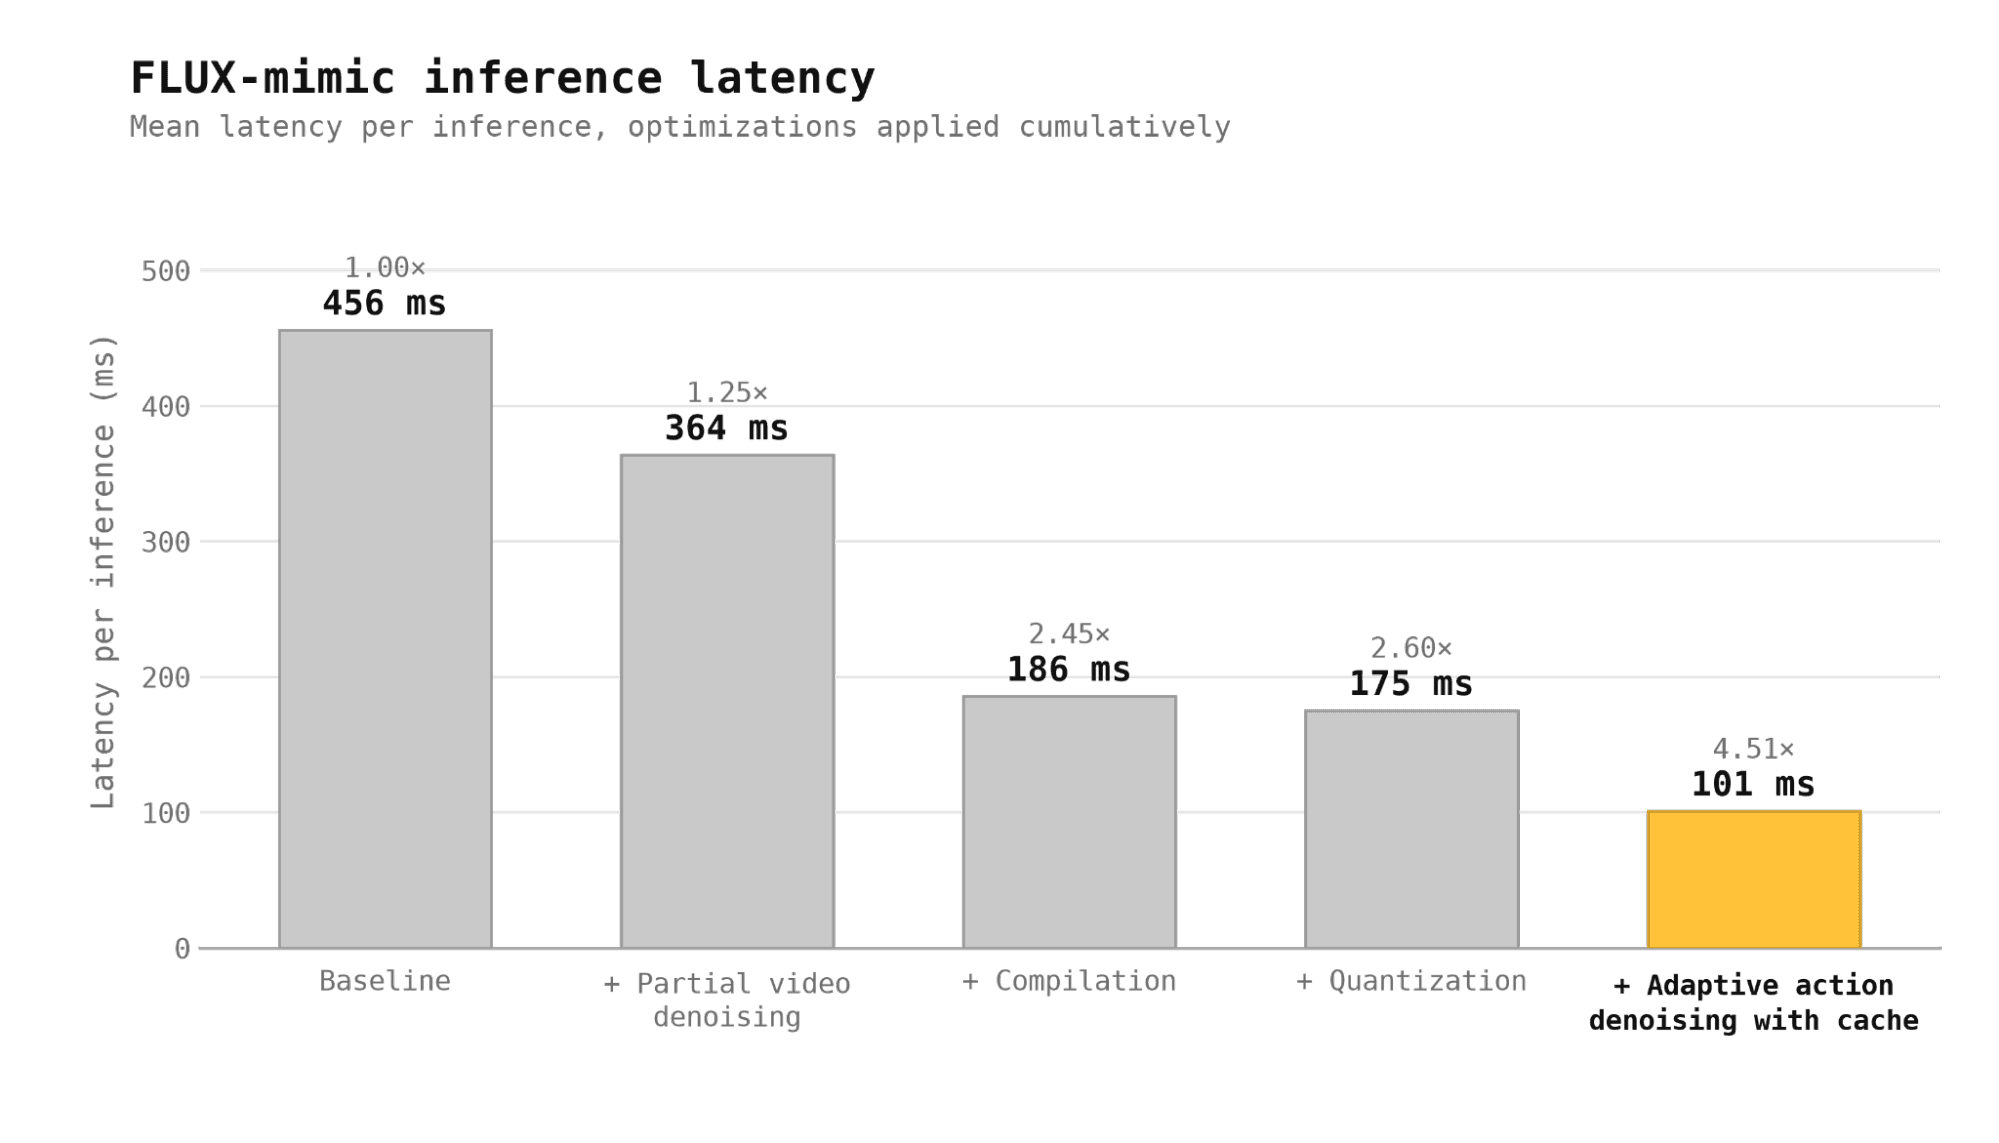
该系统还必须响应足够快,以控制物理机器。BFL 表示,FLUX-mimic 主干网络经过优化,可在单块 NVIDIA RTX 5090 上在不到 80 毫秒内完成从输入到内部表示的处理。对动作解码器、传感器、模型与执行器之间的进程间路径,以及将预测与执行重叠的实时分块的进一步优化,使整个系统的反应时间降至 101 毫秒。
Audi Production Lab 一直在真实生产用例中测试和部署该系统。这些用例包括将零件装入结构化托盘、将电子元件插入紧密配合的固定装置、组装组件,以及操作密封件和电缆等柔性材料,mimic 将其描述为传统自动化从未能够处理的材料。
“我们已经看到这些机器人解决了复杂的软体操作工作,而这用传统机器人技术根本不可能实现,”Audi Production Lab 的 Christoph Schneider 表示。
通往物理智能之路
老读者会认出这个论点。当 Odyssey 上个月完成 3.1 亿美元 B 轮融资时,我们写道,机器智能的下一个进步可能来自那些构建世界、在其中行动并学习现实如何运作的系统。FLUX-mimic 将这一论点带到了工厂车间:通过视频生成学习到的表示正被用于控制执行工业操作的机器人。
我们从 Air Street 新投资机会的流动中看到了另一面。仅今年一年,我们见过的二十多家机器人公司中,有一半在构建操作策略,而且它们大多收敛于相同的 VLA 式架构。但差异归根结底在于数据。遥操作演示需要逐任务采集,速度慢、成本高,而且当任务变化时迁移效果很差。一个已经编码了物体行为方式的骨干网络改变了小团队需要付出的代价:世界知识来自已经存在的视频,而演示预算则花在最后一公里上。这正是冻结骨干网络成果的亮点所在,而开放权重意味着它可以赋能整个机器人开发者生态。
FLUX 3 Video 现已开放早期访问。图像生成与编辑将随后推出,同时还有面向动作预测的合作伙伴访问权限,以及多模态骨干网络的开放权重版本。
来源:Air Street Press · press.airstreet.com