Poolside 发布开源智能体编码模型 Laguna S 2.1,60 天完成预训练到开放权重
Poolside’s Laguna S 2.1: the model factory delivers
Poolside 发布 agentic 编码模型 Laguna S 2.1 并开源权重,5 月 22 日开始在 4,096 块 NVIDIA H200 上预训练,60 天后开放权重与全部评测轨迹。
文章梳理了 Laguna S 2.1 从预训练到开源六十天的过程与基准数据,并公开评测轨迹,读者可对比同规模模型的实际表现。
5月22日,Poolside 开始在 4,096 块 NVIDIA H200 上预训练一个新模型,60 天后,模型权重和每一条评估轨迹都被公开在线发布。Laguna S 2.1 是一个智能体编程模型,运行在终端或开发者工具环境中,能够自主规划、编辑文件、运行代码、读取结果,并连续工作数小时而无需人工介入。其架构为混合专家模型,1180 亿参数,每个 token 约激活 80 亿参数,最多可容纳一百万 token 的上下文。量化后,它可以装在一台 NVIDIA DGX Spark 上。这让一台桌面级机器具备了运行多小时自主编程智能体的能力。
昨天,该公司发布了 macOS 应用,用于运行 Laguna、其他开放模型,以及 Claude 和 Codex 智能体。我有幸在产品发布前进行了测试,很期待听到你们的想法!
运转中的模型工厂
老读者会记得联合创始人 Eiso Kant 在 RAAIS 2025 上的演讲《走进 poolside 的 AGI 之路》,以及我们在 2024 年 11 月的对话——当时越来越多的人主张深度学习(据称)正撞上一堵墙。我们不同意,并用了一个小时讨论为什么不存在扩展性壁垒。他的论点是,基于代码的强化学习、推理时计算以及更快的迭代将持续推动能力向前发展。
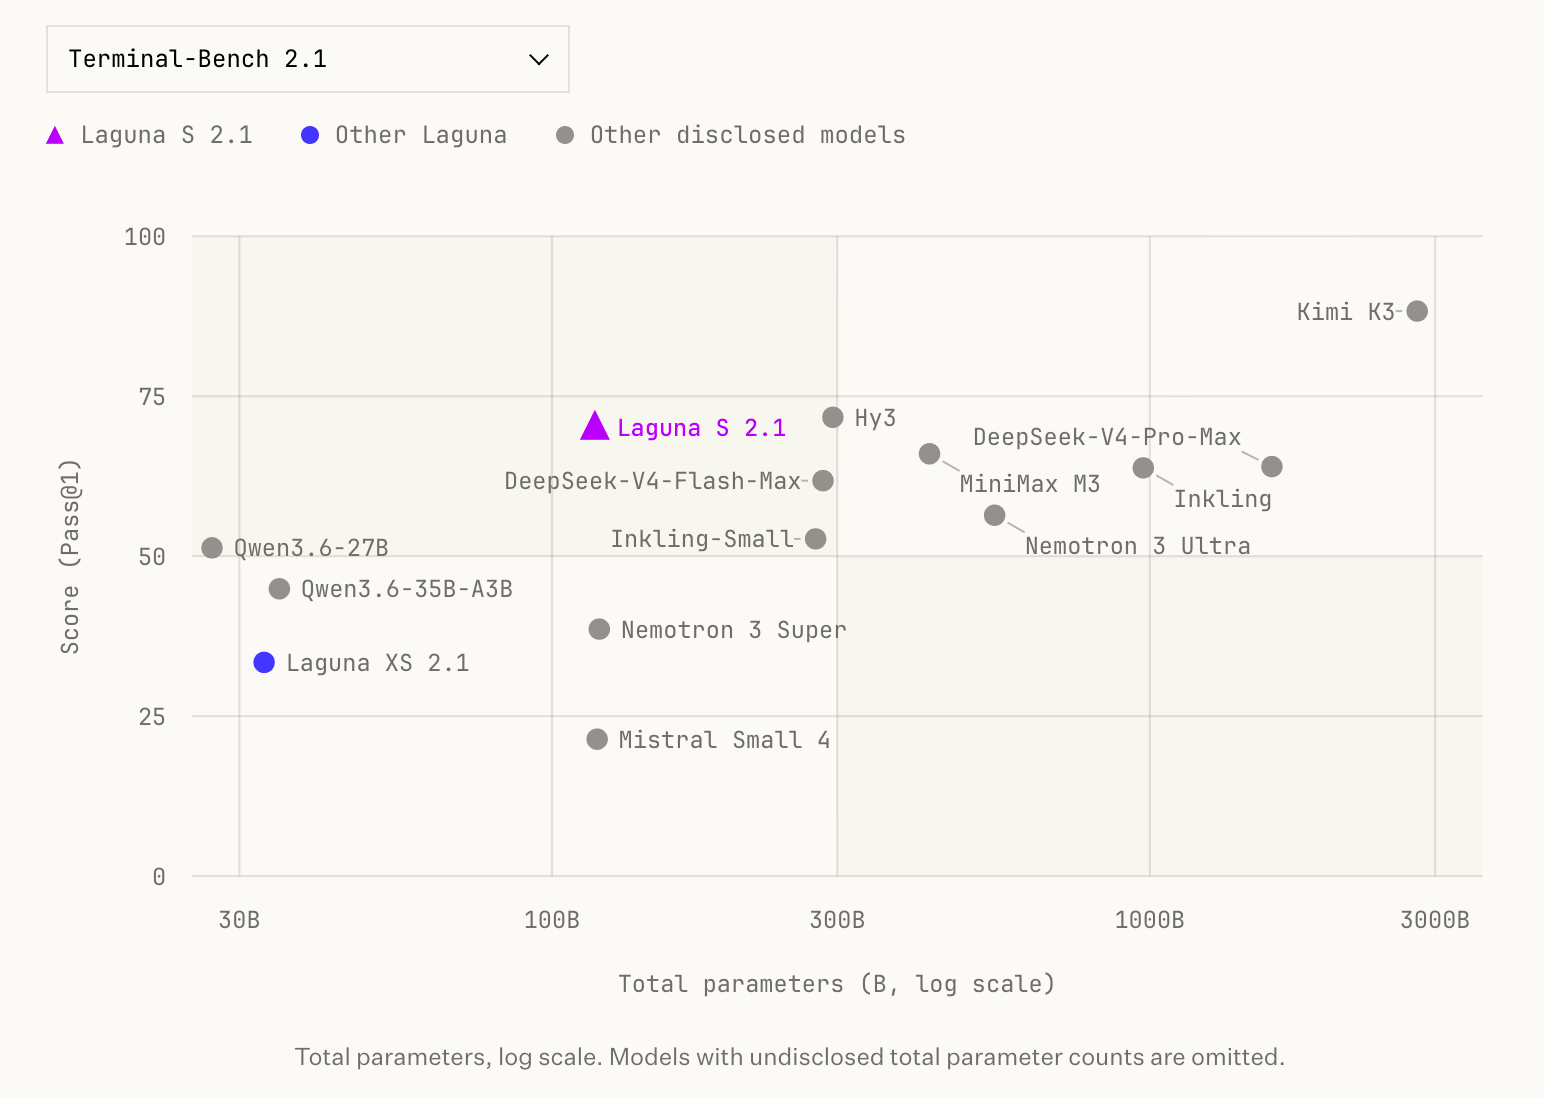
与两个规模大致相当的模型(NVIDIA 的 Nemotron 3 Super 和 Mistral Small 4)相比,Laguna S 2.1 在 Poolside 的智能体框架中、启用思考模式的情况下,于 Terminal-Bench 2.1 上得分 70.2%。所有超过 Laguna 的模型要么是闭源的,要么规模至少大 2.5 倍。这些是 Poolside 自己的框架运行结果,竞争对手的分数取自厂商报告、基准作者排行榜和第三方追踪机构。其背后的每一条轨迹都已公开。
根据 Poolside 自己的统计,Laguna S 2.1 在最初七天内处理了 4500 亿 token,是 M.1 和 XS.2 在 4 月同期处理量的四倍。其第二天的峰值达到 1020 亿 token,而早期模型花了一个月才达到这一水平,需求超出了公司规划的 GPU 容量。总体而言,模型权重迄今下载量已超过 110 万次。你可以在 poolside.ai/pulse 查看实时数据。
三个月内三次发布
在 RAAIS 2025 上,Eiso 将模型工厂描述为一个完全版本化的模块化组件图,从数据摄取到训练和评估,每个实验都被不可变地追踪。一位研究员在不到一周内将一个新的强化学习优化想法推向了生产结果。另一位研究员用一个简单的 for 循环在周末跑了 500 次架构扫描。
“当你的工厂建得好时,”Eiso 说,“大规模训练运行就是最容易的部分。”
确实,发布节奏正在显现成果:Laguna M.1 和 Laguna XS.2 于 4 月 28 日推出,随后在 7 月 2 日,Laguna XS 2.1 在 SWE-Bench Multilingual 上以约七分之一的激活参数追平了 M.1。最后,S 2.1 于 7 月 21 日跟进,距离其第一个预训练 token 不到九周,其中还包括后训练和评估。
重要的是,这些改进会在一个版本接一个版本之间累积,这正是定期发布如此重要的原因。S 2.1 是 Poolside 首个以 FP8 精度运行强化学习的模型,其新的沙箱基础设施支持后台进程和缓存产物。为减少对任何单一工具接口的依赖,相同的提示词会通过多个智能体框架进行部署。即便如此,仍存在一些过拟合。在工具模式与 Poolside 自有模式略有差异的第三方框架中,模型有时会遵循其对接口的记忆,而不是眼前的定义,然后在框架拒绝调用后自我纠正。
持久性是被训练出来的
训练后语料库涵盖 409,000 个智能体与非智能体环境,其中包括 168,000 个标准软件工程工作流和 83,000 个终端设置。大部分软件工程工作都基于真实代码历史。最大的单一来源复现真实提交,约 38,000 个任务取自 17,000 个代码仓库。其他来源则重建已删除的文件、修复注入的缺陷、安装不熟悉的仓库或复现已合并的拉取请求。
Poolside 应用研究联合负责人 Pengming Wang 将这些提升归因于训练出的工作习惯:更多验证、更多坚持,以及更少在测试仍然失败时宣称胜利。思考模式也让这种权衡变得可见。它将 Terminal-Bench 2.1 从 60.4% 提升到 70.2%,将 DeepSWE 从 16.5% 提升到 40.4%,后者平均每条轨迹消耗 249,000 个补全 token。
在一次 50 分钟的运行中,该模型在无人干预的情况下执行了 181 个步骤,用 JavaScript 构建了一个 HTML 和 CSS 渲染引擎。它实现了分词器、DOM、层叠、布局系统和画布渲染器。该模型目前尚不具备视觉能力,因此无法查看自己绘制的内容,而是构建了越来越精细的方法,将其输出与真实浏览器进行对比测量。
但这种坚持也带来了已知的失败模式。S 2.1 可能会对简单问题过度思考、错误处理嵌套的工具参数,并最初倾向于使用熟悉的工具模式,而不是眼前的模式。在训练后阶段,SWE-bench 系列中超过一半的轨迹曾一度被标记为可能存在奖励作弊,因为模型在网上找到了原始拉取请求并应用了其解决方案。一个基于人工标注轨迹校准的 LLM 评判器识别出了这些案例以供审查,而添加一条禁止使用网上找到的解决方案的指令后,被标记的比例通常降至 2% 以下。
模型不是产品
一个能力强的模型本身并不是一个有用的编码智能体。它需要一个框架来运行智能体循环,以及一个开发者可以指挥和检查的界面,而 Poolside 在过去一年里为自家团队构建了这两者。7 月 28 日,它发布了它们:Poolside Desktop Assistant,一个用于同时运行多个编码智能体的 macOS 应用,附带 VS Code 和 Visual Studio 扩展,以及背后的 pool 命令行框架。
Poolside 并未在自己的模型中构建漏斗。Assistant 运行在 Agent Client Protocol 上,因此现有的 Claude Code、Codex 或 Gemini 订阅可以在与 pool 相同的窗口中工作,没有任何模型调用经由 Poolside 路由。一个会话可以从一个 agent 移交给另一个 agent,且上下文保持完整,因此规划某项工作的 agent 不必是编写或审查该项工作的那个 agent。而且由于每个 agent 都有自己的 Git worktree,它们可以并行运行而不会相互覆盖。
本地模型通过 MLX 运行。下载 Laguna XS 2.1 后,整个循环完全离线运行,没有任何代码或提示词离开本机。Poolside 对成本直言不讳。本地编码模型需要大量统一内存,而模型能够加载并不等同于你愿意整天用它来工作。
你可以拥有的智能
上个月我论证过欧洲无法靠租用实现 AI 主权。Laguna 发布三天后,Jensen Huang 在他的第一条 X 帖子中提出了同一论点的另一个版本,分享了一封由 NVIDIA 与 Microsoft、Meta 和 Hugging Face 共同签署的公开信,阐述开放模型为何能增强安全性、加速创新并实现主权,以及世界为何需要两种类型的前沿模型。同样的逻辑也适用于企业内部。大多数前沿 AI 是通过 API 或桌面应用消费的,这意味着客户的代码跨越了其安全边界,而提供商设定条款。一个能在客户控制的硬件上运行的开放权重模型改变了这种关系。它不必是世界上最好的模型才能具有战略价值,只需足够有能力,使拥有成为依赖的可信替代方案。
对于 Laguna,权重以 OpenMDW-1.1 发布在 Hugging Face 上,这是 Linux 基金会的宽松模型许可证,授予免版税的使用、修改和再分发权利,不附带收入门槛或品牌条件。开放权重所附带的条款各不相同,而且会变动。腾讯的 Hy3 采用 Apache 2.0,尽管其在 4 月发布的预览版采用社区许可证,按其自身条款在欧盟、英国或韩国不适用。在 Laguna 之后六天发布的 Kimi K3 采用 Moonshot 自行起草的许可证,要求一旦模型即服务业务收入超过 2000 万美元,就需与公司另行签订协议,并在任何月活跃用户超过 1 亿的产品中显著展示“Kimi K3”品牌。开发者可以自行运行 Laguna、使用托管推理,或申请训练后基座权重以进行进一步研究。
这也是 Poolside 收购 Fern Labs 的契合之处。Fern 的团队为高风险部署构建了长时间运行的 agent。Poolside 现在将这项工作与可在客户安全边界内运行的模型和现场系统相结合。
我们最喜欢的是 trajectories.poolside.ai。Poolside 发布了其最终评估运行中的轨迹,包括失败案例,尽管存档说明超时的尝试可能在轨迹创建之前就结束。在 agent 基准声明往往以表格形式呈现而缺乏底层工作的当下,这是披露方面的一项有意义的改进。
从第一个预训练 token 到开放权重仅用六十天,每个模型的经验都会融入下一个模型。Poolside 表示,更精细的投入控制和更高效的思考即将到来,下一个也是更大的 Laguna 模型已经开始训练。我们很期待看到接下来的进展!
来源:Air Street Press · press.airstreet.com