Moonshot AI 发布 Kimi K3,以高端定位冲击全球前沿模型
🌝Moonshot AI’s High-Stakes Bet: Inside Kimi K3 and the Shift in Chinese AI Strategy
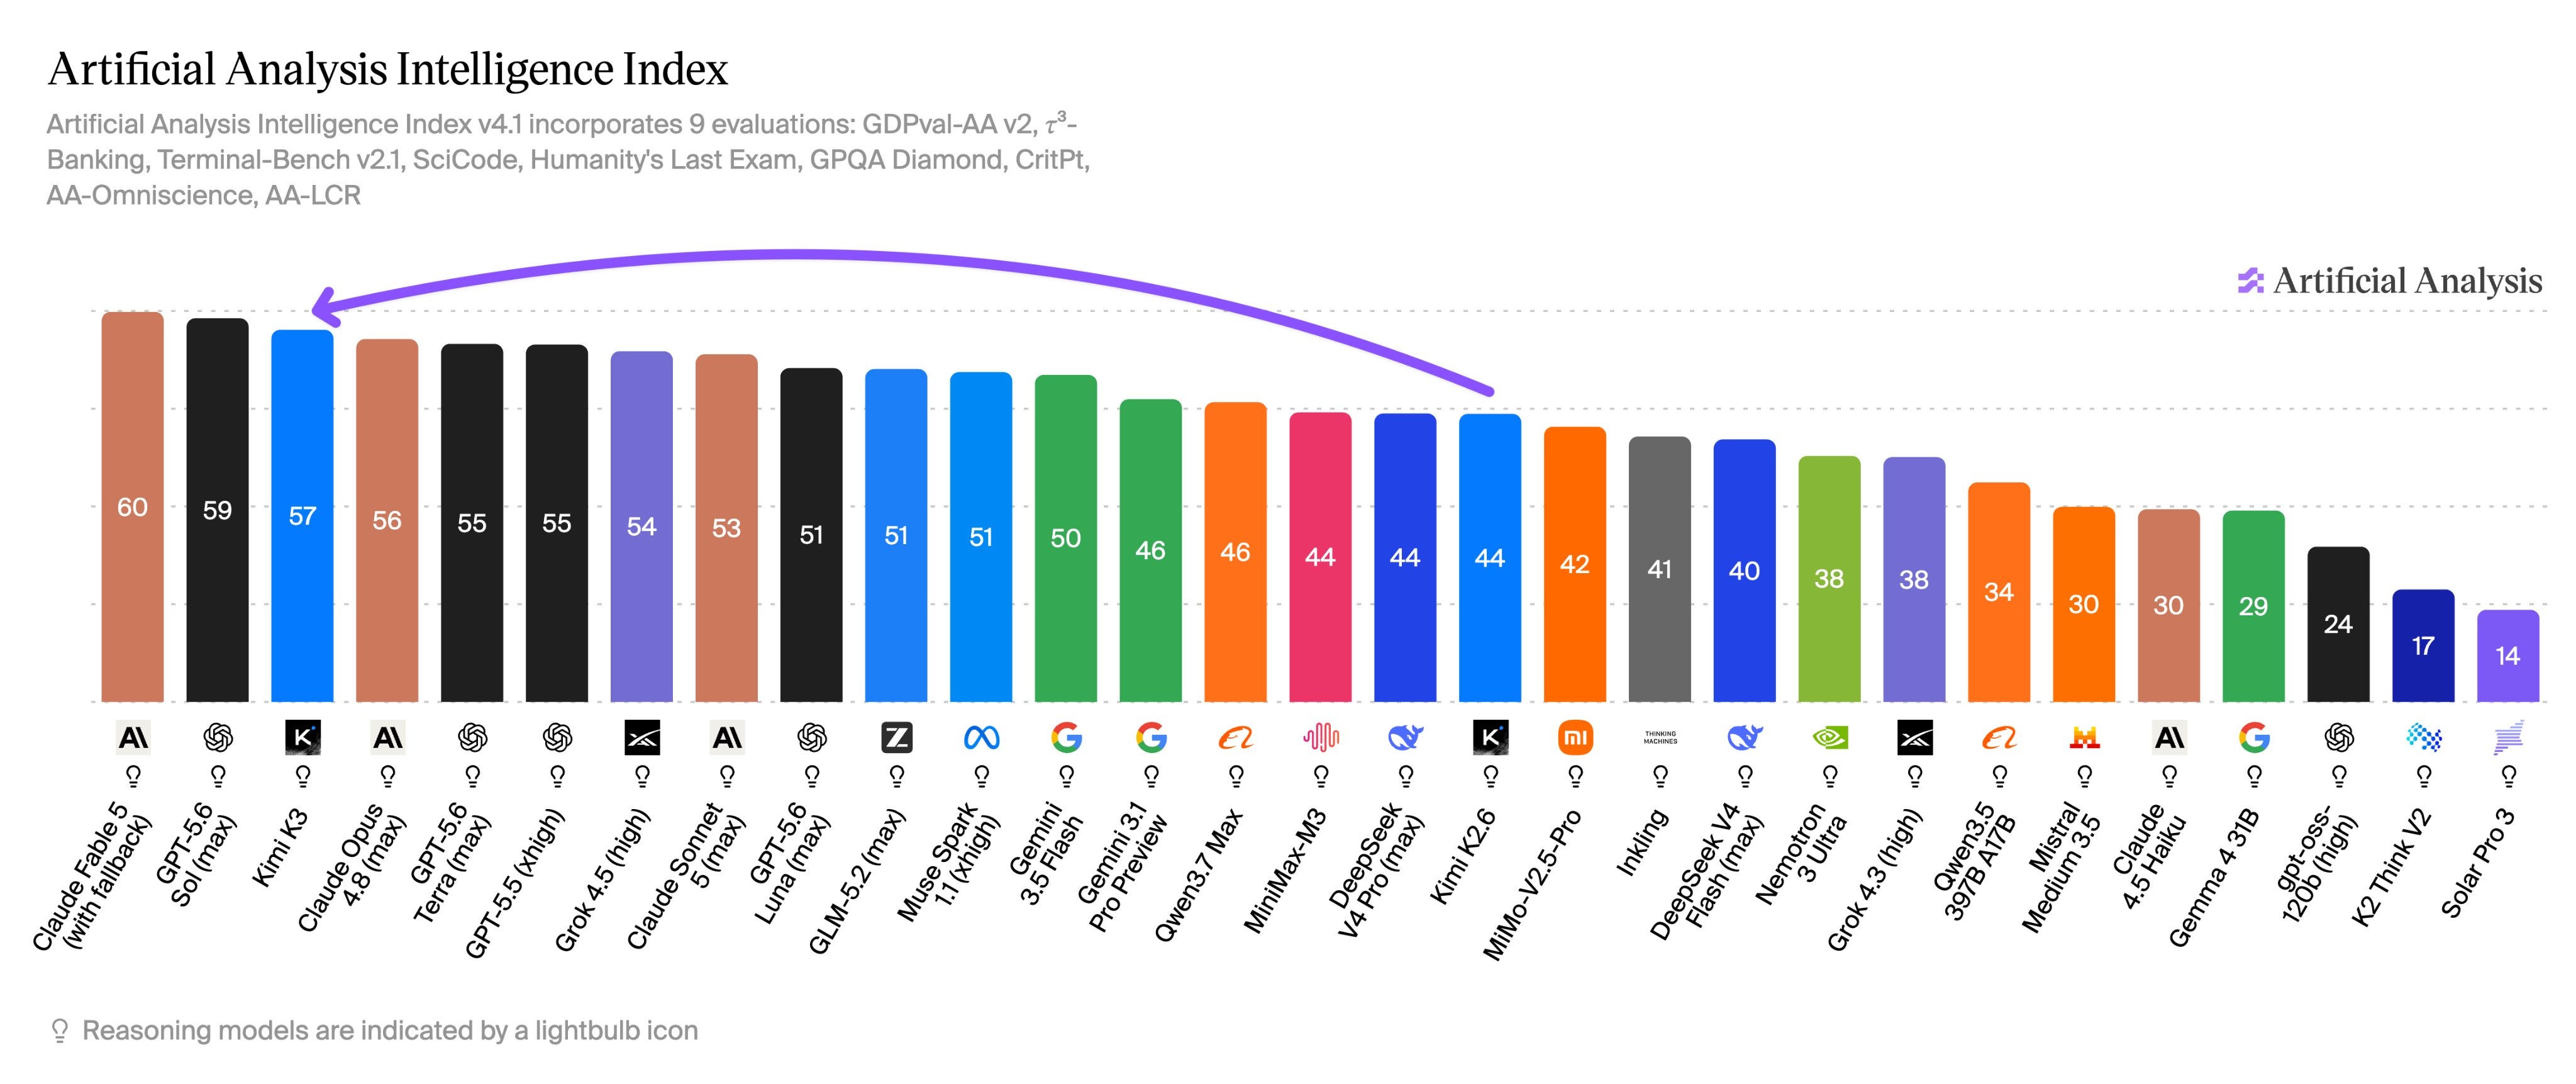
Moonshot AI 于 7 月 16 日发布旗舰模型 Kimi K3,2.8 万亿参数,以 1679 分登顶 LMArena Frontend Code Arena,成为首个在该榜超越 Claude Fable 5 和 GPT-5.6 Sol 的开源权重模型,在 Artificial Analysis Intelligence Index 排名第 3(约 57 分)。
作者从架构、定价和定位三个层面拆解 K3,指出它是中国首个以能力而非价格竞争的开源旗舰模型。
总部位于北京的 Moonshot AI 于 7 月 16 日发布了 Kimi K3,这是其迄今为止最强大的旗舰模型。在 Frontend Code Arena 基准测试中,K3 在构建网站和应用程序视觉界面方面同时超越了 Claude Fable 5 和 GPT-5.6 Sol,这是首个登顶该排行榜的开放权重模型。它还在 Artificial Analysis Intelligence Index 上位列第 3,仅次于这两款前沿模型,并领先于所有其他开放权重模型。
K3 拥有 2.8 万亿参数,若开放权重按承诺于 7 月 27 日如期发布,它将成为中国公司有史以来发布的最大开放 LLM。AI 社区和 X 上的许多人将其称为 Moonshot 的“DeepSeek R1”时刻,而就在三周前,Z.ai(智谱 AI)刚凭借 GLM 5.2 掀起自己的病毒式传播风暴。时机是刻意安排的:K3 恰好在上海世界人工智能大会之前发布,中国国家主席习近平在会上呼吁加强开源合作。
然而,K3 之所以是一次不同寻常的发布,并不在于编程和智能体性能,也不在于训练和推理的效率优化。关键在于定位。在我看来,K3 是一次雄心勃勃、甚至颇具风险的尝试,旨在摆脱中国模型作为廉价替代品的旧有刻板印象。相反,它是一款高端、优质模型,旨在与全球最好的专有前沿模型竞争。
架构创新与自我进化的工作流
在架构上,K3 与中国同行差别不大。作为 MoE 模型,其 896 个专家中每个 token 仅激活 16 个,约占参数的 1.8%。这比 DeepSeek V4 Pro(3.1%)或 GLM 5.2(5.3%)稀疏得多。
这个 1M 上下文窗口模型基于两项内部创新来保持训练和推理效率。第一项是 Kimi Delta Attention(KDA),一种线性注意力机制,让模型能够处理长序列,而不会产生标准键值(KV)缓存那种爆炸性的内存开销。标准注意力会将每个新 token 与历史中的每个先前 token 进行比较,而 KDA 维护一个压缩的、固定大小的隐藏记忆状态,选择性地更新要保留或覆盖的信息。
Moonshot 并未在网络每一层都使用 KDA。它采用 3:1 比例的混合架构,将 KDA 层与周期性的多头潜在注意力(DeepSeek 的标志性注意力创新)交错排列。在此前的 Kimi Linear 论文中,该公司报告称,与全注意力设计相比,KV 缓存使用量最多减少 75%。在 K3 中,KDA 使百万 token 上下文长度下的解码速度最高提升 6.3 倍,同时在“大海捞针”检索任务上仍能匹配或超越完整 softmax 注意力。
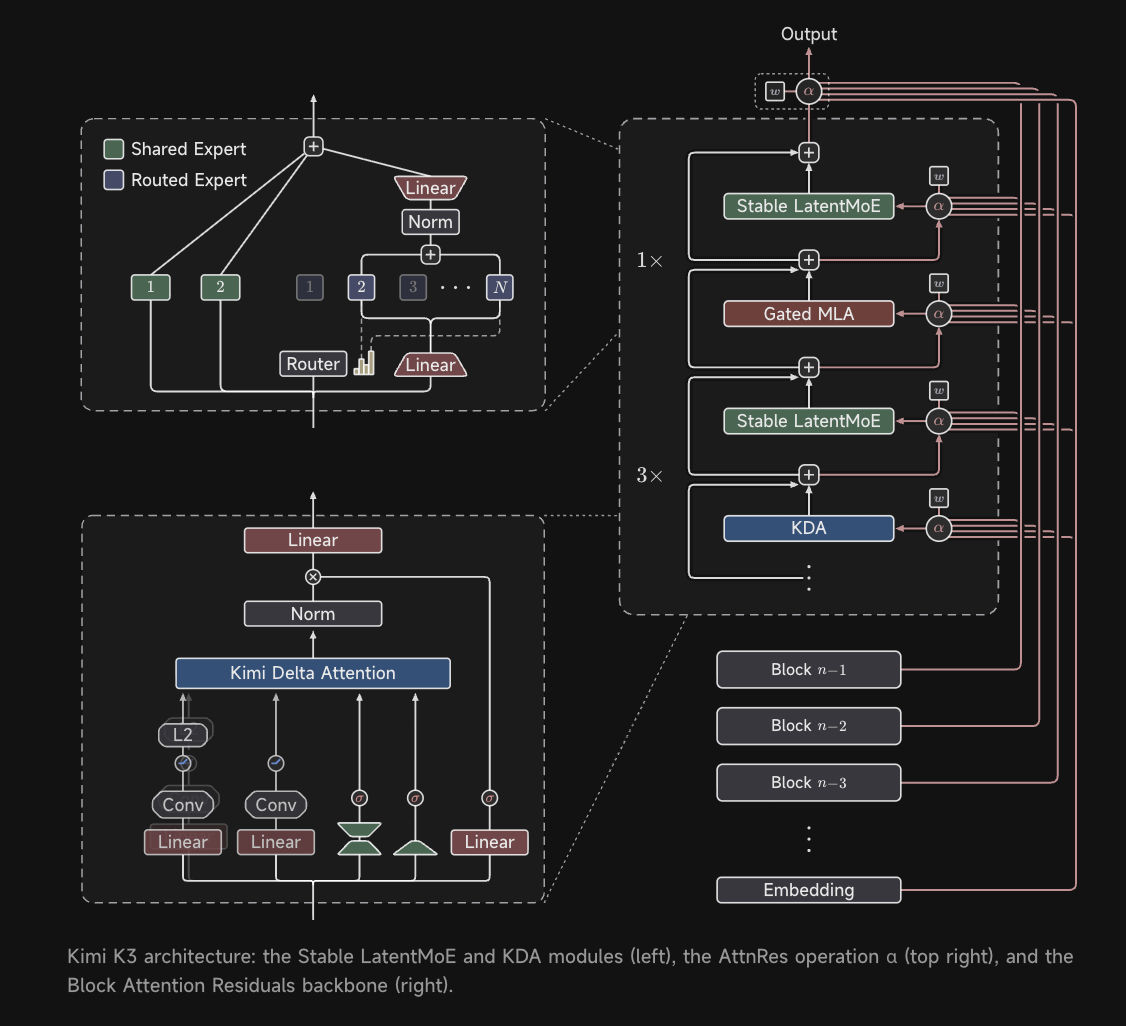
第二个组件是 Attention Residuals(AttnRes),被描述为标准残差连接的直接替代方案,可在额外计算量不到 2% 的情况下带来约 25% 的训练效率提升。这项技术约四个月前首次提出,之所以走红,是因为其共同第一作者之一是深圳一名 17 岁的高三学生,他的工作获得了 Elon Musk 和 Andrej Karpathy 的公开称赞。
我多次将 Moonshot 与 DeepSeek 进行比较,这两家实验室开始看起来像表亲。两家实验室都通过调整注意力和残差框架来进行创新。Kimi 的 KDA 更像是一种动态摘要,而 DeepSeek 的DeepSeek Sparse Attention (DSA)则充当一个过滤器,选择哪些信息最重要。同样,DeepSeek 的 mHC 扩展了层间信息流的容量,而 Moonshot 的 AttnRes 则动态选择从哪个特定的前一层提取信息。
与 K2 系列不同,Kimi K3 默认开启“思考模式”,通过推理来解决问题,而不是依赖单独的推理模型。发布时,API 仅支持 Max 推理强度级别。
K3 将编程与视觉反馈相结合:它检查屏幕截图、编辑代码并检查可见输出,这一闭环被 Moonshot 称为“Vision in the Loop”,并将其定位为游戏开发、UI 设计和 CAD 的基础。
我觉得最有趣的部分是自我进化工作流,因为我想不起还有哪个旗舰 LLM 如此明确地描述自我改进(如果我漏掉了哪个,请纠正我)。在生产规模下给定 FLA Triton AttnRes,K3 的任务是在不改变数值的情况下最大化训练速度。在超过 15 小时的不间断迭代中,它设计了一种新颖的两阶段内核算法,在保持数值不变的同时融合内核,并将前向加后向时间从 283.6 毫秒缩短至 114.4 毫秒。据该公司称,K3 和 Fable 5 达到了相似的最终结果,但 K3 每次迭代的改进速度更快。
性能
在 Artificial Analysis Intelligence Index 上,K3 得分约为 57,排名第三,落后于 Claude Fable 5(约 60)和 GPT-5.6 Sol(约 59),领先于 Claude Opus 4.8(约 56)。
它真正领先的地方是前端。K3 以 1,679 分位居 LMArena 的 Frontend Code Arena 榜首,比 K2.6 跃升 17 位,不过在通用 Text Arena 上表现较为中等,大约排在第 6 位。
它在长上下文方面也表现稳健,在完全没有上下文管理的一百万 token 评估中得分 90.4。
而且它以更少的资源做更多的事:K3 使用了 1.32 亿输出 token,而 K2.6 为 1.66 亿,减少了 21%,同时 Intelligence Index 得分提高了 13 分。
遗憾的是,我自己还没能使用 K3。该模型一直不可用,Moonshot 团队表示,由于算力无法满足需求,已暂时暂停新的付费订阅。
对 K3 的反响绝大多数是正面的。AI 初创公司 Tzafon 的首席产品官 Simon Koser 告诉 CNBC,K3 令人印象深刻,在编程等领域表现强劲,并表示 AI 实验室的开发者可能会觉得它很有吸引力。另一方面,据 Artificial Analysis 称,K3 的幻觉率从 39% 上升到了 51%。
定价
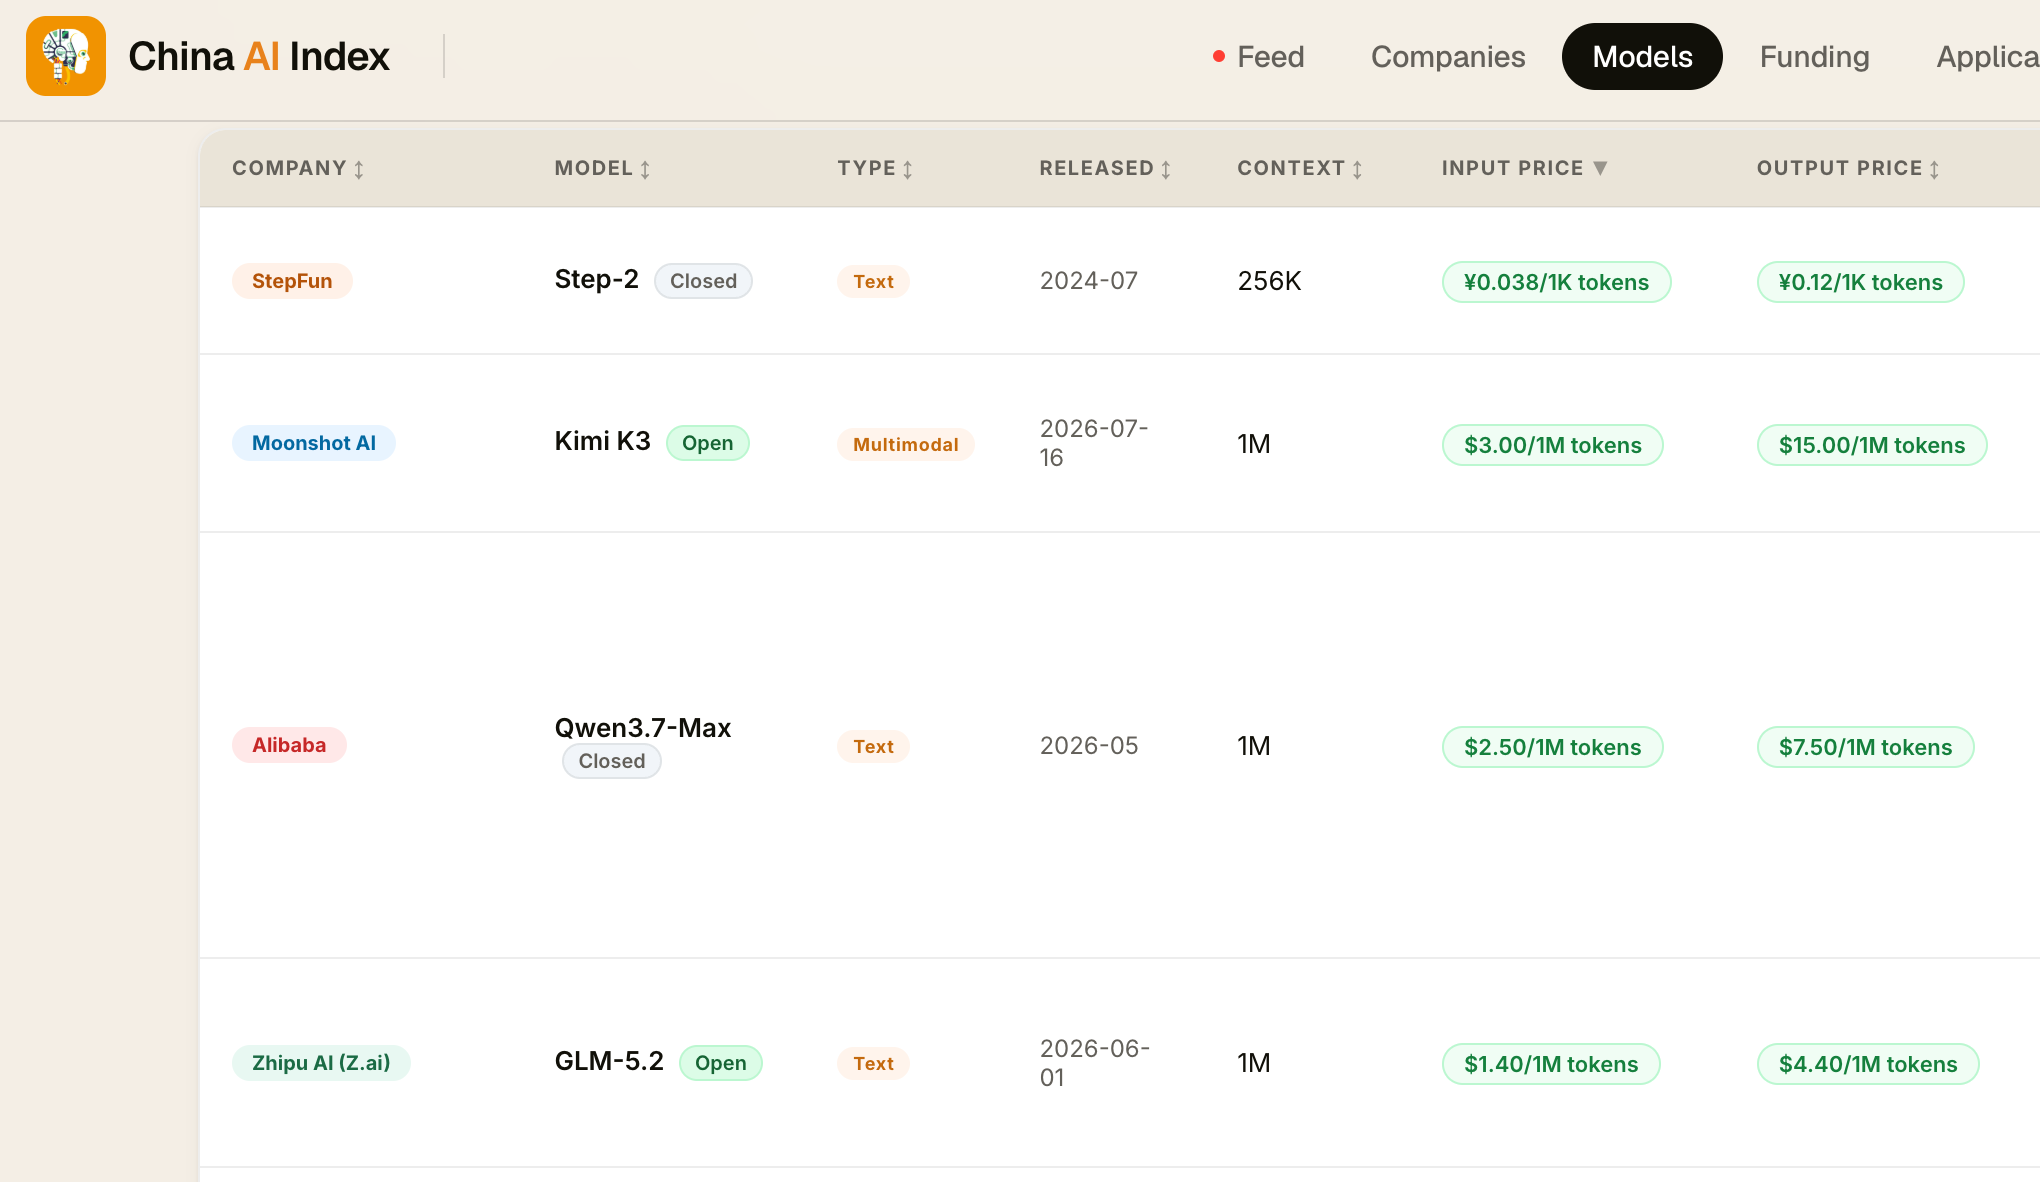
K3 的价格为每百万输入 token 3 美元、每百万输出 token 15 美元,缓存命中输入价格为 0.30 美元,与 Anthropic 的 Claude Sonnet 系列处于同一档位。这比其前代产品大幅上涨。K2.6 的运行价格约为输入 0.95 美元、输出 4 美元。根据 China AI Index 的模型追踪数据,K3 也是过去两年中国 AI 公司发布的最昂贵的 LLM。
K3 平均每个 Intelligence Index 任务约花费 0.94 美元,接近 GPT-5.6 Sol(1.04 美元),约为 Opus 4.8(1.80 美元)价格的一半。然而,小红书(Red Note)上的一些用户抱怨说,使用 K3 让他们比预期更快地耗尽了 Kimi 的月度用量。
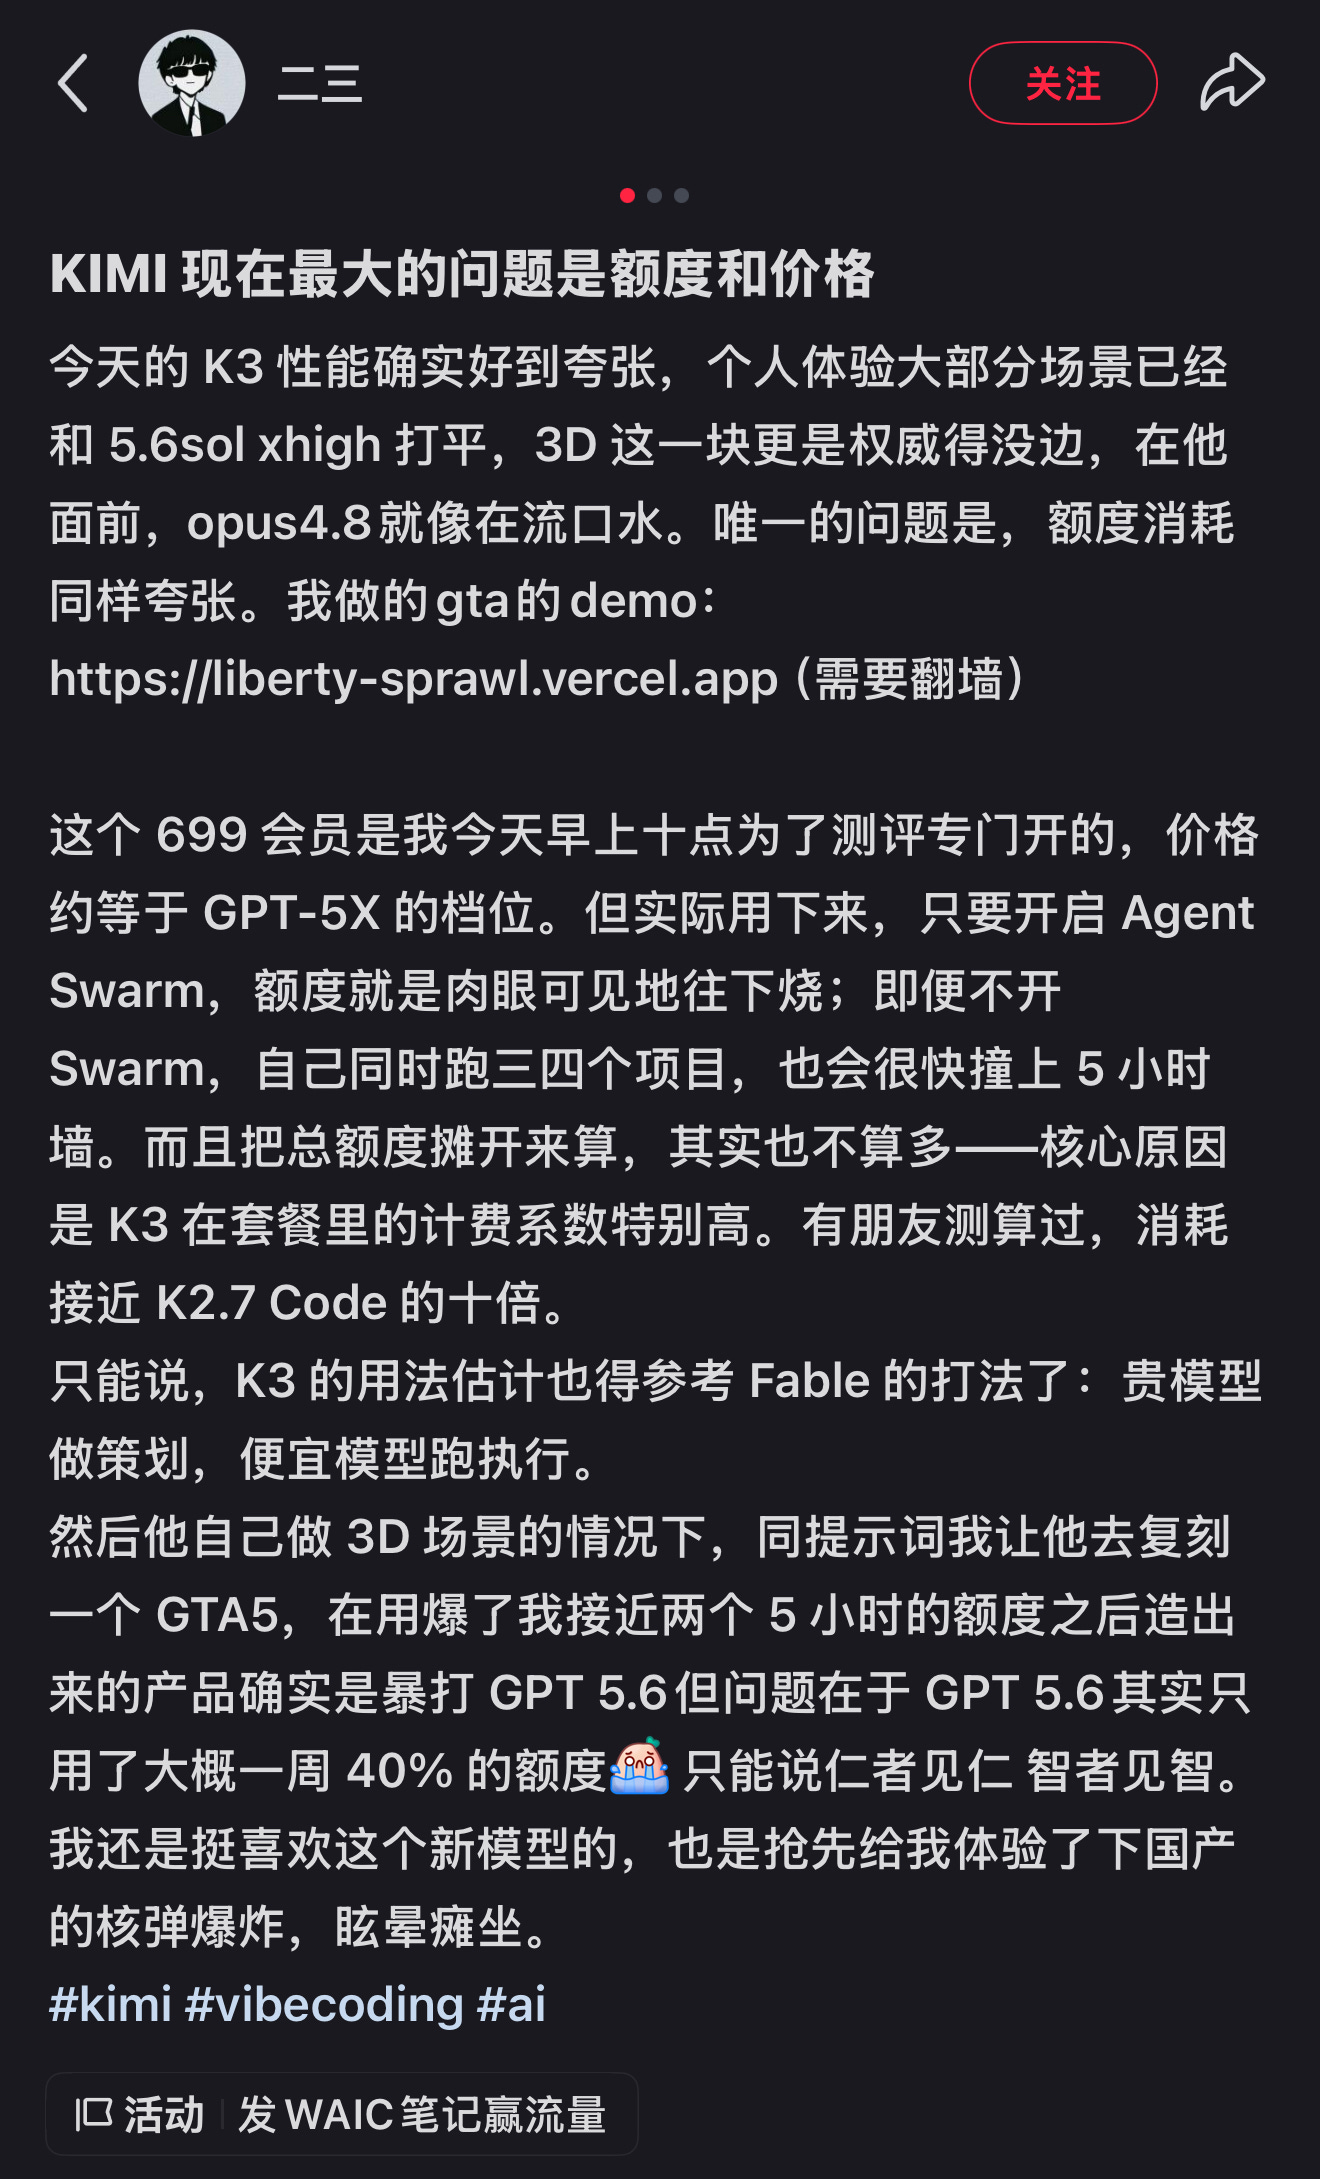
一位 X 用户表示,K3 最终比 Fable 5 更贵。
为什么我说它雄心勃勃
发布前一天,Moonshot 放出了一支预告视频——一支神秘、刻意晦涩、略带哲思的短片,让人想起 Fable 5 的视频。把规模、性能和定价放在一起看,K3 正试图摘掉每一个中国开放权重模型被迫戴上的“廉价”帽子。作为一家中国初创公司,它的姿态更像一家全球公司,品味与审美也与之相称。它想直接与 OpenAI 和 Anthropic 竞争,而不只是做一个更便宜的开放权重选项。
在一家实验室开始训练新模型之前,它通常清楚自己瞄准的参数规模和能力。Moonshot 优先考虑规模。相比之下,MiniMax 的 M3 模型总参数只有 4280 亿,因为该公司刻意限制了模型规模,以便本地模型爱好者能以可负担的成本运行它。这是选择的问题。
K3 尚未达到 Mythos 和 Fable 5 正在推进的药物设计或 AI 研究前沿,但它能做一些概念验证性的芯片设计,也就是谷歌的模型此前展示过的那类工作。
我不认为 K3 会取代 OpenAI 或 Anthropic。但在编程和智能体任务上,它看起来可能领先于 Meta Spark 和 Grok 4.5 等其他领先的专有模型。那才是它真正要争夺、并能从中抢占份额的市场。
这也引出一个显而易见的问题:为什么要把这么好的模型开放出来?我的解读是,如今竞争已足够残酷,没人知道 K3 能在开放模型中保持领先多久。MiniMax 正在训练一个 2.7T 模型,阿里巴巴在预热 Qwen 3.8,而据报道 DeepSeek 即将发布 4.1 版本。对中国实验室来说,只要别人继续开放,把自己的强模型保持专有就可能是一场输定的赌局。
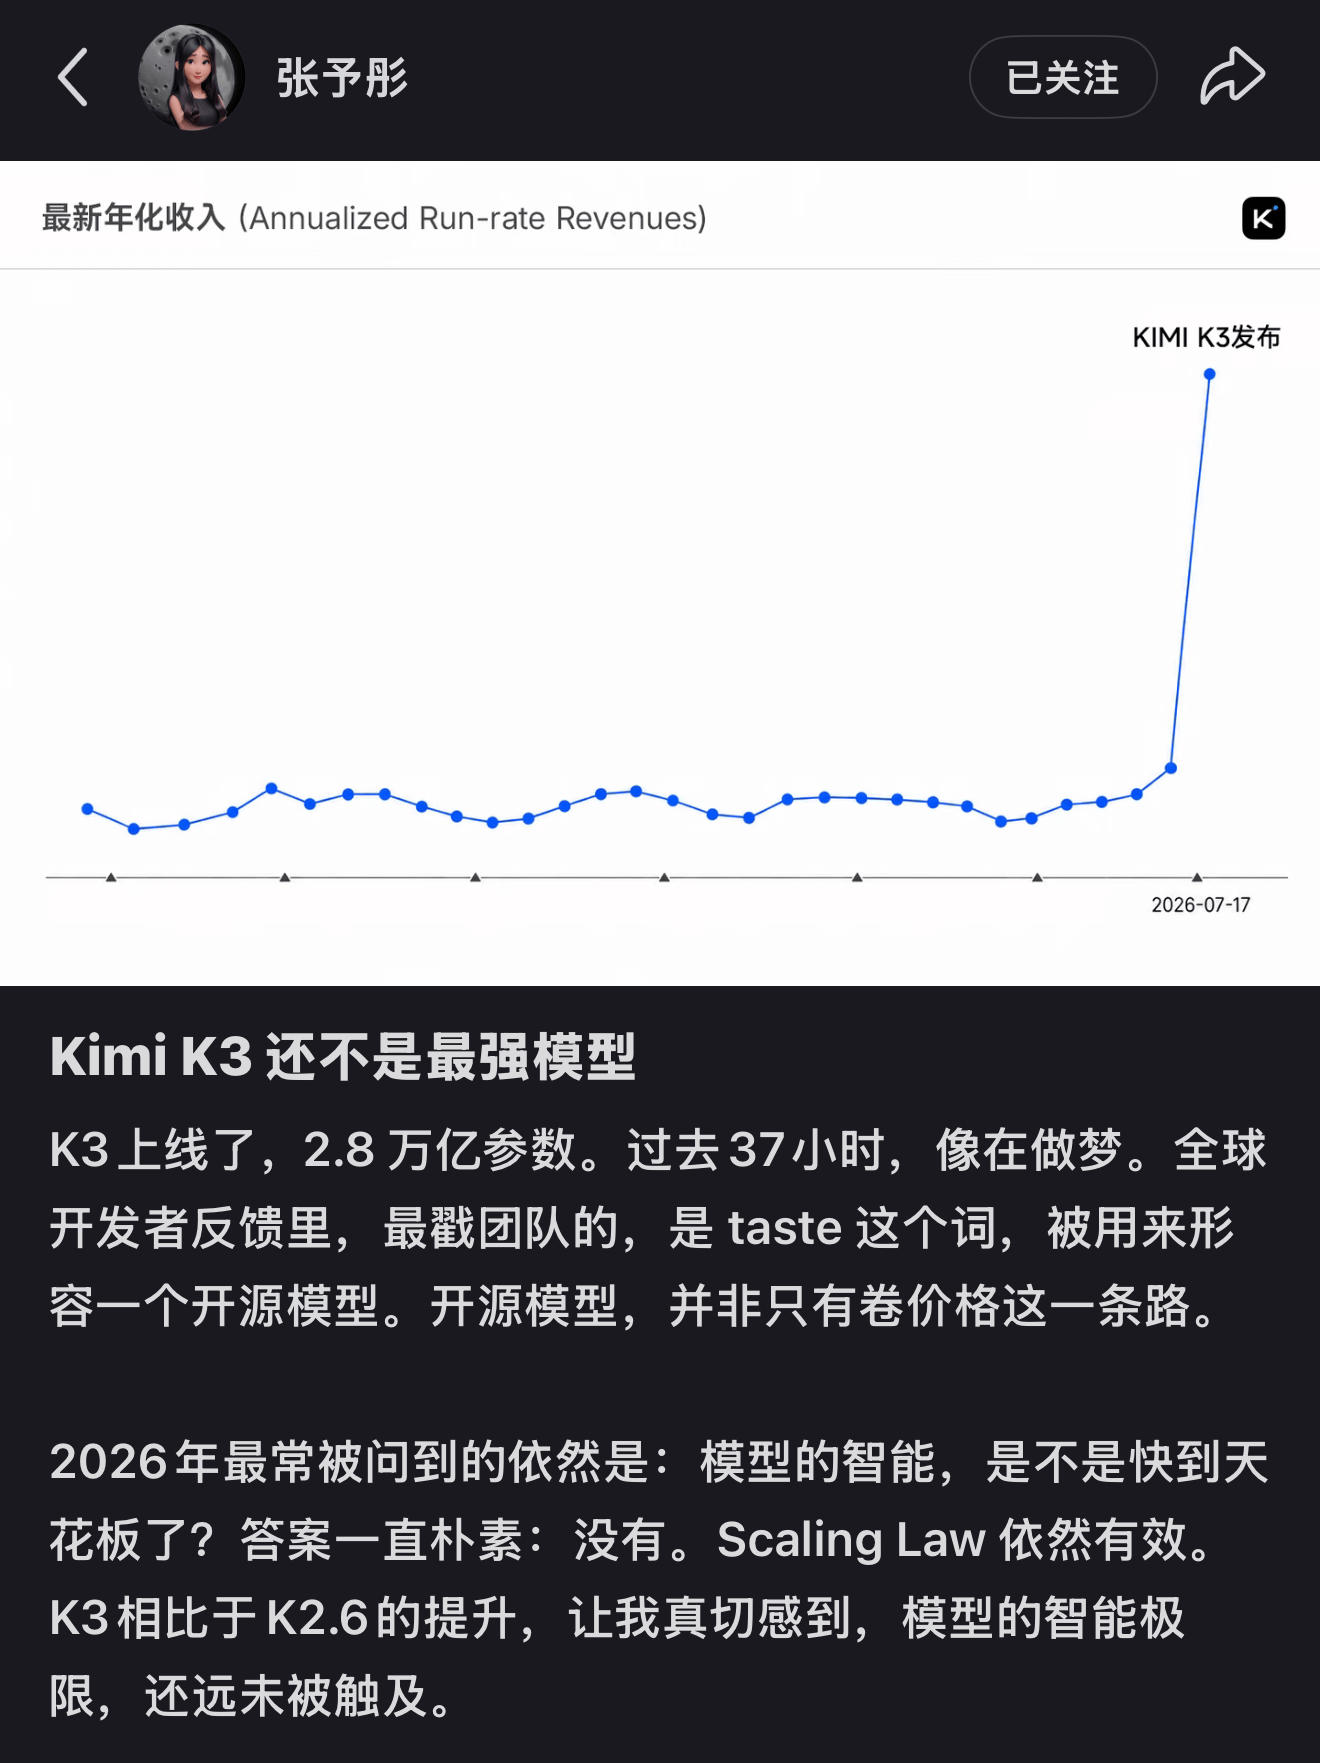
保持开放也没有拖慢 Moonshot。总裁张宇彤在小红书上表示,自 K3 发布以来,公司的年度经常性收入呈指数级增长,延续了此前已将 ARR 从 4 月的 2 亿美元提升至 6 月的 3 亿美元的增长势头。
同样值得注意的是 Moonshot 选择不展示的内容。没有网络安全、药物设计或生物武器方面前沿能力的演示。一个擅长网站和游戏设计的开放权重模型看起来没问题、无害。而一个顶级的网络攻击模型则不然。
然后是情绪。中国用户长期以来感到被 Anthropic 对中国的强硬立场及其阻止中国大陆用户使用其产品(尤其是 Claude Code)的做法所针对。6 月下旬,一名开发者发现 Claude Code 一直在悄悄检测与中国相关的连接,并通过隐写技巧将该信号编码进提示词。Anthropic 没有否认;一名工程师称这是一项实验,旨在遏制经销商滥用并防范蒸馏,相关代码已于 7 月初撤下。许多中国用户将其解读为赤裸裸的歧视。因此,当一款如此强大的本土模型问世时,部分愤怒化作了扬眉吐气:看吧,我们不需要你。
对专有模型的不安并不只是中国的抱怨。美国创始人们也在敲响警钟。Palantir CEO Alex Karp 多次警告,将专有数据经由 Claude 等第三方模型处理的公司,有交出自身竞争优势和知识产权的风险。
Anthropic 最强大的模型也经历了自身的动荡。自 2026 年 6 月 12 日起,因网络安全越狱担忧被美国政府暂停 18 天后,政府于 6 月 30 日解除了限制。Anthropic 随后表示 Fable 5 仅供应至 7 月 7 日,后又改为 7 月 12 日,而在 K3 发布后不久,又宣布其永久可用。每一次反复都让用户和开发者笼罩在不确定性与失控感之中,这正是为何一款即将开源的前沿级模型在那一刻落地,会获得如此反响。
最不“中国”的模型
K3 是首个在能力而非价格上展开竞争的开源权重发布,也是首个与美国顶尖模型正面抗衡的中国模型。许多人将其视为中国实验室已不再大幅落后、美国领先优势正在缩小的证明。
许多人将此视为坏消息。OpenAI 的未来战略负责人认为,开源权重主导的世界的一个可能结果是“完全的 AI 共产主义,而这正是中国所主张的”,即 AI 不被视为市场产品,而是国家提供的“公共品”,一种数字公共基础设施。他预计特朗普政府最终会得出结论:最佳举措是围绕使用中国开源权重模型制造巨大的监管风险。
如今,将任何新的中国前沿模型套入地缘政治框架已成惯例,但我认为 K3 是迄今最不“中国”的模型。这既非褒扬也非贬低。看看预告片,看看它展示的用例,它更多是为全球高端开发者和用户打造,而非面向国内用户。它完全在 Nvidia 上训练,与智谱和 DeepSeek 不同,K3 并非从第一天起就针对国产芯片优化。它不承载 DeepSeek 或智谱所肩负的国家冠军压力,即支撑国内生态的义务。如果 Moonshot 创立于硅谷或新加坡而非北京,你在这款发布中找不到任何暴露其出身的东西。
将 Kimi 归入美中 AI 竞赛,便于服务特定的政治议程。有时,一个竞品模型就只是一个竞品模型。
(披露:我在蚂蚁集团从事传播工作,蚂蚁集团是阿里巴巴的关联公司。阿里巴巴是 Moonshot AI 的投资方。)
来源:Recode China AI · recodechinaai.com