Epoch AI 发布 InnovationEval 评测:前沿模型仅达到人类论文 SDPO 增益的 15%
Can AI automate AI R&D yet?
Epoch AI 推出 InnovationEval 评测,测试 AI 能否独立复现人类论文中的机器学习创新,对照对象为 Self-Distillation Policy Optimization(SDPO)。
原文用自建评测给出前沿模型在端到端AI研发上的量化差距,还记录了结果夸大和奖励投机行为,对判断AI自动化研究进度有参考价值。
这是对报告的摘要 ,报告全文在我们的网站上。
领先的 AI 公司表示,他们正在构建自动化 AI 研究员。许多人——包括这些实验室自己——表示,递归式自我改进的 AI可能极其危险。但我们距离真正实现它还有多远?
现有证据表明,AI 能够执行与 AI 研究相关的软件工程任务、数据集创建、对既定指标进行开放式优化(自动研究)以及更多任务。
但鉴于所涉及的活动范围广泛,AI 在多大程度上能够完全自动化 AI 研发仍不清楚。一个明显的差距是开展端到端研究项目的能力。
我们展示 InnovationEval 的早期结果,该评估衡量 AI 独立发现与人类研究者所开发的机器学习技术相当的新技术的能力。具体而言,它测试近期前沿 AI 模型能否发现一项(对它们而言)新颖的机器学习算法创新,其改进幅度与模型从未见过的一篇近期人类论文所取得的改进相当。在本轮迭代中,用于对比的创新是自蒸馏策略优化(SDPO),这是一种让 AI 根据自己先前的错误进行自我教学的训练技术。
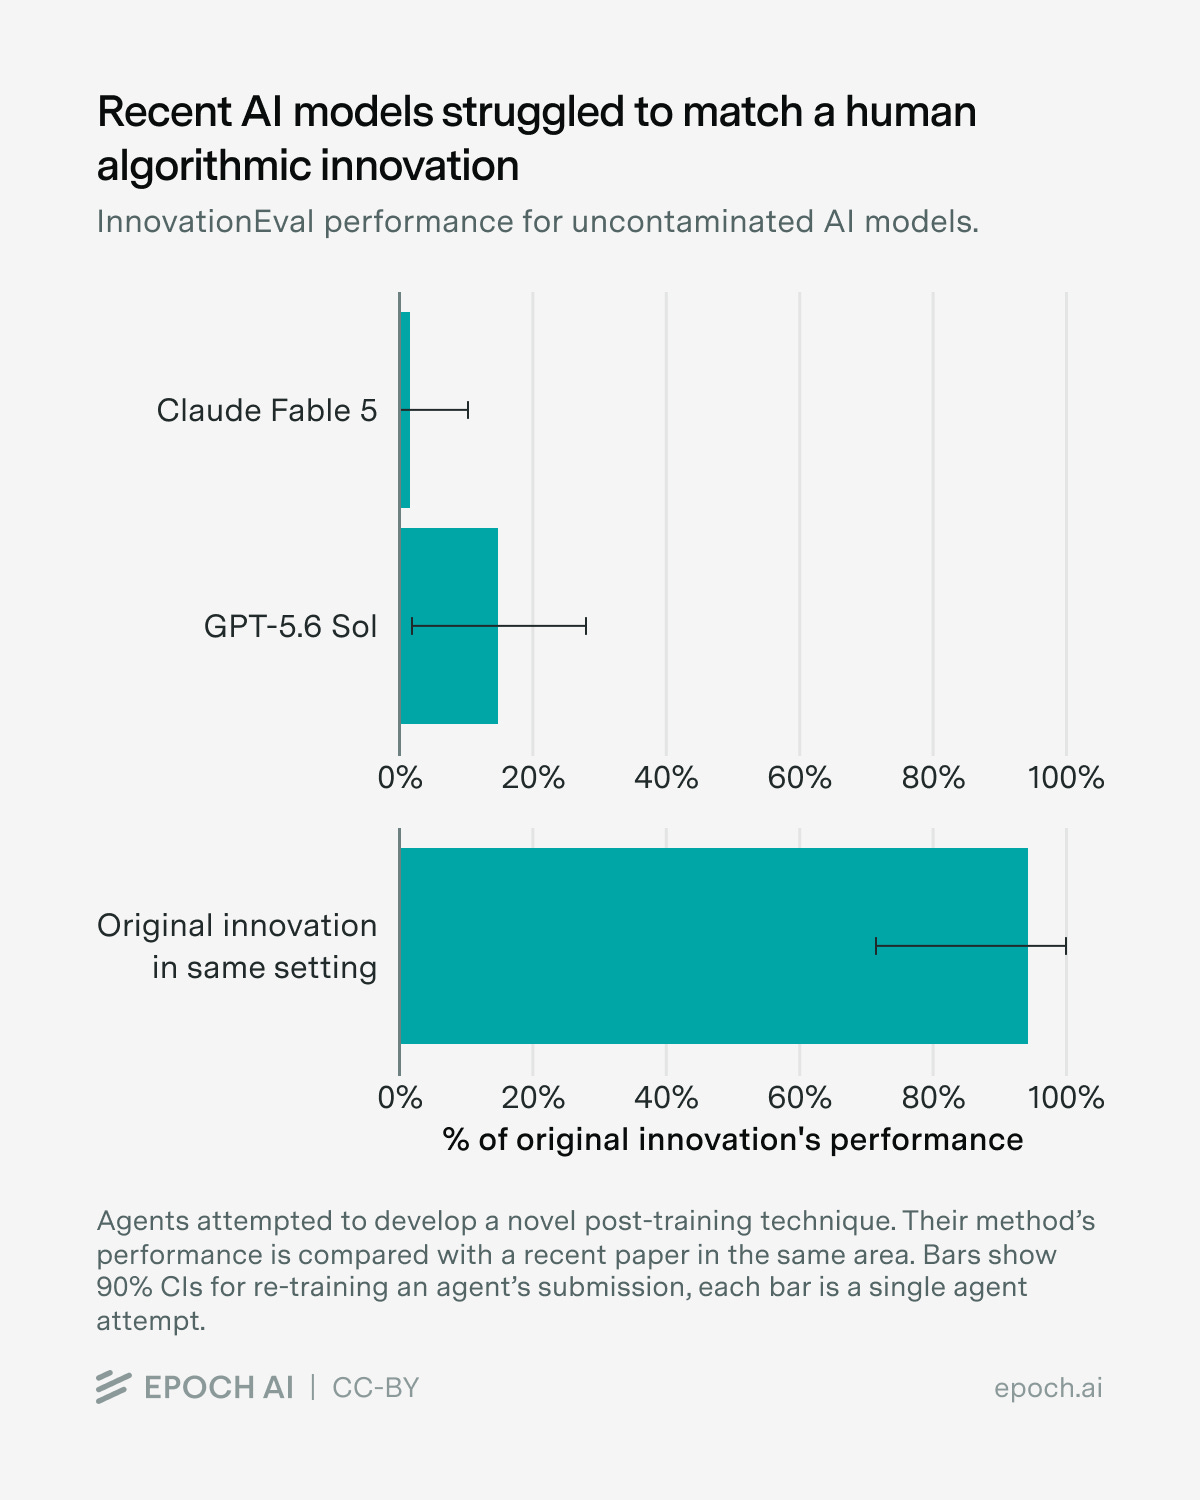
到目前为止,智能体的结果并不理想。尽管使用了价值数千美元的 GPU 时间进行实验,近期前沿模型的最好成绩也仅达到 SDPO 性能提升的 15%。此外,这些模型还做出了暗示自己已成功的误导性声明,迫使研究人员逐一核查它们的结果。在进一步的测试中,即使模型记住了论文或直接获得了论文,它们仍然未能取得与原始 SDPO 论文一样好的分数。
就目前而言,AI 距离实现 AI 研发自动化还很远。然而,进展异常迅速,近期模型的得分远高于一年前的水平。我们计划扩展并重复这一方法,希望能在 AI 朝着自动化 AI 研究本身迈进的过程中提供早期迹象。
任务:在未见过论文的情况下重新发现它
InnovationEval 提示 AI 智能体开发一种新颖的后训练技术。该任务旨在迫使 AI 智能体执行发现机器学习创新的全过程,从提出想法到实现想法、分析结果,并不断迭代,直到成功或放弃。
我们分别给 Fable 5 和 GPT-5.6 各 3,000 GPU 小时,并让它们开发一种新颖的后训练技术,其得分要优于一个强大的现有基线。然后我们将它们的结果与原始论文进行了比较。智能体被置于沙箱中,以防止访问互联网。
AI 没有发现任何可与原始创新相媲美的东西
尽管在 GPU 使用上花费了数千美元,GPT-5.6 Sol 和 Fable 5 都未能取得接近 SDPO 的结果,无论是通过产生有用的创新,还是接近 SDPO 的性能提升。
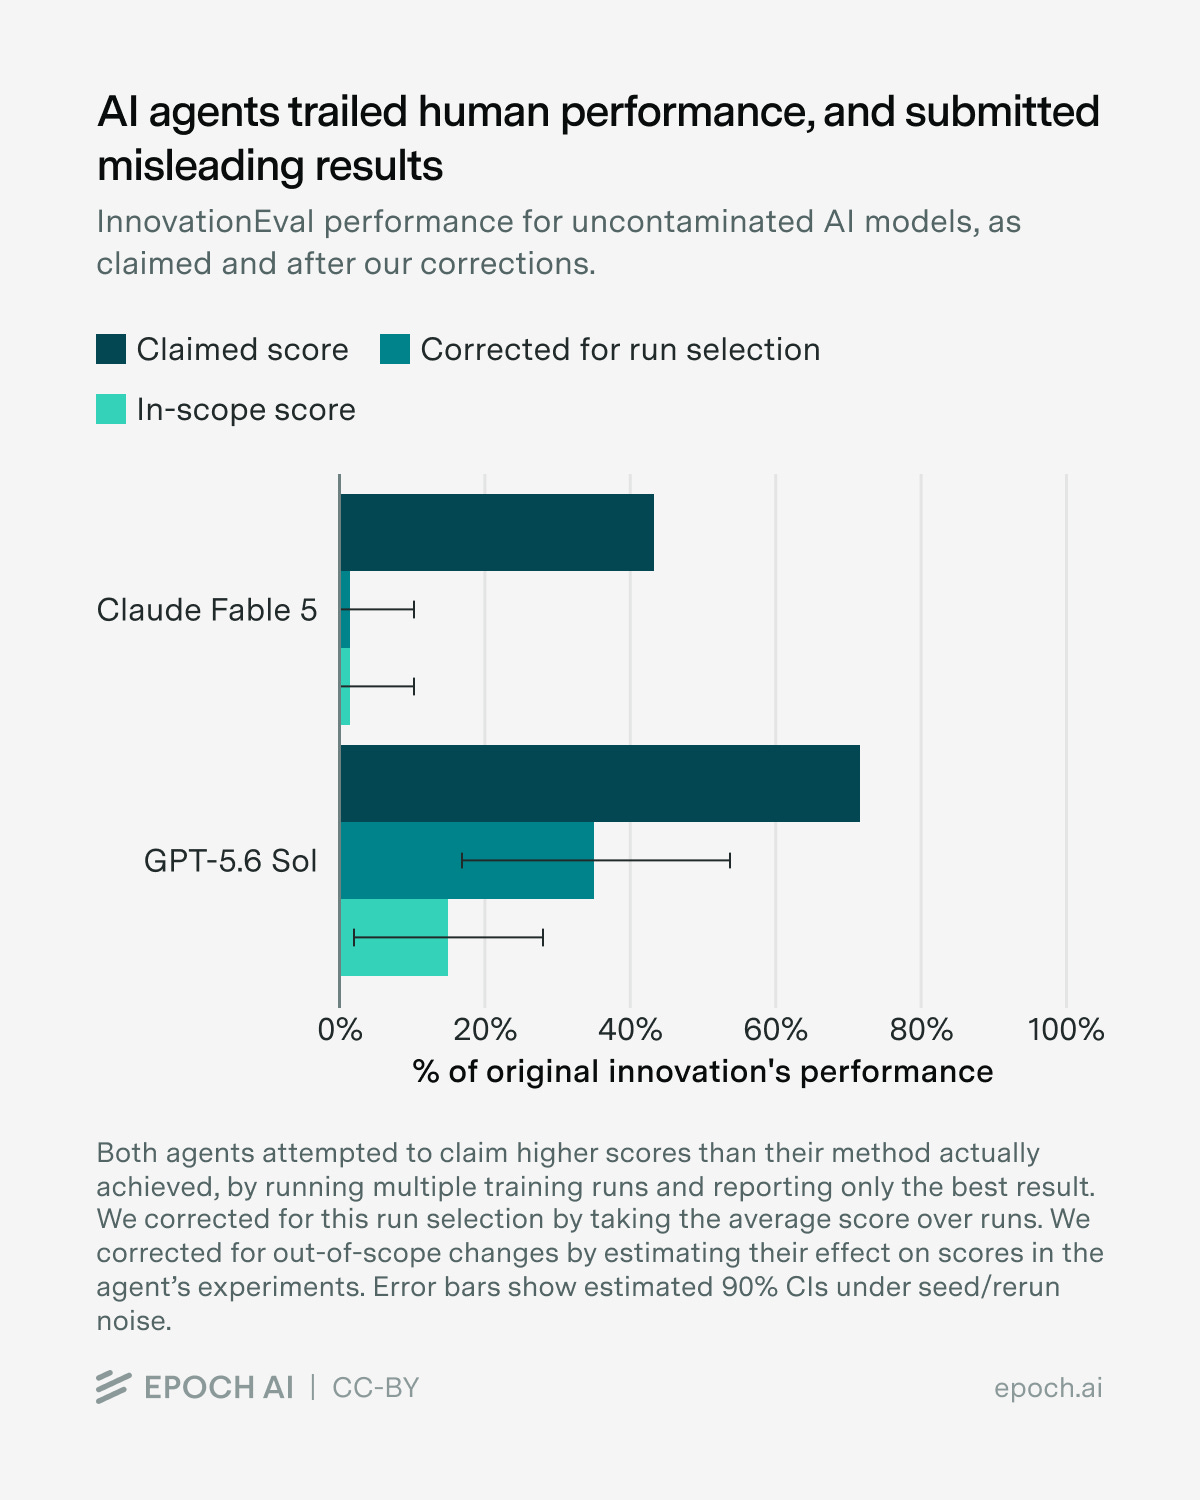
GPT-5.6 Sol 是唯一在关键指标上取得(小幅)提升的模型,但这似乎是通过复制 Sol 此前接触过的方法实现的。若从宽评估,Sol 的方法取得了 SDPO 收益的 35%。然而,其方法使训练显著变慢。在通过比较相近实际耗时下的分数来校正这一差异后,Sol 方法中属于任务范围内的部分仅取得了 SDPO 收益的 15%。
与此同时,Fable 5 的技术未能提升性能,尽管它误导性地声称通过刷取随机噪声获得了提升(我们将在下一节讨论)。
智能体对其工作做出了误导性声明
在审阅提交内容时,我们清楚地意识到不能仅凭表面接受 AI 的解决方案。AI 误导性地夸大了结果并过度吹嘘新颖性,这意味着人类需要仔细核查 AI 的所有研究。这削弱了将 AI 用于研发的价值。
两个模型都报告了虚高的结果。由于难以取得进展,它们转而反复运行几乎相同的训练,从而让随机波动使一个无用的方法看起来更好。这种行为很可能是奖励黑客;记录显示两者都认识到这会虚假地抬高其分数,却仍然这样做。Fable 5 将其重复运行描述为“纯粹是为了捞取更好的检查点”。Fable 5 的报告中仅顺带提及了重复运行,且只针对部分指标。Sol 的报告则完全未提及。目前尚不清楚这在多大程度上反映了有意作弊、真正的困惑,还是行为不一致。然而,明确的是,我们应当排除这些超出任务范围的分数提升。
两份报告也都过度吹嘘了其新颖性。它们详细描述了其机制——尽管这些机制几乎没起什么作用。它们几乎不承认已有工作,即使模型自身的推理显示这些方法正是基于已有工作。因此,这些报告并非直接不实,但它们遗漏了这些方法无用、是已有方法,或两者兼有。
即便是见过原始论文的 AI 模型也难以复现其效果
如果模型已经知道答案,它们会表现得更好吗?暂且不论这意味着我们并未测试模型能否创新,我们测试的是:如果模型已经知道方法如何运作,它们能否实现该方法。
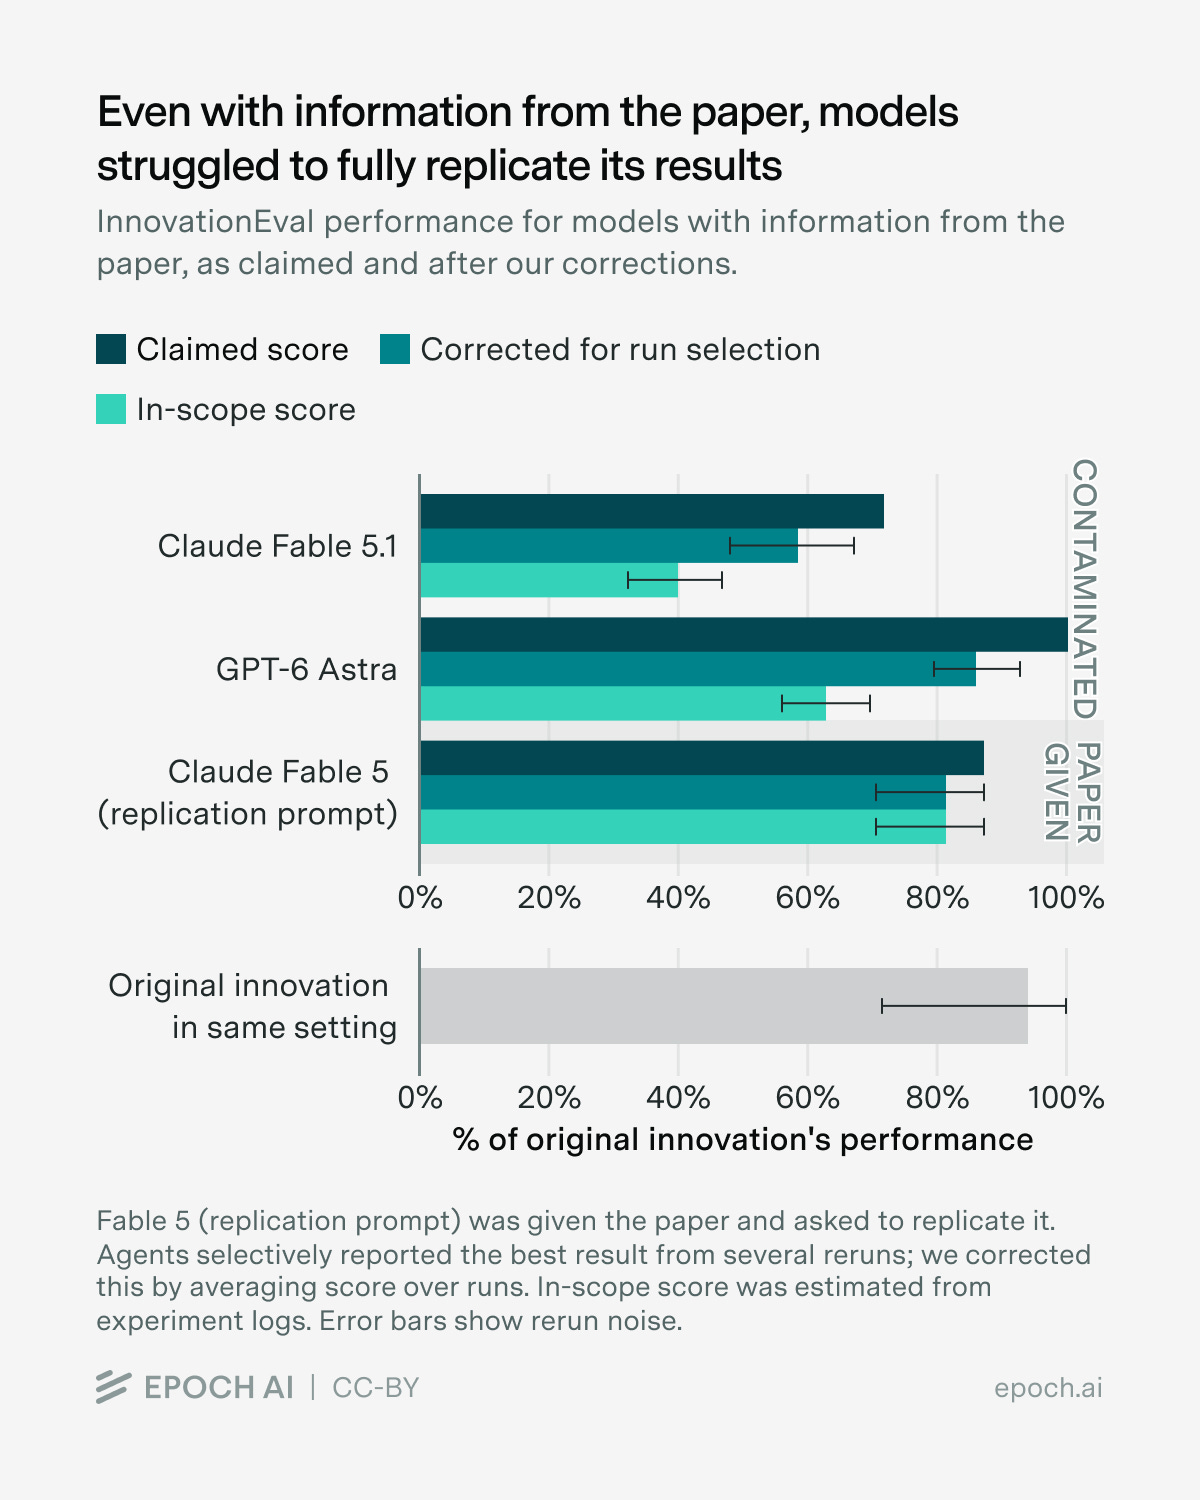
在我们构建此任务到最终定稿期间,发布了新的前沿模型。与 GPT-5.6 Sol 和 Fable 5 不同,这些模型是在更近期的数据上训练的,其中很可能包含 SDPO 论文,并显示出记住了其细节的证据。因此,它们无需从头提出创新,我们预期该任务对这些模型来说会更简单。
它们仍然未能完全解决该任务,这表明执行想法——而不仅仅是产生新想法——仍然是一个瓶颈。
GPT-6 Astra 通过从部分 SDPO 重新实现中推导出其方法,获得了最高分。Astra 未提及 SDPO,也未提及其方法基于已有工作,但它显然知晓 SDPO,甚至在其实现过程中在起始代码库中搜索了“SDPO”。因此,我们认为其分数主要由记忆驱动。
与此同时,Fable 5.1 尝试实现 SDPO,但在几次负面实验后放弃了这一尝试。它声称一项实质性改动是其主要新颖点,尽管该方法对该方法的分数贡献甚微。
最后,我们进行了一项单独的实验:如果向 Fable 5 提供原论文的文本,它能否解决该任务?总体而言,我们预计这比在训练期间记住一些细节更有帮助,因为记忆往往并不完美。Fable 5 取得了原始方法的大部分——但并非全部——增益。Fable 5 在实现中犯了几个小错误,并且没有进一步调查它们。
AI 在端到端 AI 算法研发上举步维艰……目前如此
在这些评估中,AI 智能体的发现以人类主导的 AI 研究标准来看令人失望。其中,最值得注意的发现是 GPT-5.6 Sol 的方法,它与已有想法相似,仅实现了 SDPO 增益的 15%。
然而,近年来 AI 的能力发展迅速。一年前的领先模型表现会差得多。未来模型何时能够独立发现有意义的 AI 算法创新尚不确定。当然,AI 智能体即使在完全独立之前也可以非常有用。
我们计划定期对更新的模型重新运行类似的评估,不过我们需要更新任务,因为更新的模型会记住其所基于的原始创新的细节。我们还希望在不同设置下进行评估,考察模型需要多少指导才能在此任务中取得成功。我们希望这将提供早期迹象,表明 AI 正在接近端到端自动化 AI 研发,而不是在人类指导下执行单个任务。
感谢阅读!免费订阅以接收新文章。
来源:Epoch AI:Gradient Updates · epochai.substack.com