SemiAnalysis 测算:Anthropic 订阅的 API 等价价值约为 OpenAI 的 5 倍以上
Anthropic Subscriptions Offer 5x+ More Value Than OpenAI
SemiAnalysis 通过逐项测量用量表变化,估算各订阅计划的 API 等价价值,结论是在中端模型档位 Anthropic 订阅的价值约为 OpenAI 的 5 倍。
原文给出了可复现的订阅额度测量方法和 OpenAI 与 Anthropic 各档位的具体价值对比,读者可据此选择更适合自己工作流的订阅方案。
订阅套餐仍然是消费者和小型企业为 AI 付费的主要方式。这些套餐获得了高额补贴——正如我们此前在六月所解释的那样——但作为强大的客户获取和营销工具,它们在经济上仍然说得通。例如,OpenAI 慷慨 重置所带来的好感,部分促成了近期 Codex 采用量的激增,并迫使 Anthropic 多次 收回 成命,撤销原定的订阅削减计划,以免在舆论法庭上被击垮。
此外,由于订阅套餐获得了如此高额的补贴,尽管它们只占总收入的一小部分,却也可能对利润率和每 MW 收入产生重大影响。请看以下 Anthropic 的大致数字。
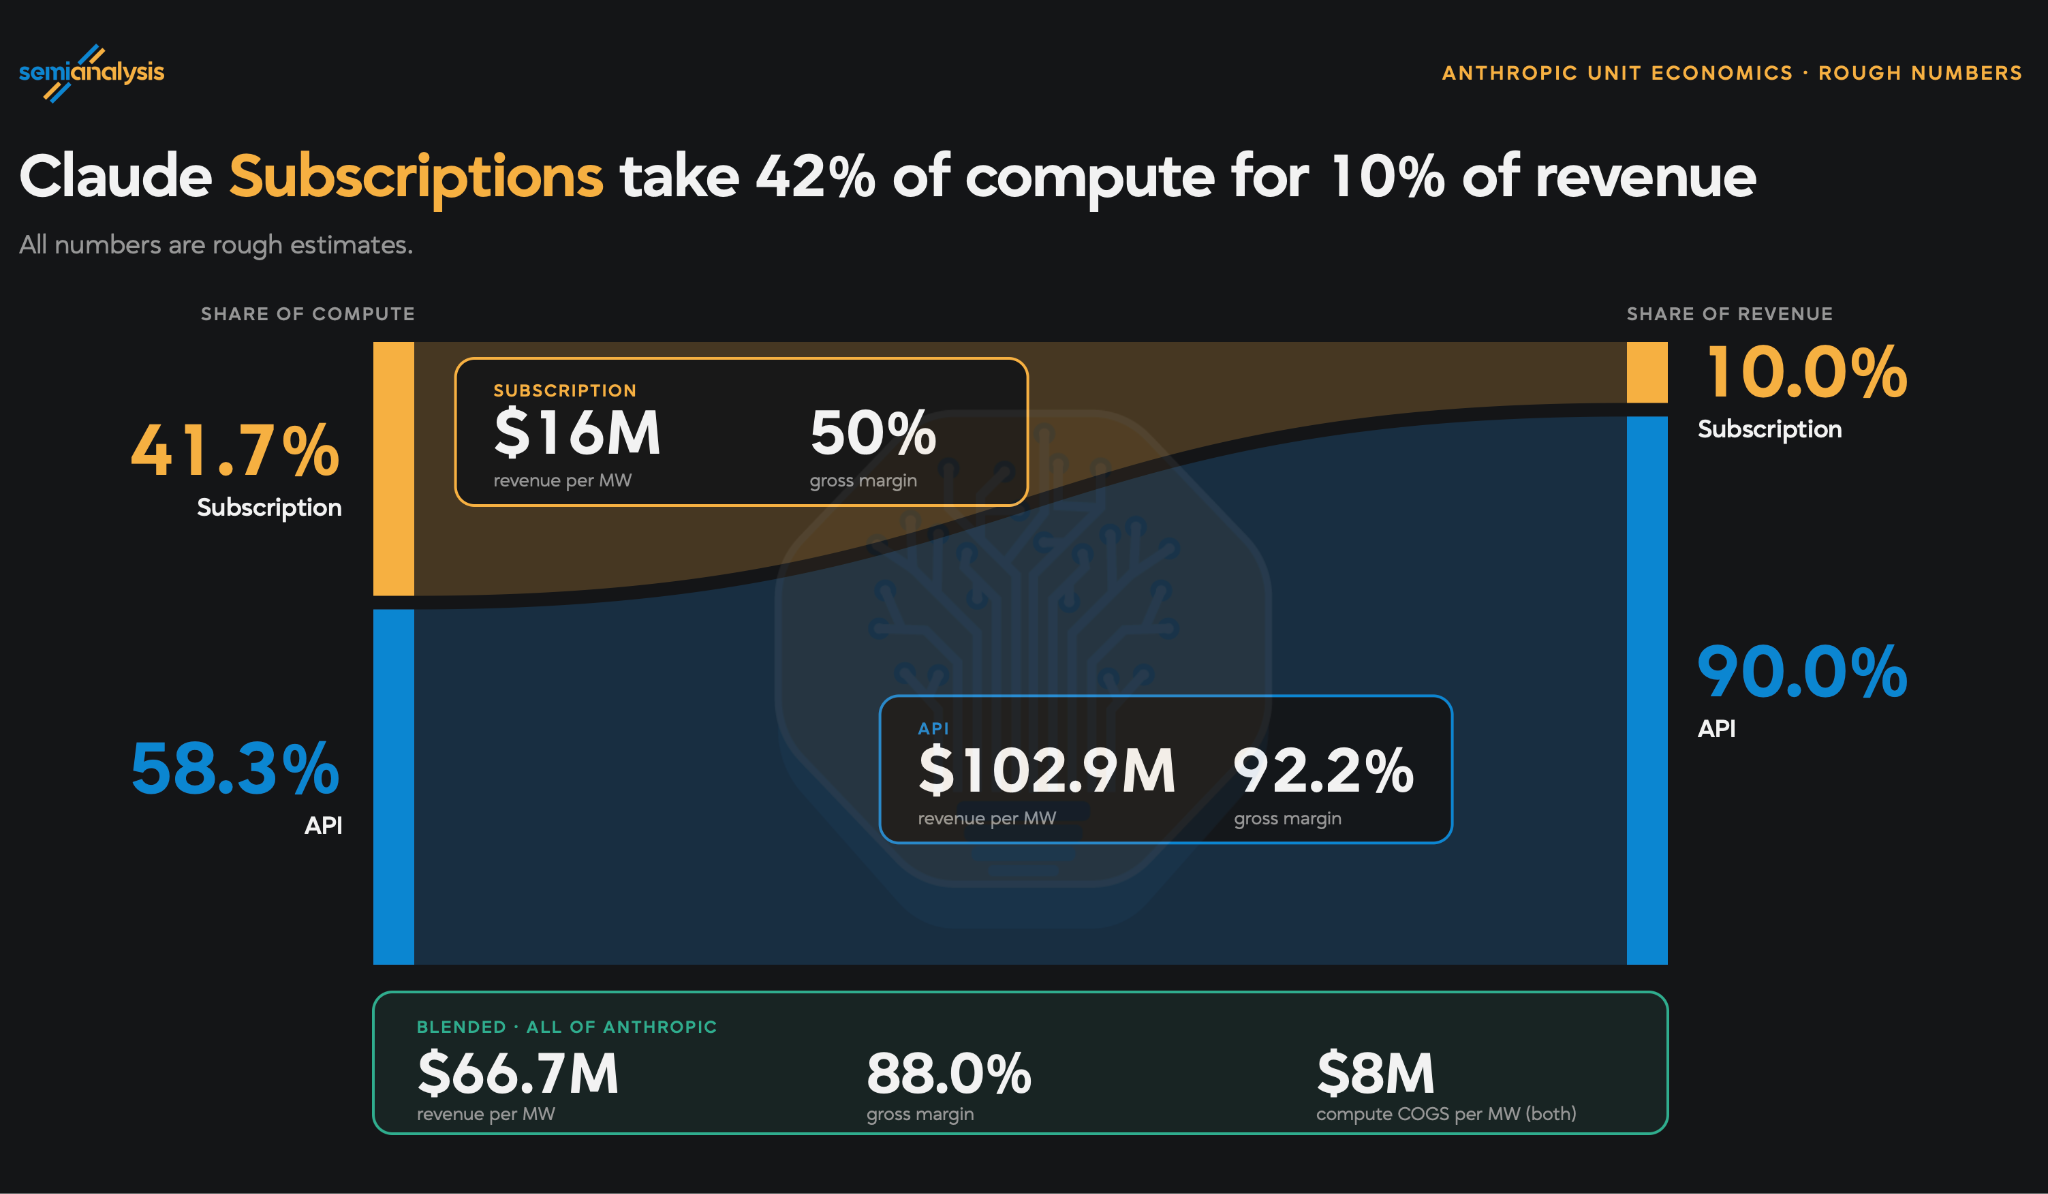
尽管订阅仅占整体收入的 10%,却可能占用超过 40% 的推理算力,并使混合每 MW 收入降低约 3600 万美元。订阅对 OpenAI 甚至更为重要,因为它们在 OpenAI 总收入中占比更大。具体数字请参阅我们的Tokenomics Model。
换言之,如果你想准确建模 AI 实验室的财务状况,就需要了解它们的订阅限额。
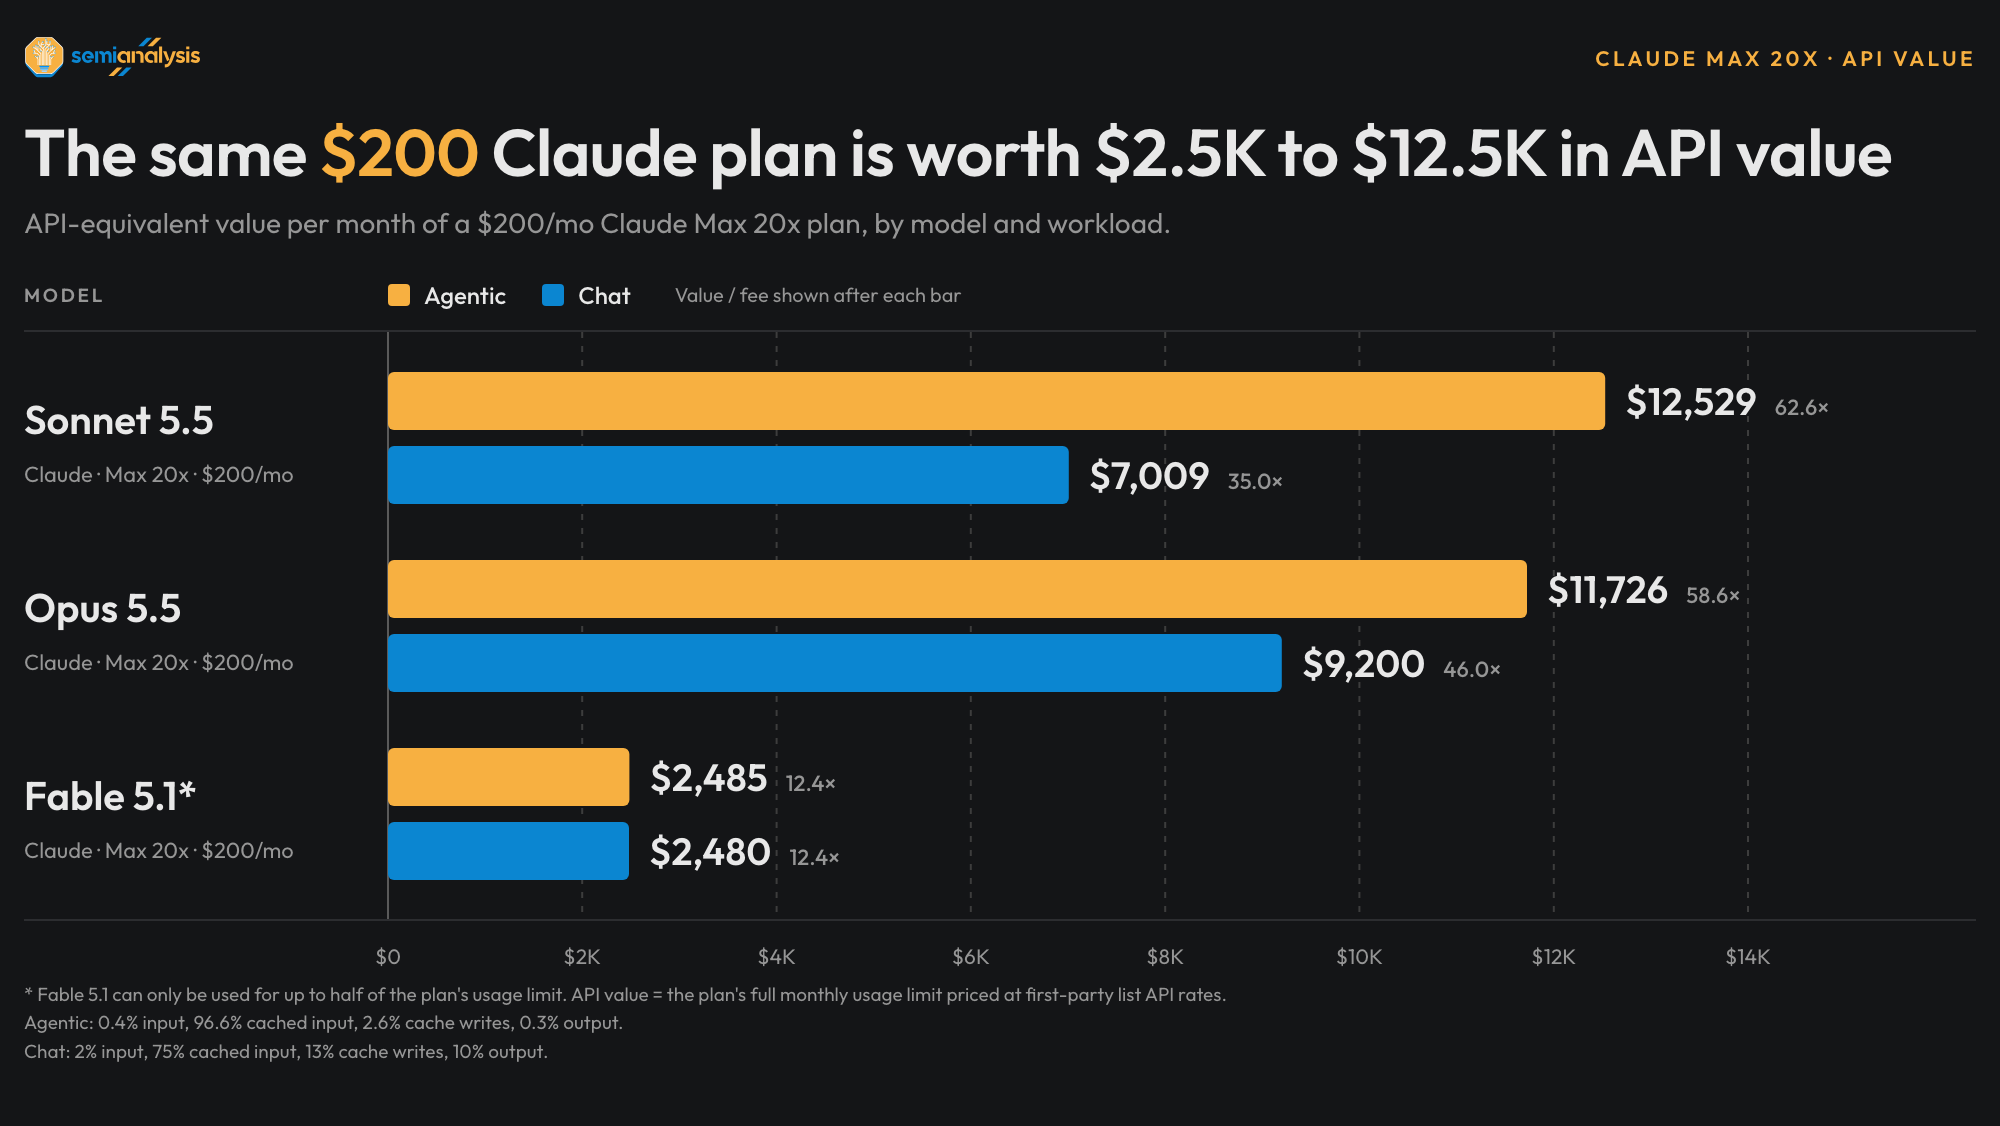
那么限额究竟是如何运作的?理解订阅的方式是:你的月度付款为你授予一定数量的“积分”。每种(模型、token 类型)组合消耗不同数量的积分。由于积分成本比例可能与 API 价格比例存在巨大差异,同一套餐的“价值”会因你所运行的模型和工作负载而异。换句话说,孤立地说某个套餐值 X 美元是没有意义的——你需要考虑完整的(套餐、模型、工作负载)元组。
以下是同一个每月 200 美元的 Claude 套餐,其 API 等值价值如何随模型和工作负载而变化。
单一的静态快照也不够。实验室会通过促销和新模型发布不断公开调整其限额。它们还可以随时通过调整积分成本来悄悄改变限额。理想情况下,你应当每天重新核查每种(套餐、模型、token 类型)的成本,以便实时发现任何变化。
这正是 SemiAnalysis 通过我们全新的Subscriptions Dashboard所做的,该面板仅向Tokenomics Model订阅者开放。除了所有 OpenAI 和 Anthropic 订阅外,我们还追踪 Meta、SpaceXAI、Cursor、Cognition、Z.ai、MiniMax 和 Moonshot。
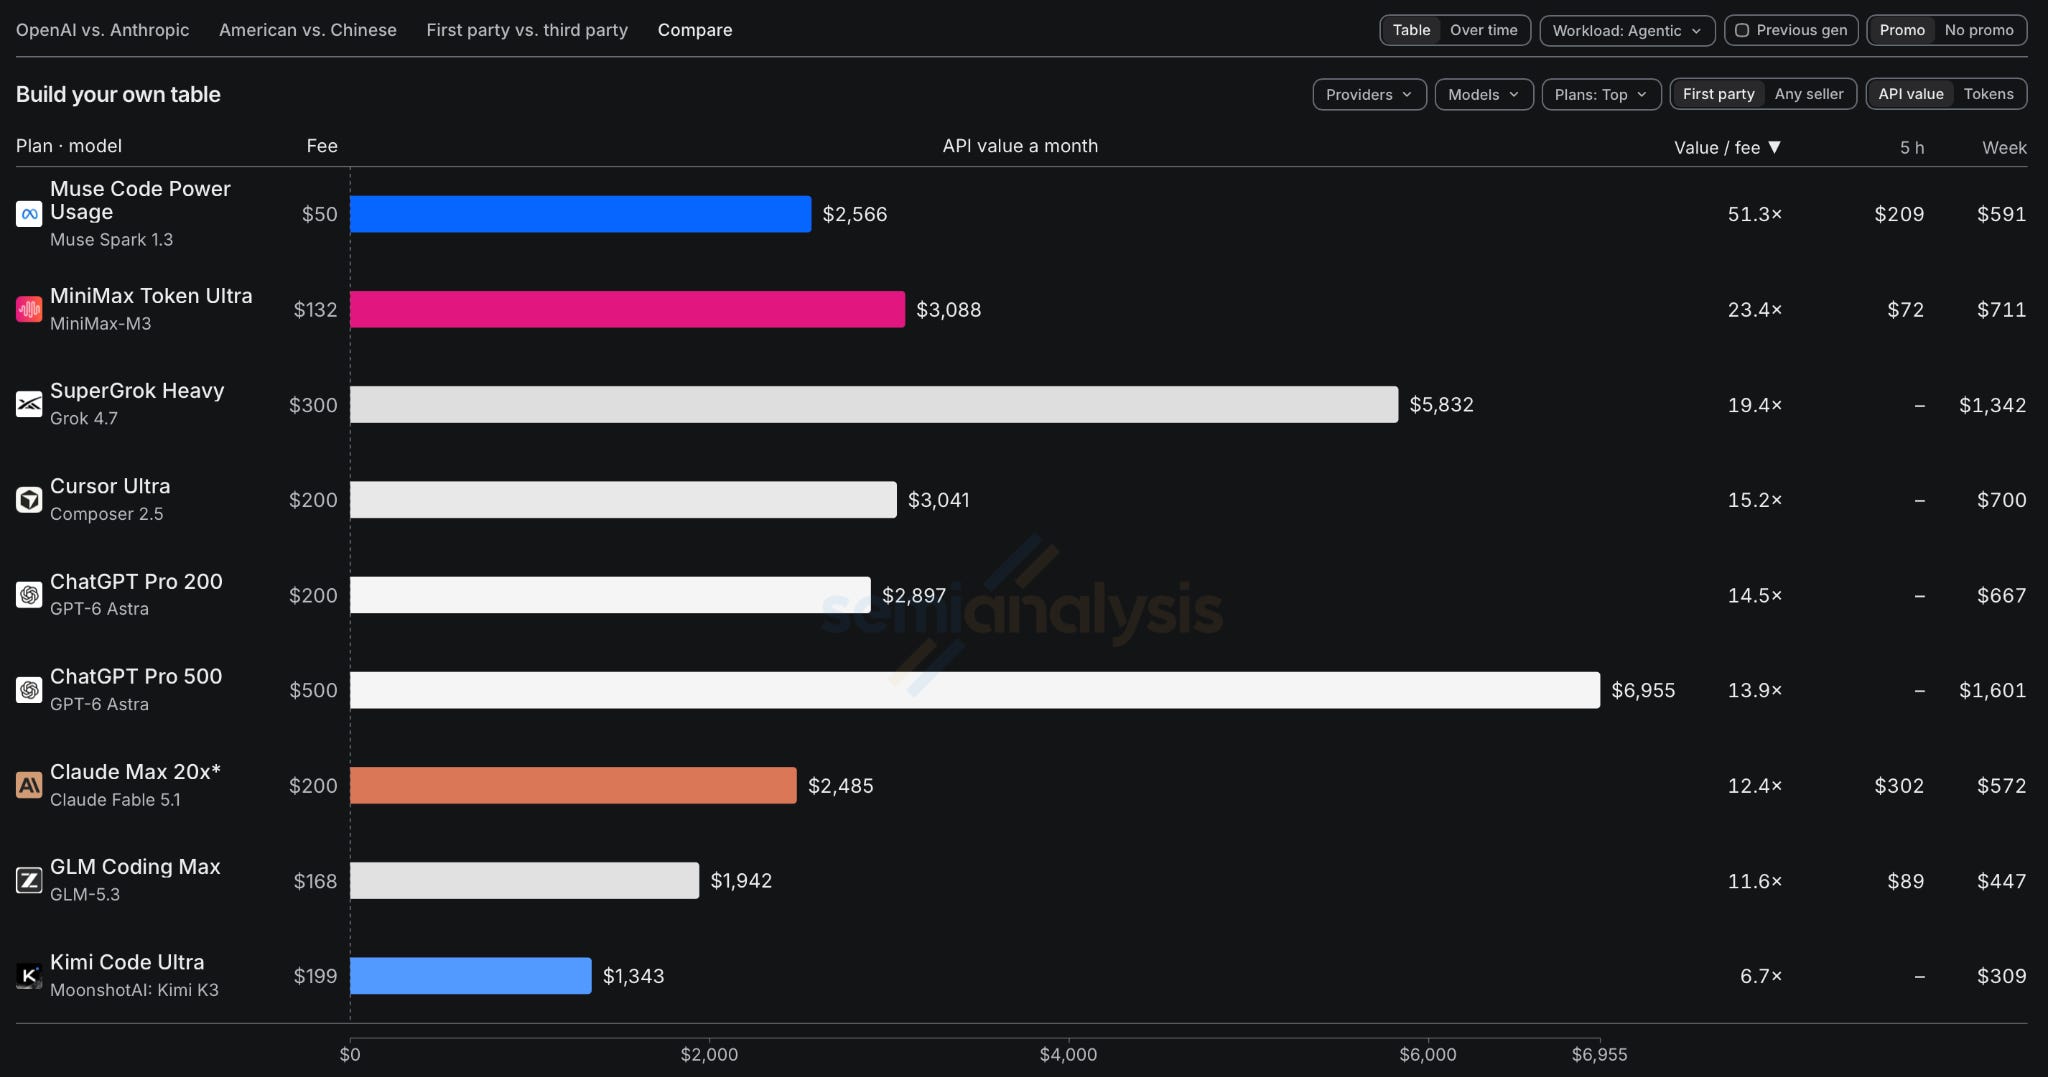
新的提供商、套餐和模型一经发布就会立即加入。本文其余部分将概述各家当前的限额。除非另有说明,下文所有 token 和美元金额均假设为智能体使用场景。
方法论
Token 通常按 MTok(百万 token)计价,涵盖以下类型:
输入:添加到 LLM 上下文窗口中且未被缓存的新 token
缓存写入:为多轮对话而缓存的输入 token。通常比常规输入 token 略贵。
缓存读取:对话中已缓存的、来自此前轮次的 token。与未缓存 token 相比通常极其便宜。
输出:模型生成的 token。最昂贵的 token 类型。
此外,部分模型对超出特定上下文窗口的 token 收取更高费用。这类模型通常会在达到该昂贵上下文窗口之前进行压缩,因此我们也将测量值保持在其之下。
订阅方案不会公开这种细粒度的定价。取而代之的是,它们在 5 小时和 7 天窗口内提供一个简单的 0 到 100% 用量计量器,有时还会为 Fable 之类的模型提供单独的计量器。订阅层级则仅通过相对于提供商其他方案的使用倍数来区分。例如,OpenAI 曾在其 20 美元的 Plus 方案中宣传“扩展的 Codex 使用量”,在 100 美元的 Pro 方案中宣传“使用量是 Plus 的 5 倍”,在 200 美元的 Pro 方案中宣传“使用量是 20 倍”,直到他们将 200 美元方案的使用量削减了一半,并从其定价页面中移除了所有相对使用量。

设置
我们通过运行实验来计算每个(方案、模型、token 类型)三元组的订阅费率,实验一次只隔离一种 token 类型,并观察模型提供商的计量器移动了多少。一个实验是使用特定提示词进行若干次重复调用,该提示词最大化一种 token 类型,同时最小化所有其他类型。
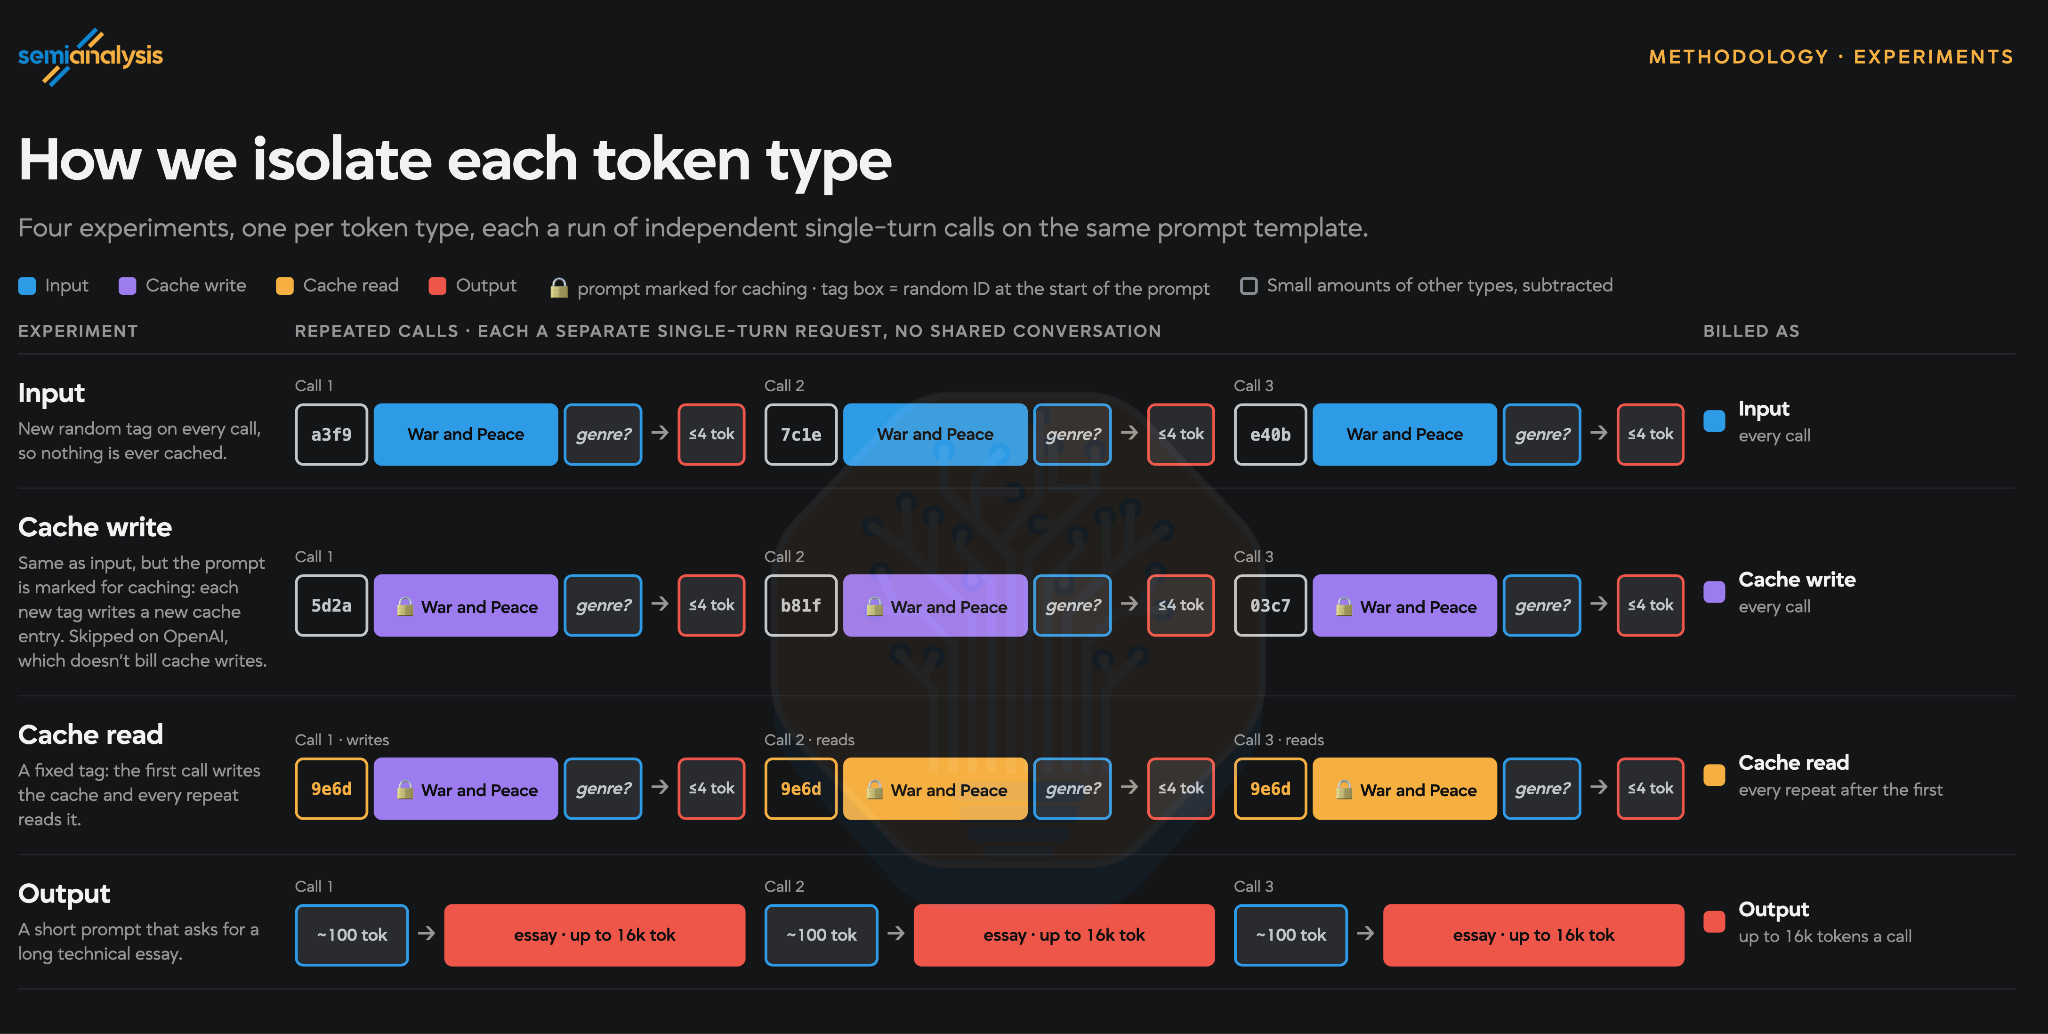
输入、缓存写入和缓存读取共享相同的提示词模板。我们使用《战争与和平》的一部分,因为某些模型在收到大段乱码时会拒绝响应。对于输入 token 实验,我们在每次调用时使用随机标签,以确保不会发生缓存。缓存写入实验的运行方式相同,但提示词被标记为可缓存,因此每个新标签都会强制生成新的缓存条目。缓存读取实验使用固定标签,因此第一次调用写入缓存,之后每次重复都会读取它。
对于输出 token 实验,我们使用一篇技术文章来强制产生长输出,因为模型会拒绝“将 SemiAnalysis 重复 100,000 次”这类机械式提示词。
计算结果
对于每次调用,我们记录两件事:提供商计费的每种类型的 token 数量,以及用量计量器的读数。将其转化为价格需要三个步骤。
1. 测量每种 token 类型的费率
提供商通常通过以固定增量移动的计量器来报告用量。这可以是一个完整的百分点、一个额度、一美分等……单次请求通常根本不会移动计量器,因此无法直接测量单次请求的成本。
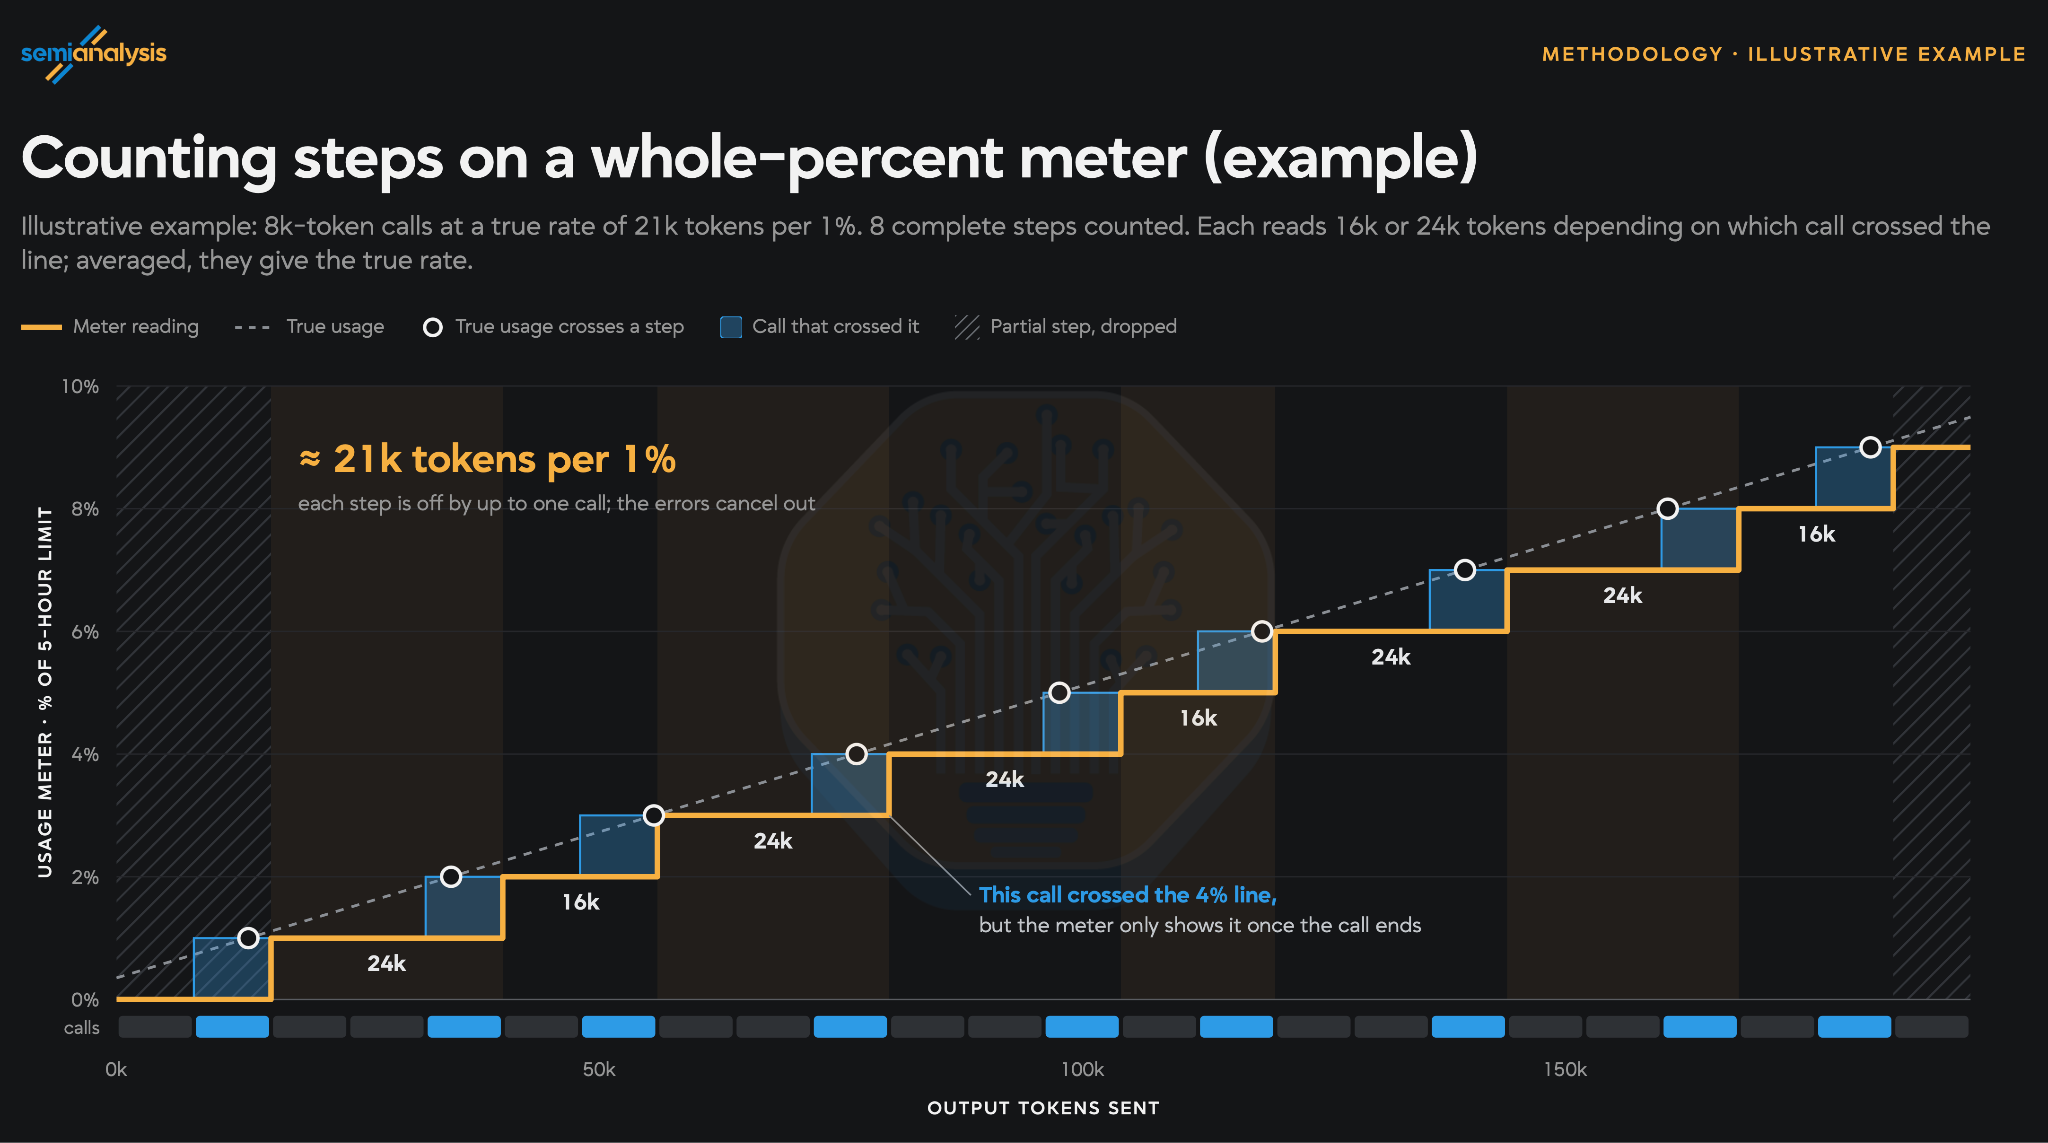
相反,我们按步测量。随着请求运行,我们持续累计已使用的 token 总数。每当计量器上升时,我们就存储该总数。两次计量器移动之间使用的 token 构成一步,即计量器移动一个单位的成本。
我们丢弃两个不完整的步骤。当运行开始时,计量器已经处于其下一次移动的途中,因此第一次移动之前的 token 不足一整步,会使费率看起来高于实际值。最后一次移动之后的 token 永远无法完成一步,因此我们也将其丢弃。
为了得到费率,我们将计量器在完整步骤中移动的总量相加,再除以这些步骤中使用的 token 数。提供商对输入、输出和缓存 token 的收费不同,因此我们为每种类型分别计算费率。
注意事项:
由于我们每个请求只能看到一次计量表,单步的误差最多可达一个请求。这些误差不会随着连续步数增加而累加,因此我们跟踪的是一个区间而非单一数值,且统计的步数越多,区间越窄。我们持续增加步数,直到区间落在 ±5% 以内,然后报告所有这些步数的速率。
没有哪个请求只包含一种 token。例如,某些套餐要求每个请求都附带一组指令。我们使用为其他类型测得的价格来扣除这部分额外用量。
在某些套餐上,从缓存读取几乎不产生费用,甚至可能完全不会让计量表变动。如果在 500M 缓存读取 token 之后计量表仍未变动,我们就假定缓存读取是免费的。
2. 将速率转换为每窗口和每月的 token 数
在每个请求之后,我们都会读取套餐显示的每一个计量表。这可能是一个 5 小时限额、一个每周限额,对于 Fable 这类模型还有其自身的每周限额。因此,每种 token 类型在每个计量表上都有一个价格。这表示一百万 token 会消耗该限额的多少。根据每个价格,我们算出能容纳多少 token,例如,如果一百万 token 消耗了某个限额的 5%,那么整个限额可容纳 2000 万。
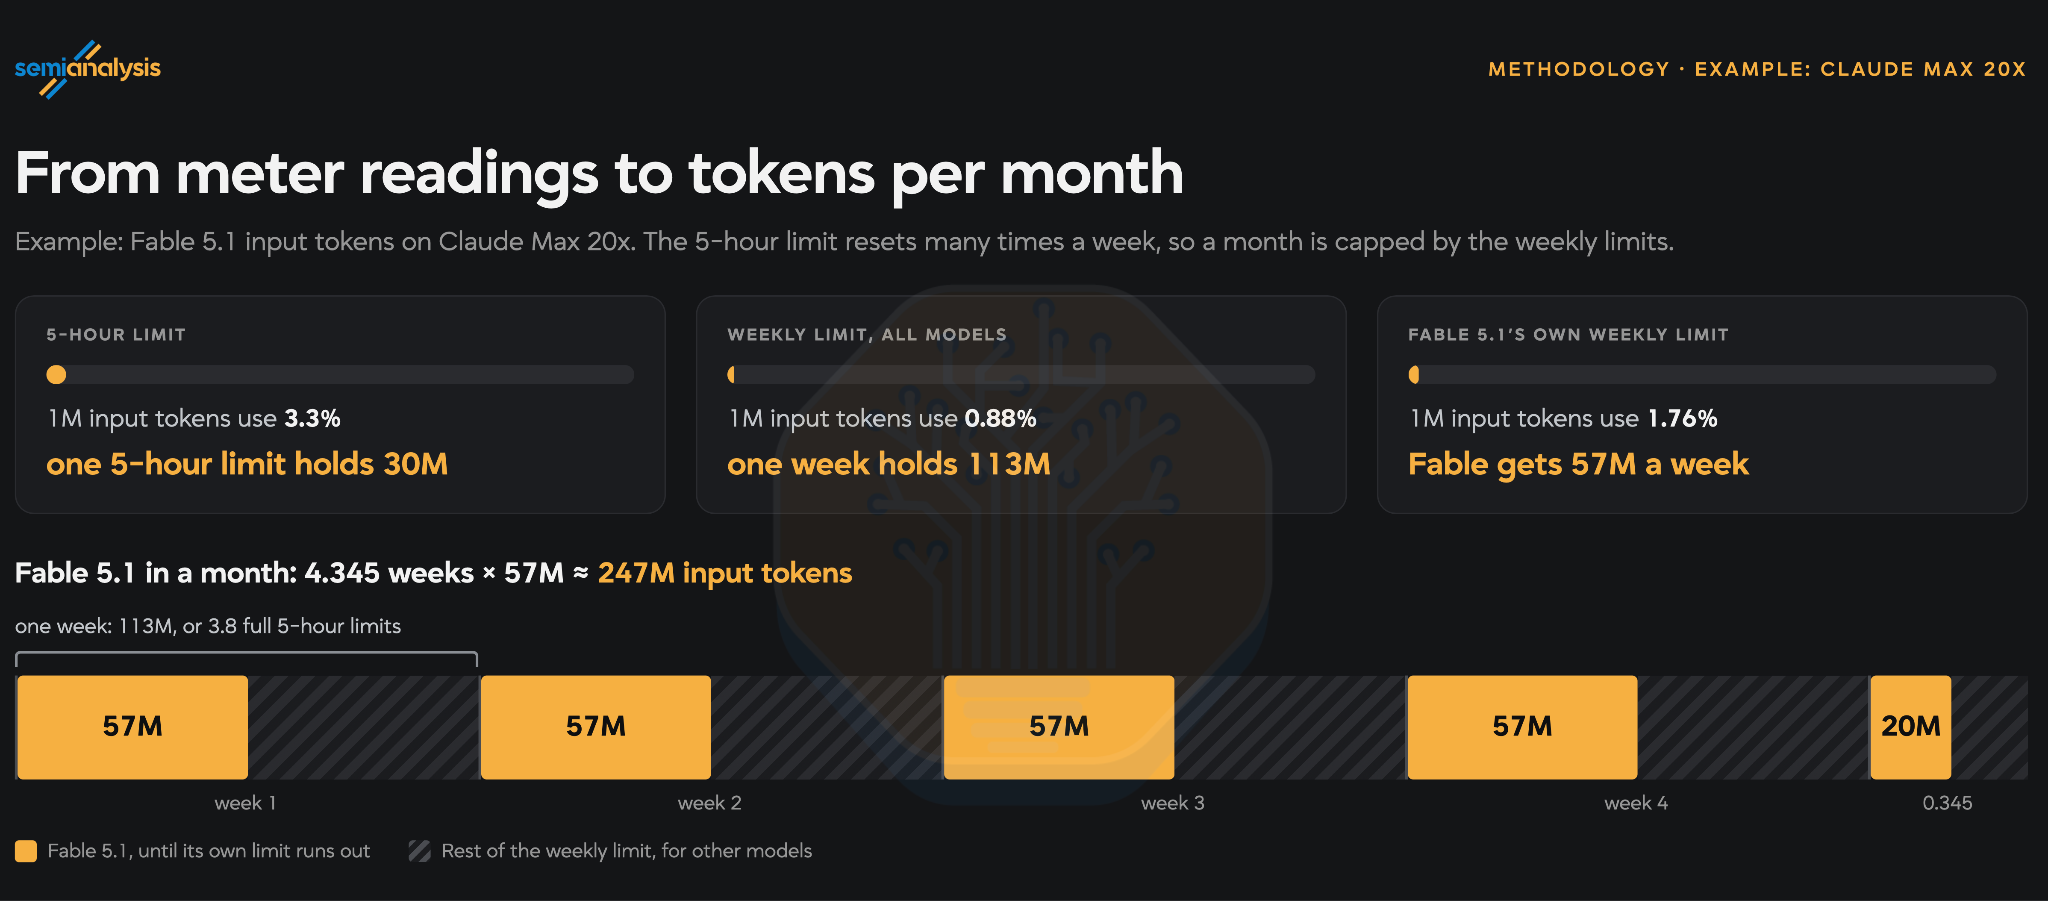
5 小时限额在一周内会重置多次,因此一个月的上限受每周限额约束。
3. 定价
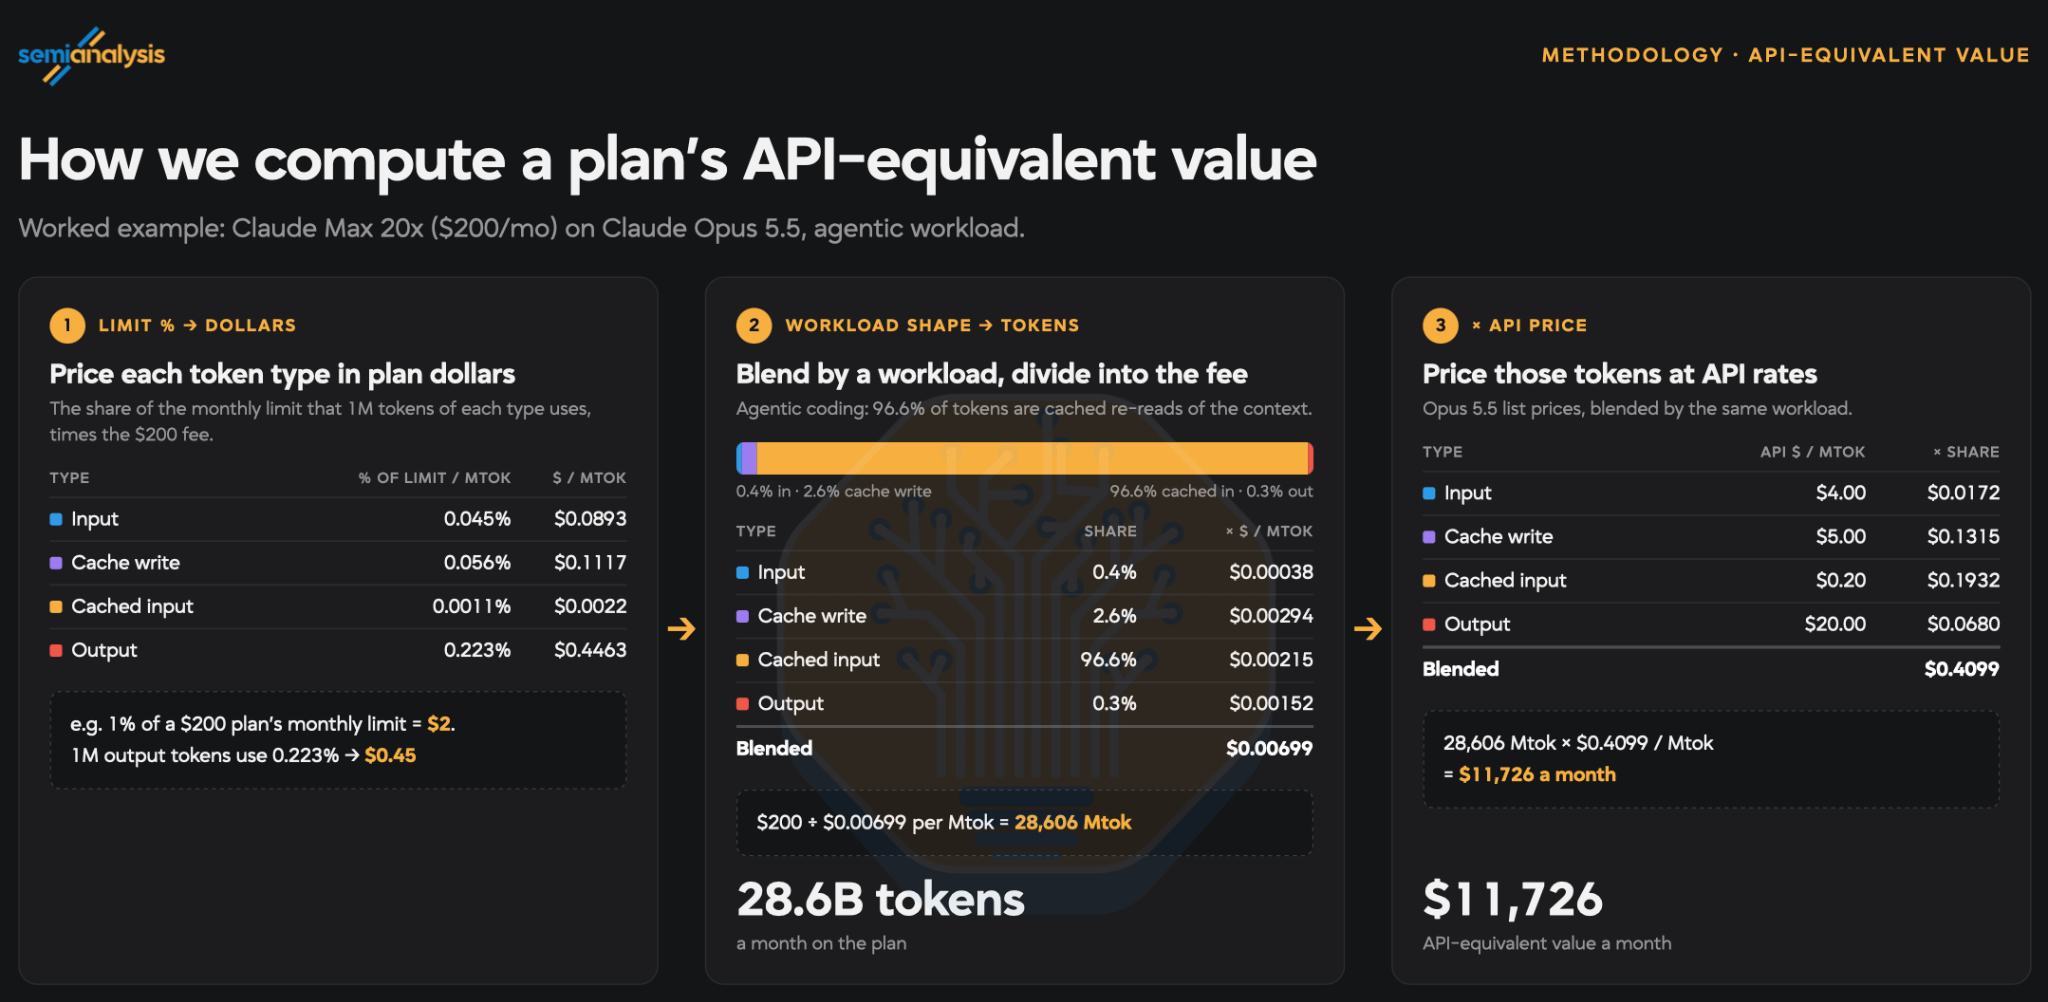
最后,我们通过将每种类型的一百万 token 所消耗的限额百分比换算成美元金额,来计算 API 等效价值。例如,如果你消耗了 200 美元套餐月度限额的 1%,那就是 2 美元。
然后,我们假设一种工作负载形态,并根据这一比例计算每个套餐总共能获得多少 token。对于智能体工作负载,我们使用我们自己在 9 月的使用比例,如我们的 Tokenomics Model 中所报告的那样。
最后,我们乘以按 API 价格计算的每 MTok 混合价格,得到 API 等效价值。
发现服务商的 A/B 测试
在完善我们的方法时,我们遇到了一个非常令人困惑的情况:我们为某个服务商测试的同一订阅中,3 个里有 1 个的限额比其他 2 个低约 20%。这个不走运的账户恰好也明显更老,我们担心该服务商存在某种奇怪的设置,会根据账户年龄改变订阅限额。
幸运的是,在联系该服务商后,我们得以确认情况并非如此,我们那个不走运的账户只是他们正在进行的“极小规模”限额 A/B 测试的一部分。此外,他们想强调他们“并非只是整体下调限额”,而是在测试“如何更好地平衡人们触及限额的时机”。
这个结论之所以有趣,有两个原因:
它证明服务商可以在任何时候悄悄更改订阅限额
我们的方法足够灵敏,能够检测到这些细微的变化!
OpenAI 与 Anthropic 对比
AI 订阅领域最大的问题是 Anthropic 的限额与 OpenAI 相比如何。请注意,OpenAI 上周刚对其订阅做了一些重大调整,将 200 美元套餐的 API 等效价值减半,并推出了新的 500 美元档位。以下数字描述的是 OAI 与 ANT 的当前状态。之后,我们将深入探讨 OpenAI 近期的变化。
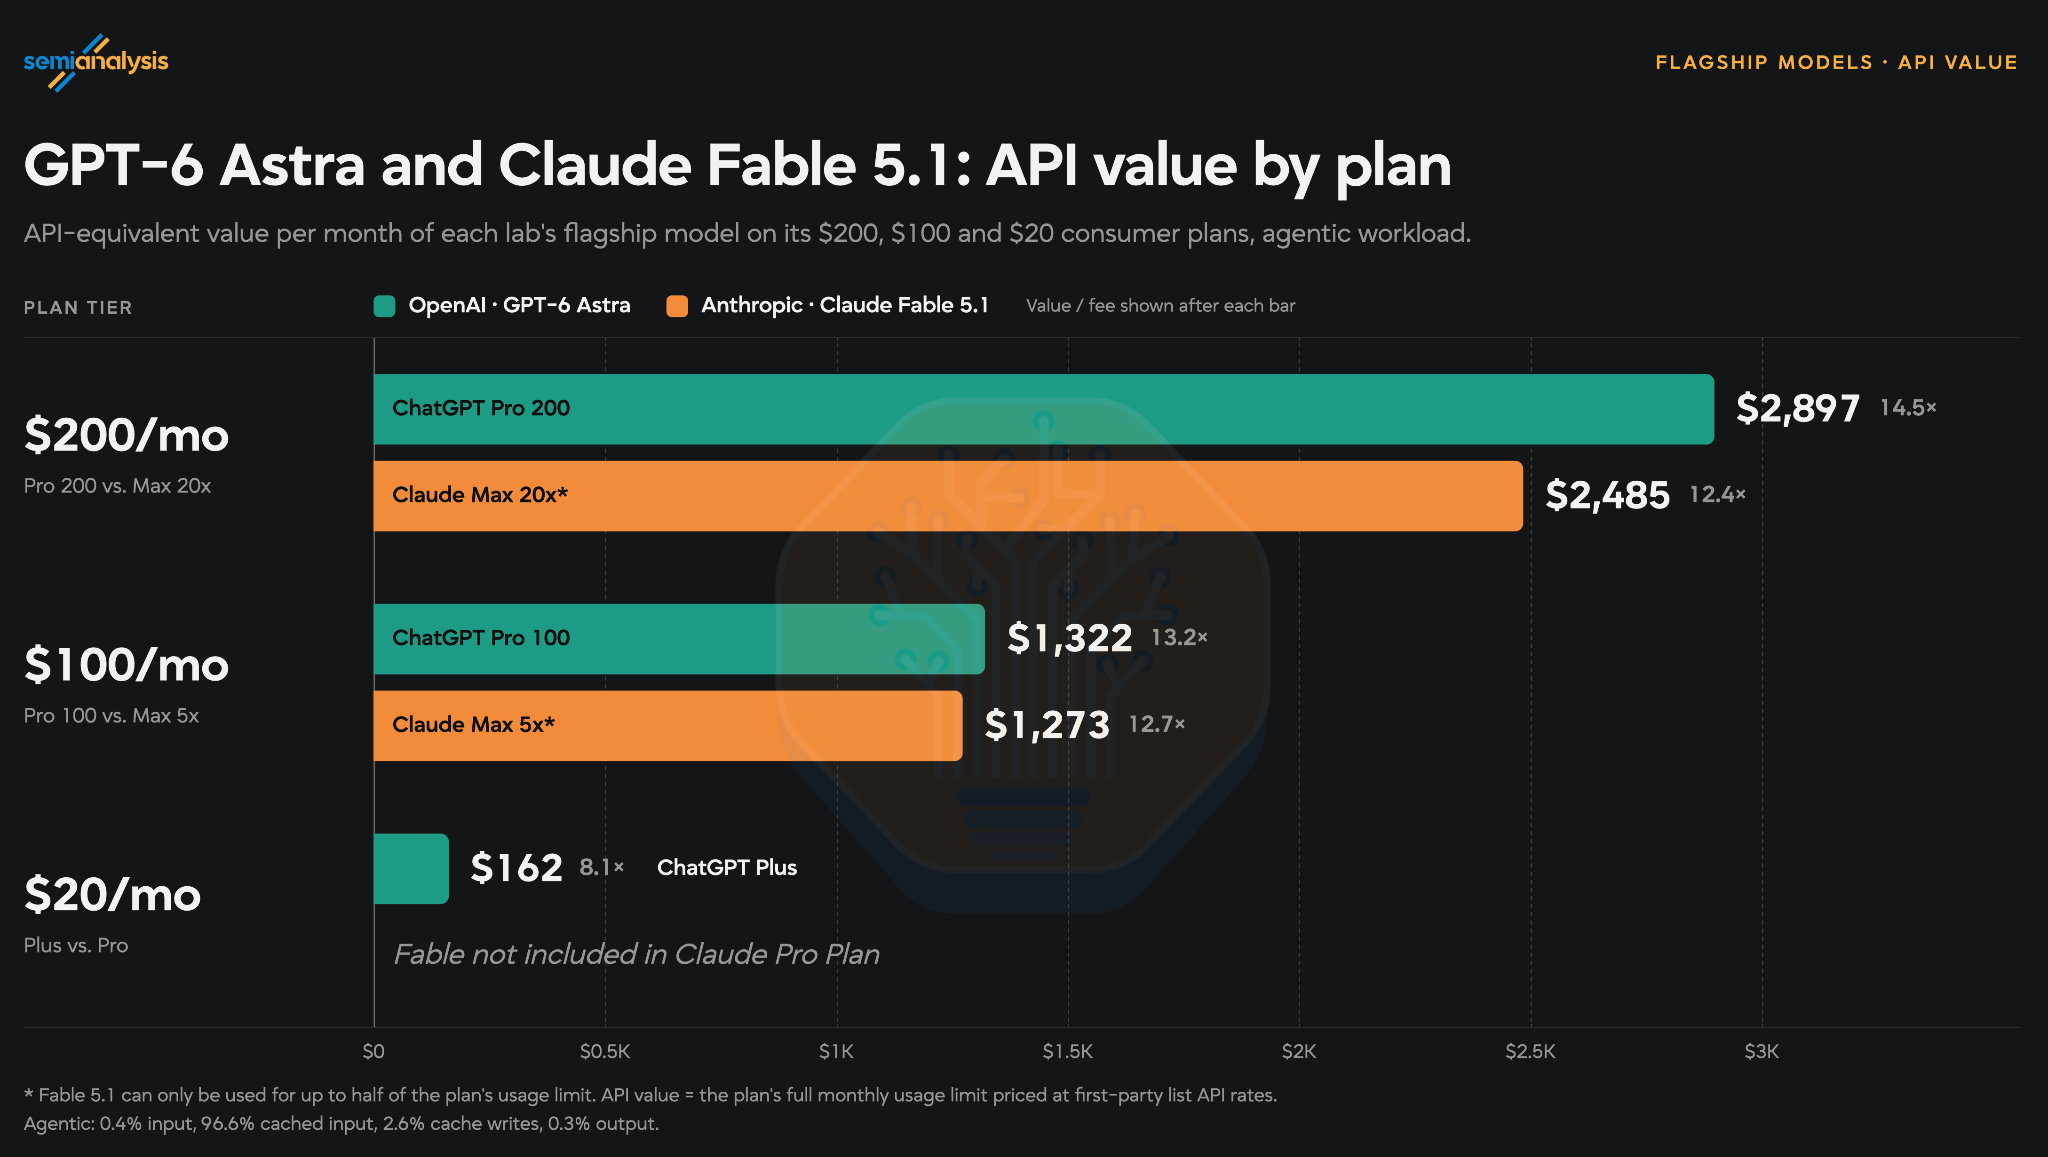
GPT-6 Astra 与 Fable 5.1 的限额整体上相当接近,但请记住 Fable 只能使用你限额的 50%。换句话说,你的 200 美元 ANT 套餐在消耗掉价值 2,485 美元的 Fable 5.1 后仍会剩下 50%,而同等价位的 OAI 套餐在消耗 2,897 美元的 Astra 后就会完全用尽。
当我们比较 Opus 5.5 与 GPT 6.1 Sol 时,这额外的 50% 就开始变得非常重要。
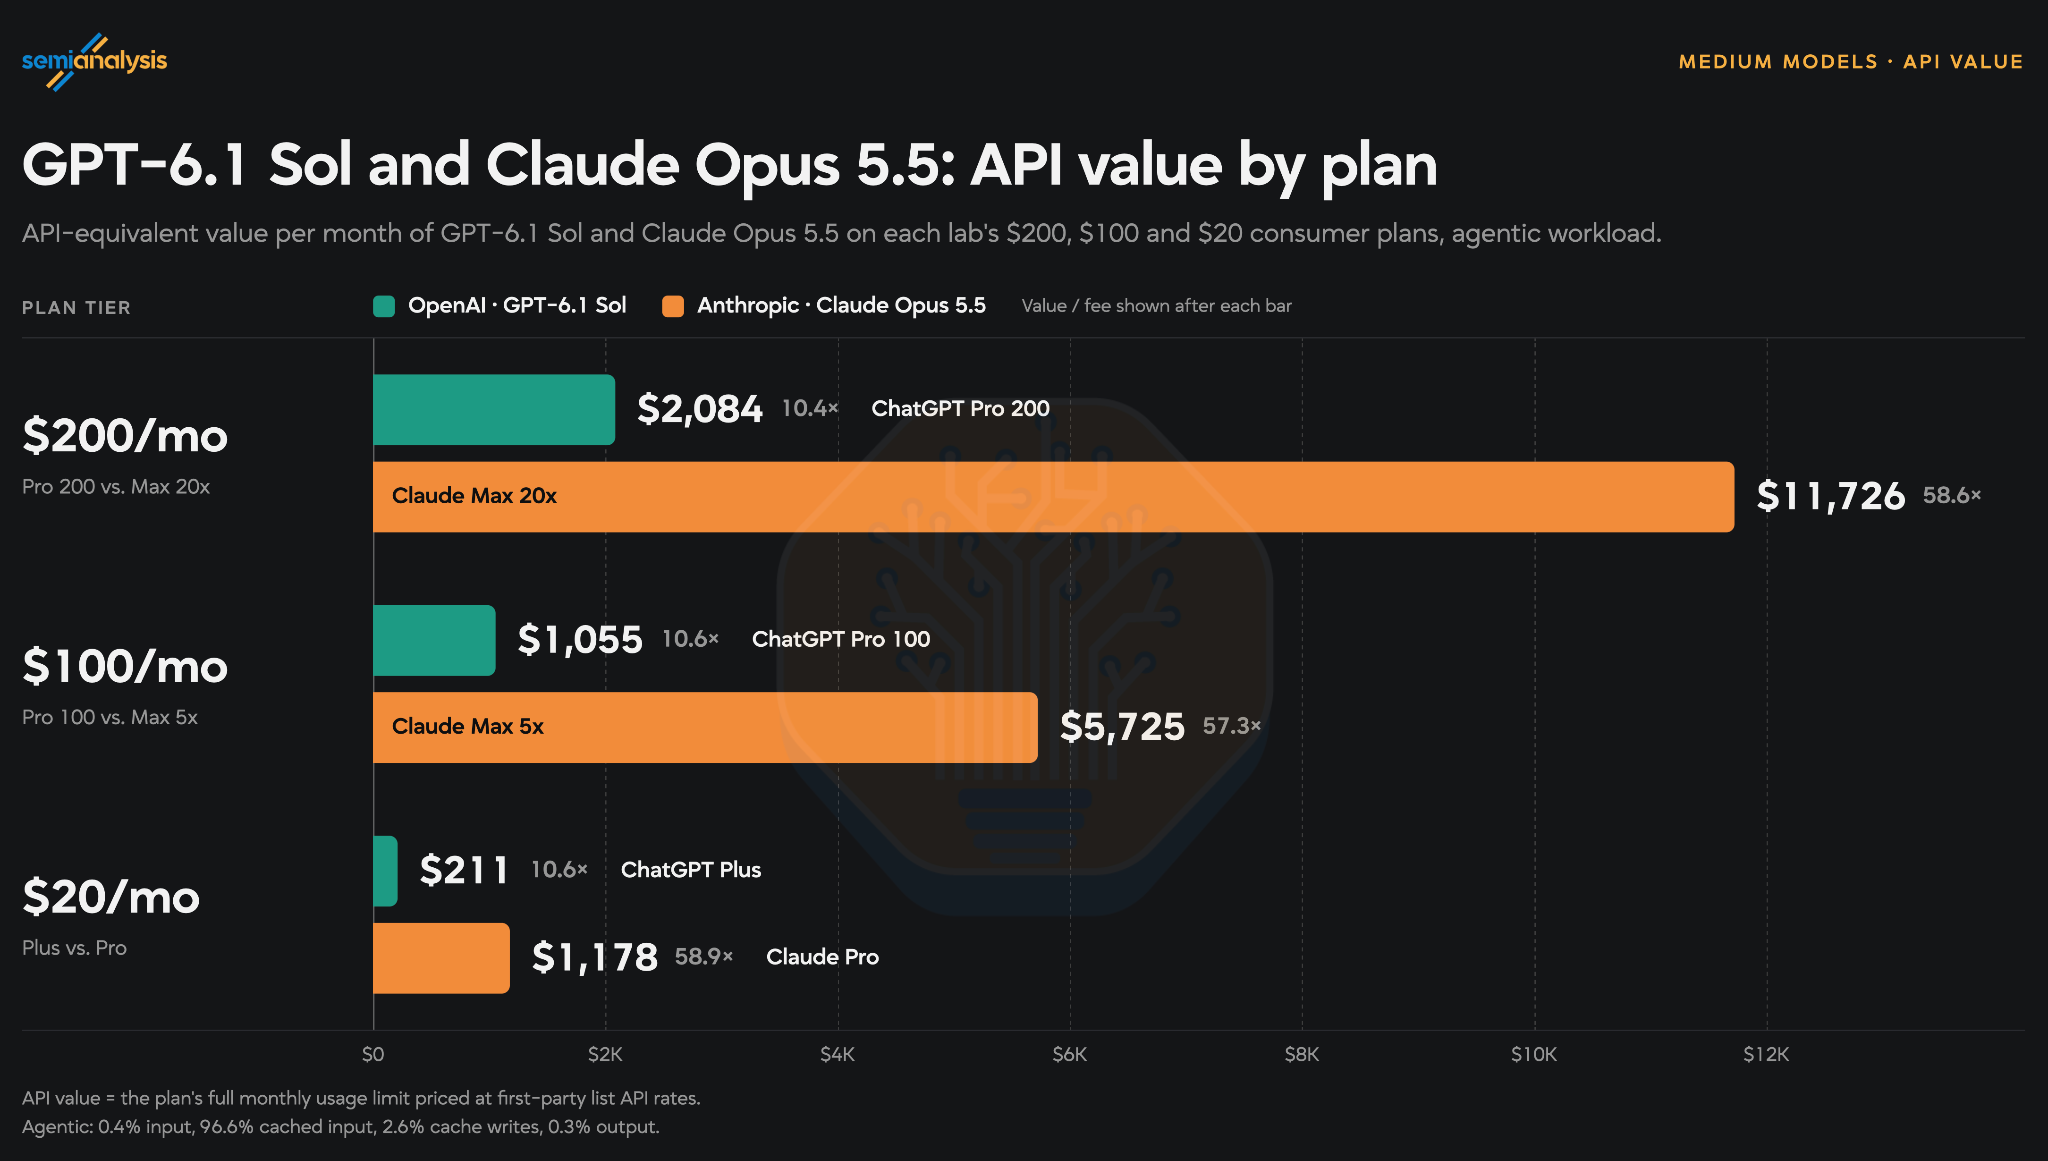
在这一中端模型层级——两家公司都将其宣传为面向大多数用户的主力日常模型——Anthropic 的性价比压倒性地更高,整体上提供约 5 倍的 API 等价价值。你可能会说这对 OAI 不公平,因为 6.1 Sol 每 token 比 Opus 5.5 便宜得多,但即使改用 token 数量来比较,差距依然巨大。
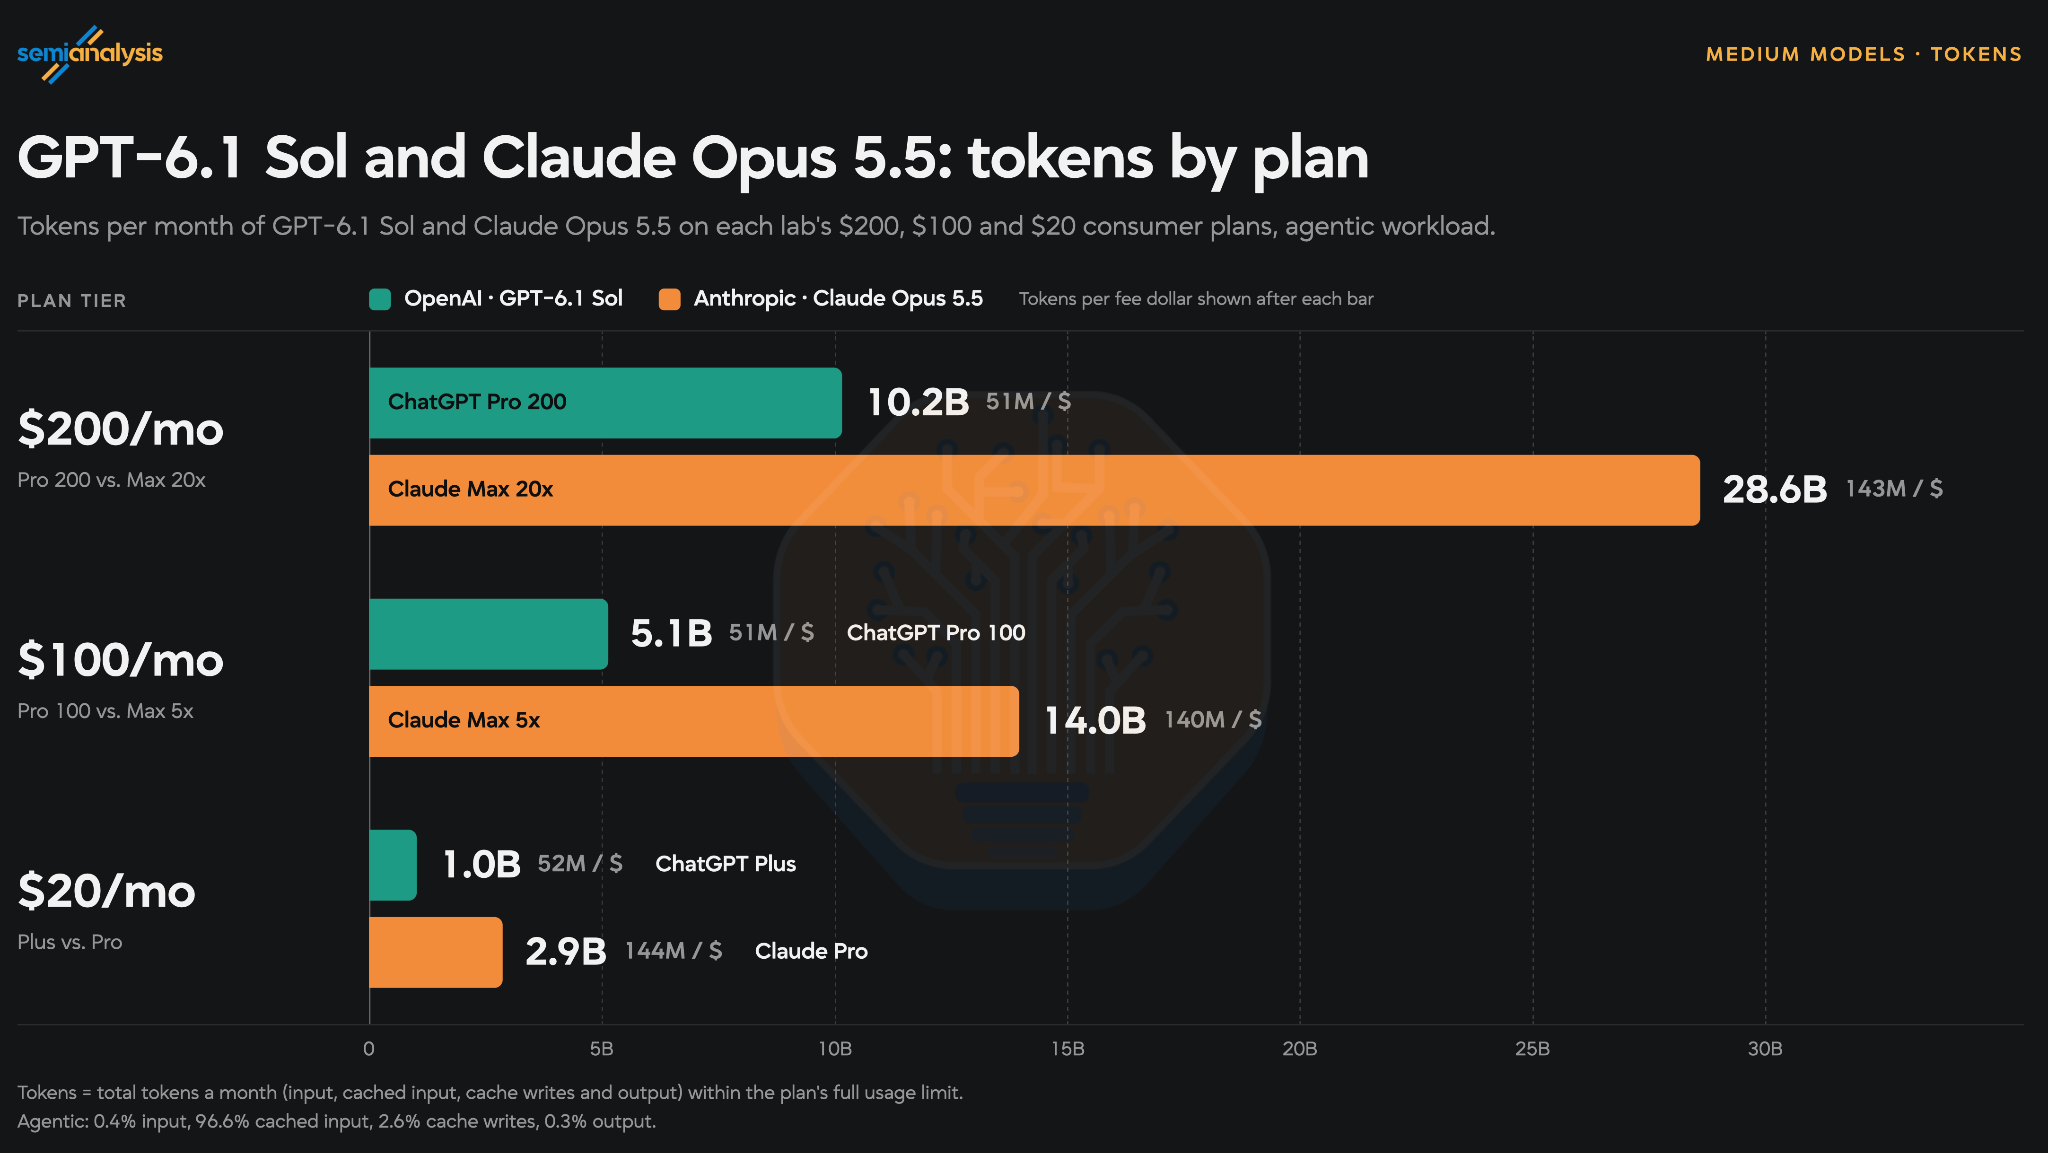
总体而言,我们认为 API 等价价值是衡量订阅套餐“价值”的最佳单一指标,但有时原始 token 数量可能更合适。例如,如果某个模型在 API 价格下特别不划算(或特别划算),那么 API 等价价值当然会产生误导。
Token 效率也是一个极其相关的因素,但遗憾的是业界缺乏这方面的可靠数据。许多人喜欢引用 Artificial Analysis 的这张图表,但我们认为 AA Intelligence Index 中的基准任务完全不能代表人们使用 LLM 所做的实际工作。
OpenAI 新的 500 美元套餐与大幅限额削减
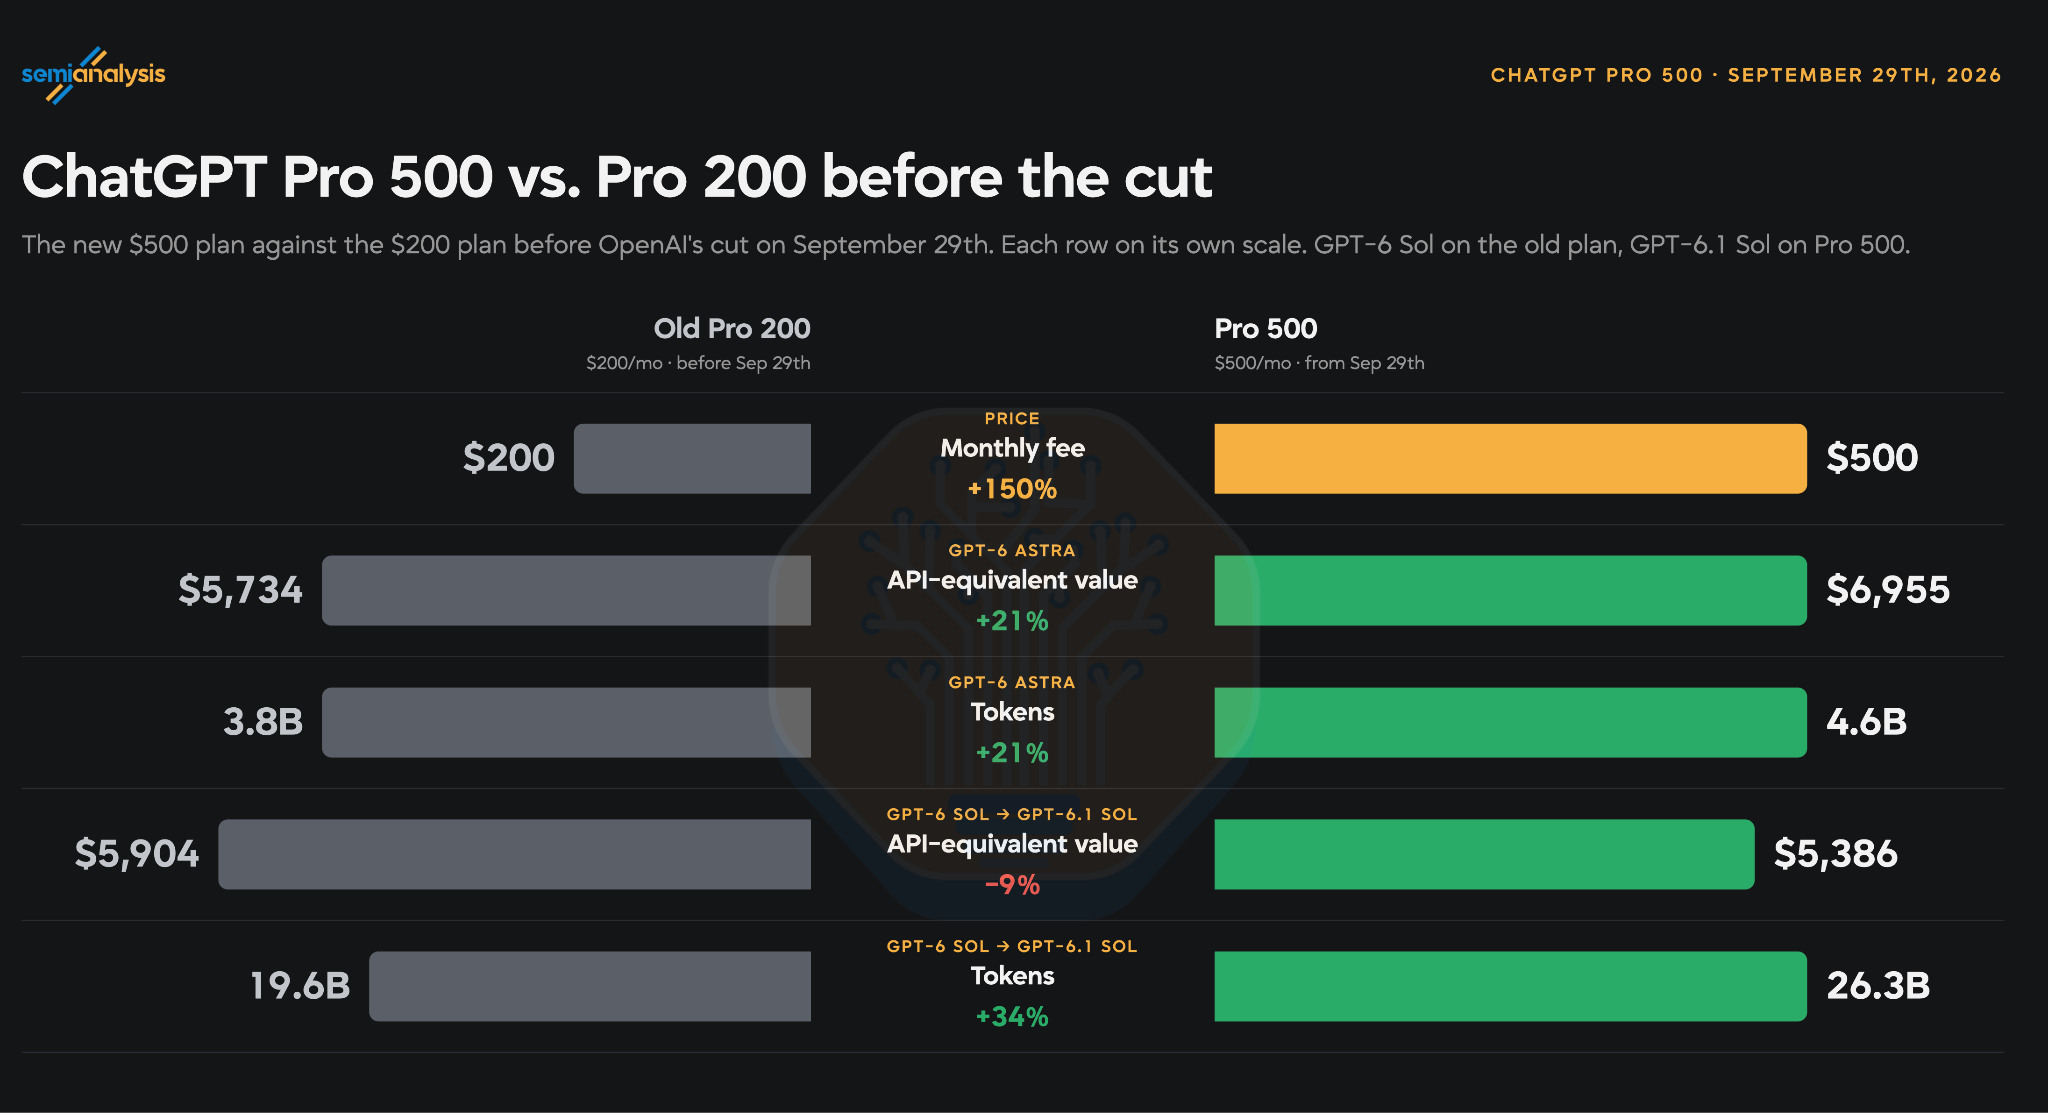
我们的追踪证实了 Tibo 所宣布的 OpenAI 200 美元套餐价值削减 50% 的消息。在削减前购买的 200 美元套餐将保留原有的较高限额直至 10 月 29 日,但新购买的套餐会立即以较低的限额开始。
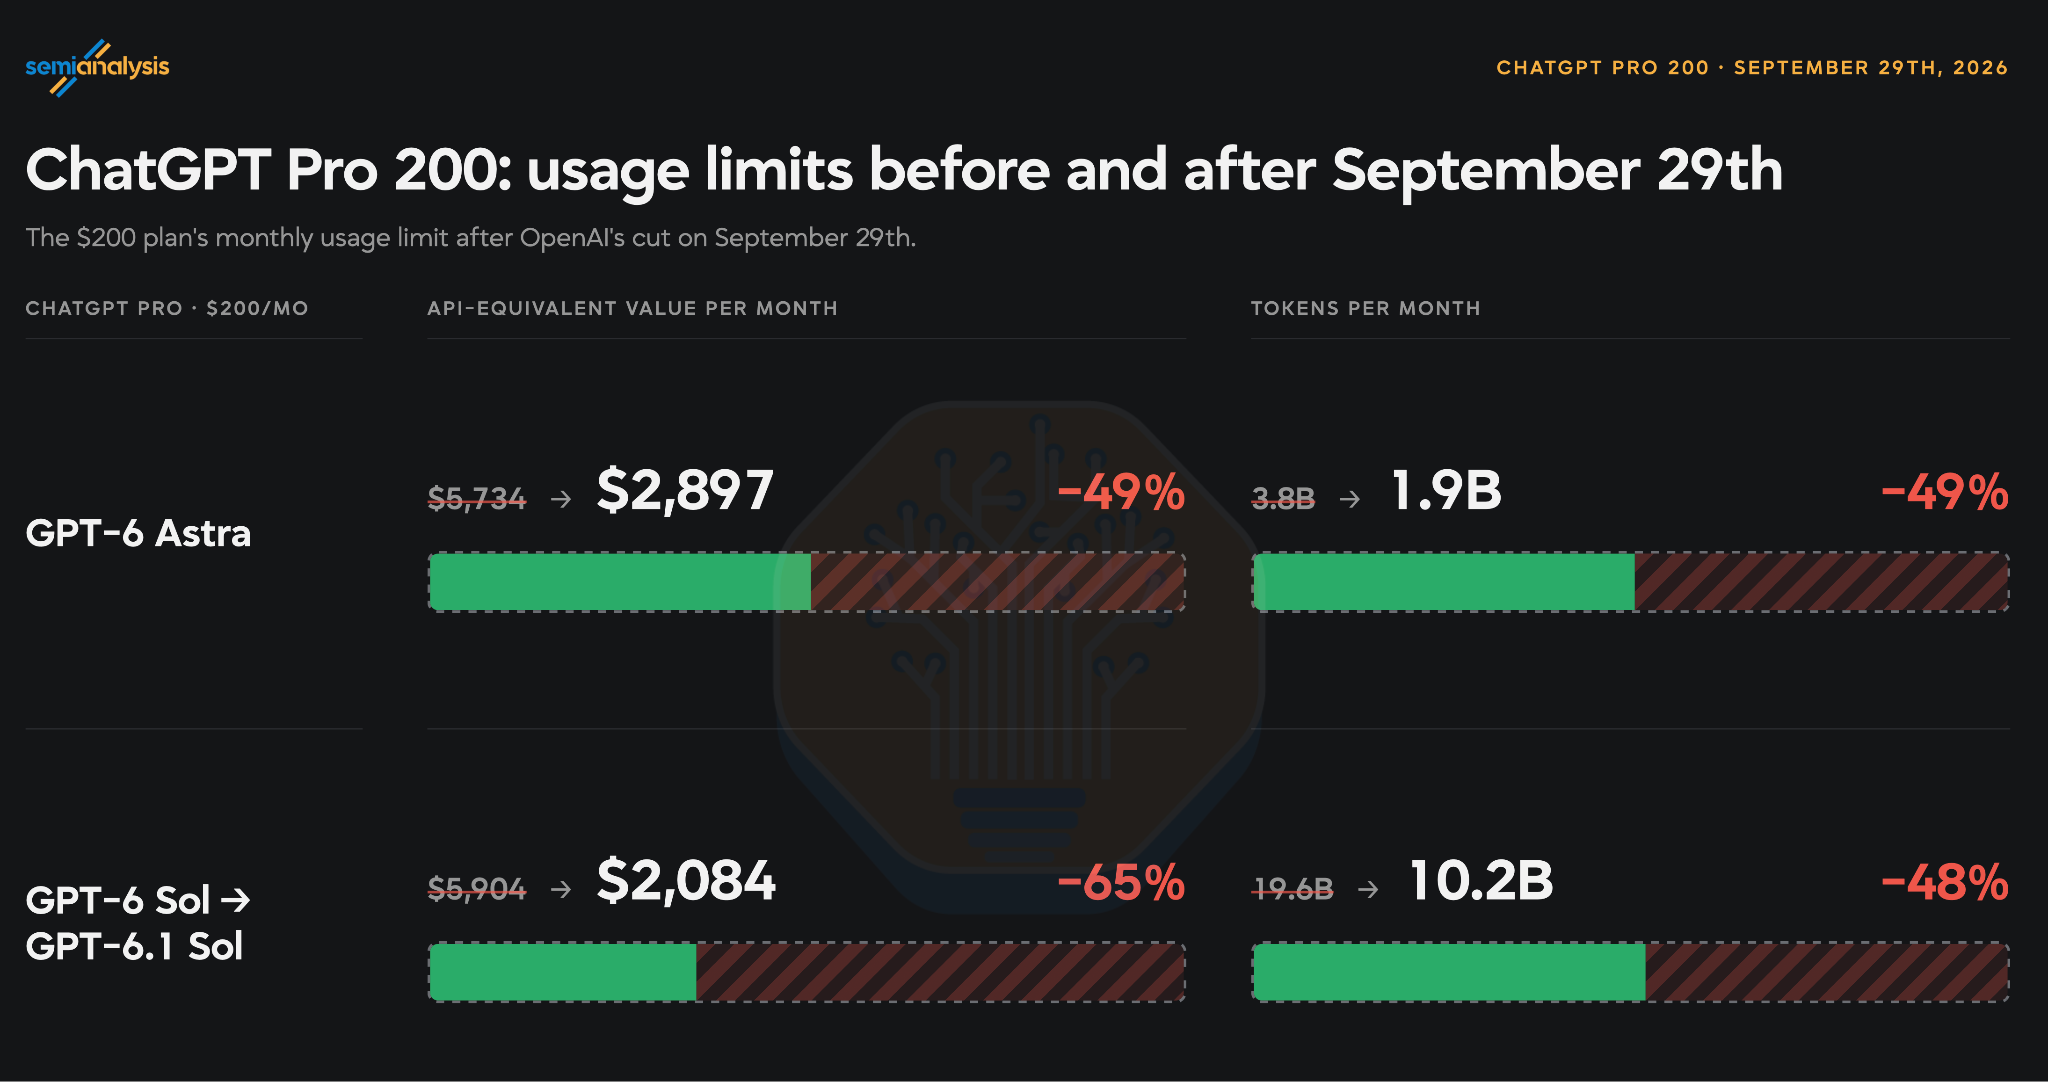
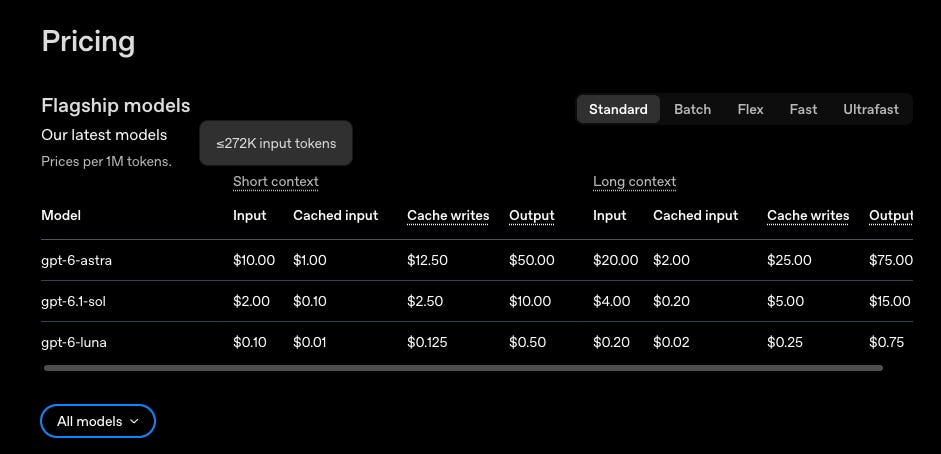
如你所见,OpenAI 专门将每个模型层级可获得的 token 数量减半。这导致 Sol 级模型的 API 等价价值下降超过 50%,因为 OAI 还下调了 6.1 Sol 的缓存输入 token 价格。
新的 500 美元套餐仅比旧的 200 美元套餐多提供 21% 的 Astra。有趣的是,由于前述 6.1 Sol 的降价,Sol 级模型的 API 等价价值实际上反而下降了。
当然,300 TPS 的 Ultrafast 才是 500 美元套餐真正的头条功能,我们目前正在测试其极限。结果一旦可用,就会发布给 Tokenomics Model 的订阅者。我们也在积极测试在 Devin 等第三方应用中使用 ChatGPT 订阅时的限额。
200 美元/月的套餐过去也比 OpenAI 的其他订阅补贴力度大得多。如果我们把每个(套餐、模型)组合按 API 等价价值和每美元 token 数进行归一化,可以看到 Pro 100 在 Astra 上提供的每美元价值约为 Plus 的 2 倍,而 Pro 200 在所有模型上又在 Pro 100 的基础上再翻约 2 倍。
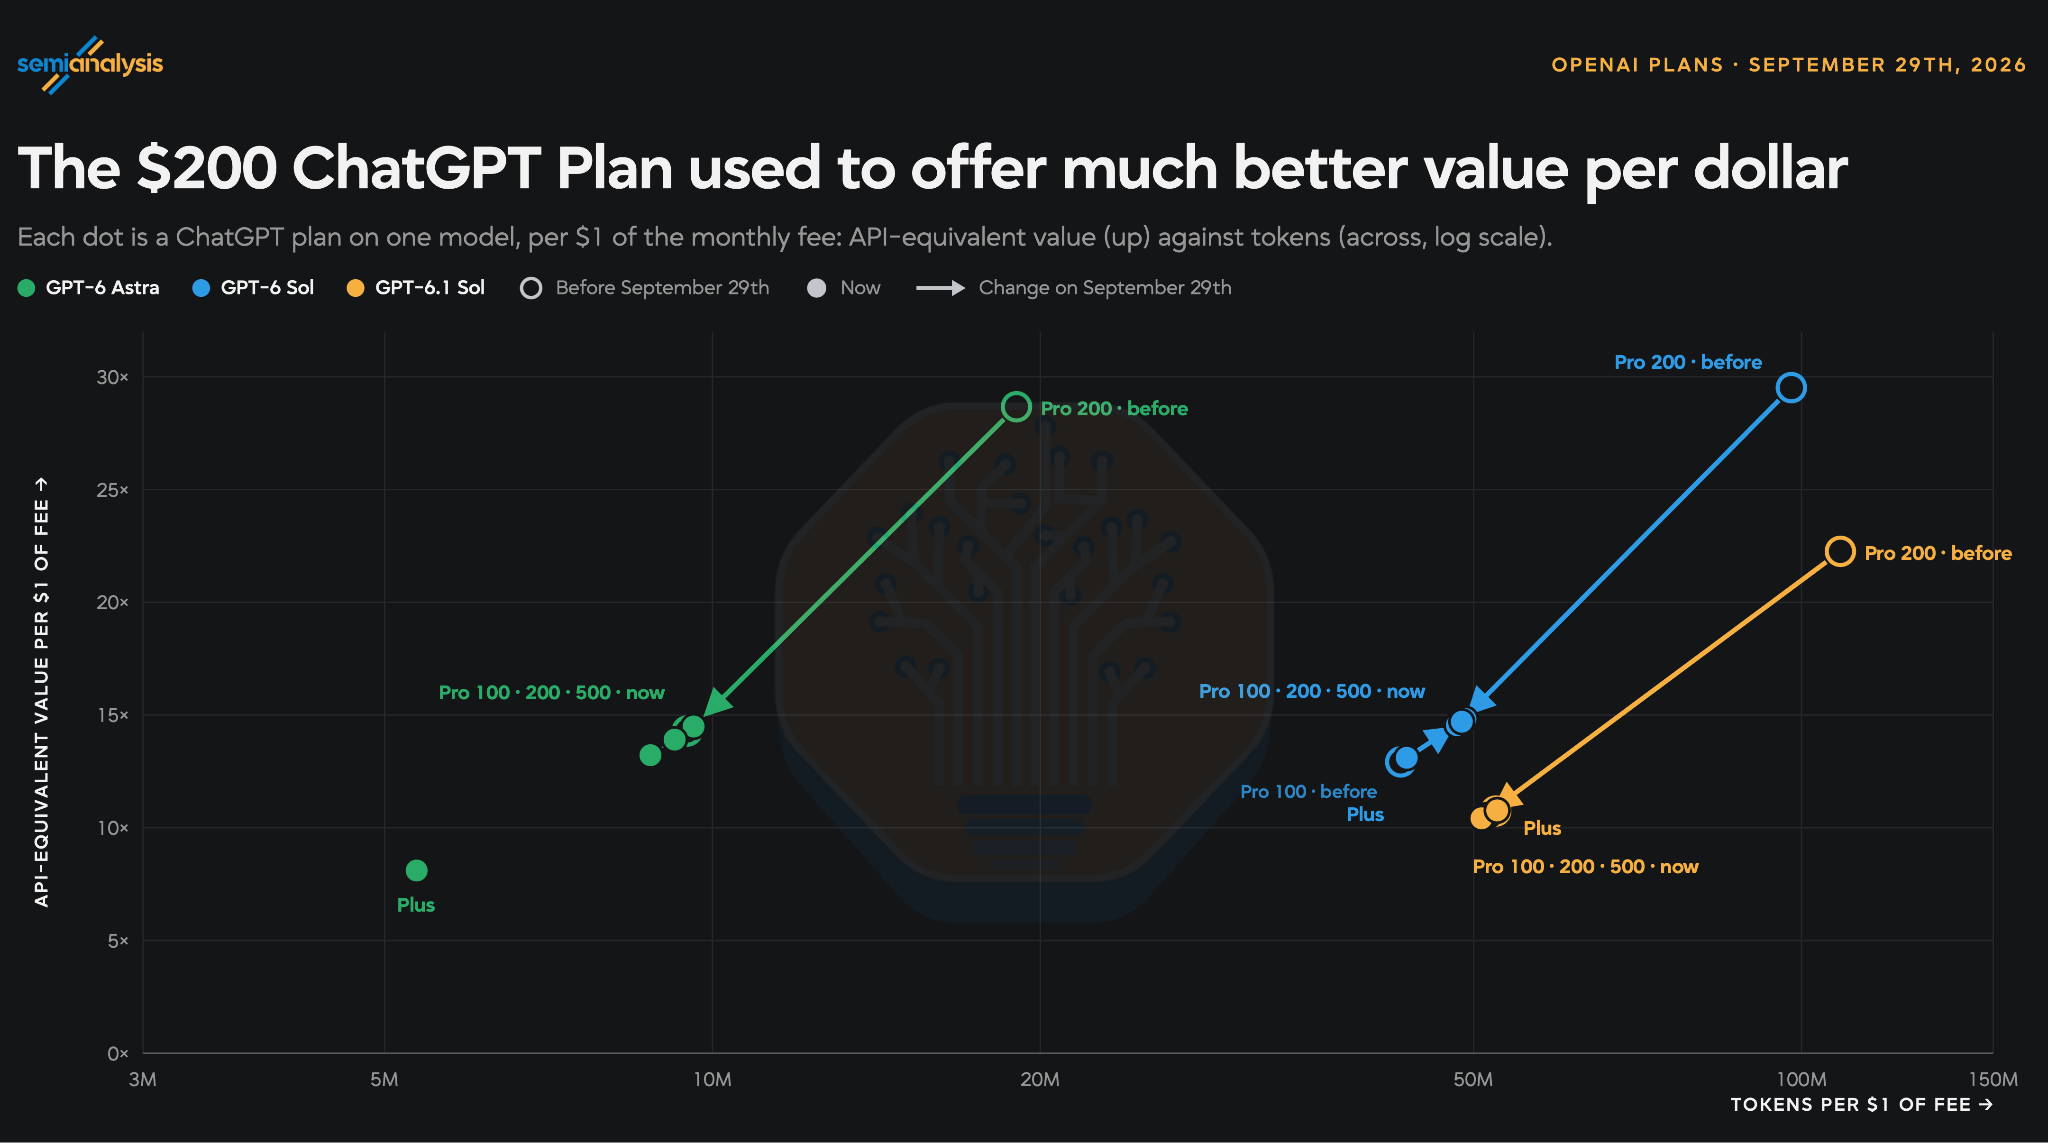
随着上周的削减,Pro 100、200 和 500 在每个模型上的每美元 token 数都相同了。Plus 在 Sol 上也与之相当,但在 Astra 上相对更不划算。
另一方面,Anthropic 早已为其所有订阅层级提供相同的每美元价值,目前正全面碾压 OpenAI。
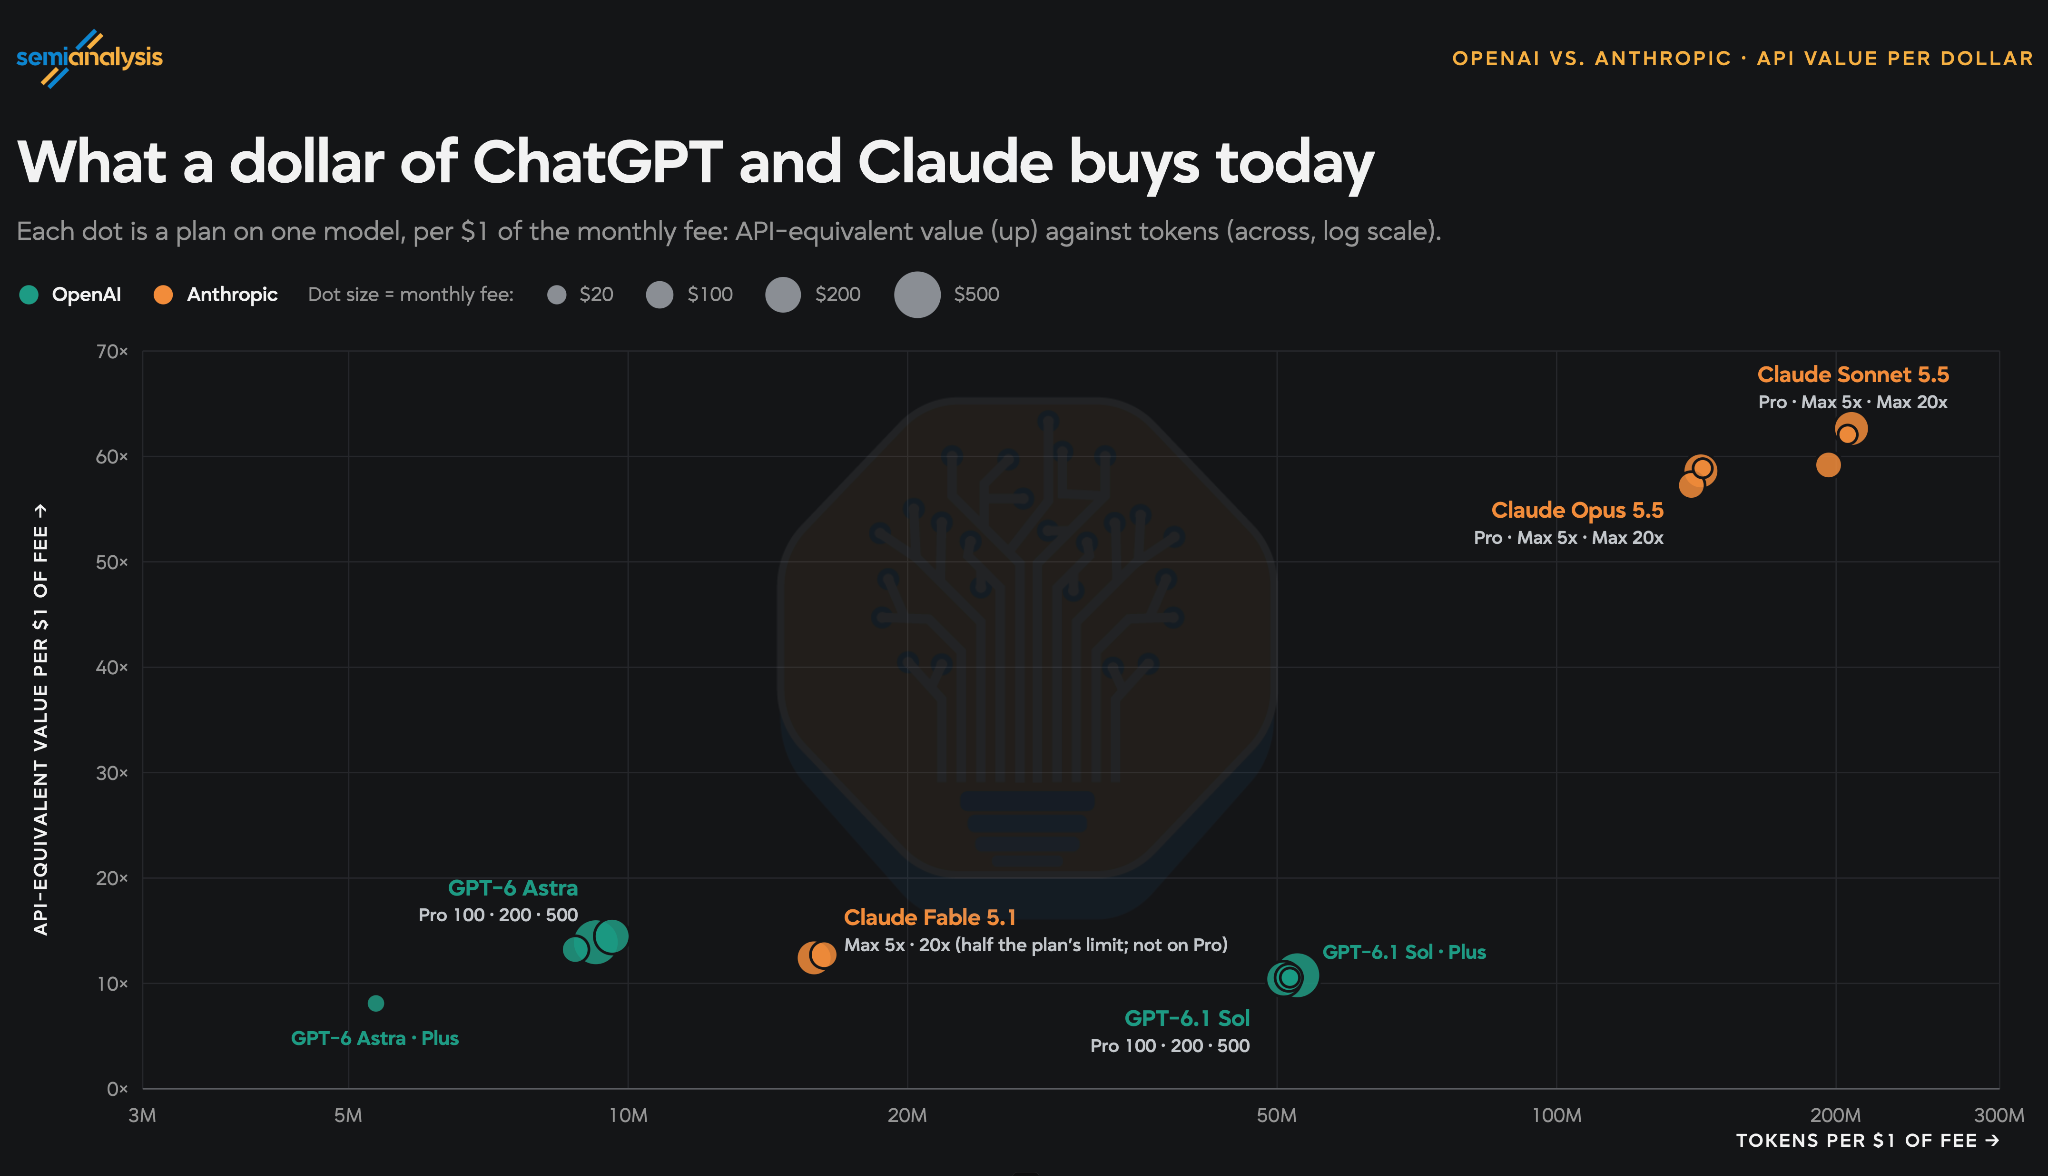
OpenAI 曾因相比 Anthropic 更为慷慨的订阅额度而受到独立开发者的赞誉,但如今这已不再属实。在任何 Claude 订阅方案上,Opus 5.5 提供的价值都远超 OpenAI 的任何产品。
对 OpenAI 的唯一反驳论点是,他们的 Pro 方案都没有 5 小时限制,这使得更容易消耗掉每月总限额中更高比例的部分。然而,我们认为这并不能抵消 Opus 5.5 在 Claude 方案上所提供的约 4 倍更高的 API 等价价值。
实验室会根据 API 定价变化调整订阅限额吗?
我们最近看到 Anthropic 和 OpenAI 的模型出现了一系列大幅降价。
Fable 5.1 相比 Fable 5 将缓存读取降低了 75%
Opus 5.5 相比 Opus 5 将输入和输出 token 定价降低了 20%,缓存读取降低了 60%。
GPT 6.1 Sol 相比 GPT 6 Sol 将缓存读取降低了 50%。此前已将 GPT 6 Sol 相比 5.6 Sol 降价 60-67%。
一个重要问题是,实验室在这些降价后是否会调整 token 限额,从而使订阅的 API 等价价值保持不变。
我们此前已经展示过,OpenAI 在发布 6.1 Sol 时并未改变每月 200 美元方案上的 Sol token 限额。这导致 API 等价价值下降了约 30%。
Anthropic 在发布 5.1 时也完全没有提高 Fable 的 token 限额,但他们确实在 5.5 降价时提高了 Opus 的 token 限额。
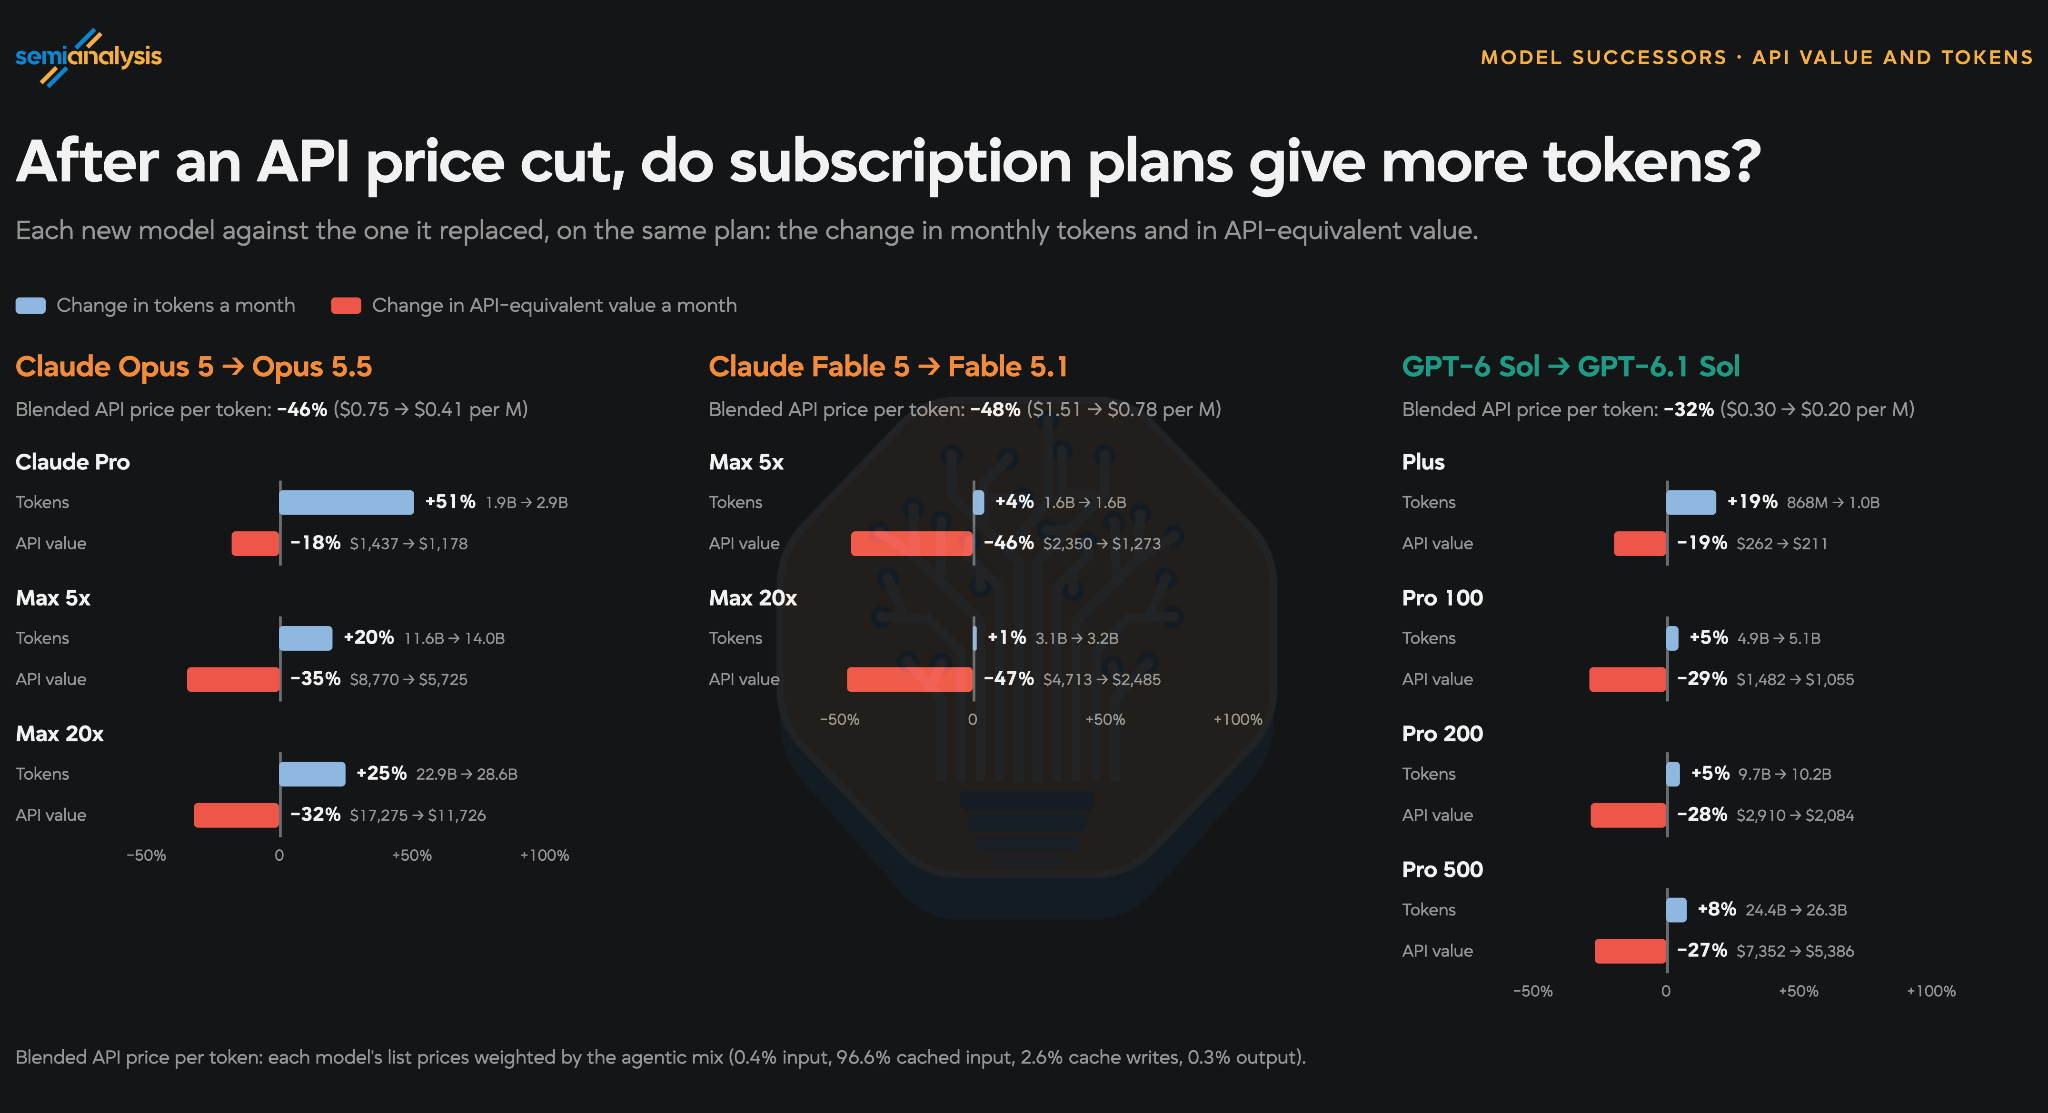
然而,Max 方案约 20% 的 token 增加和 Pro 方案约 50% 的增加,并不足以完全抵消 API 降价。
提高订阅利润率的两种不同方式
正如我们在本文开头所解释的,订阅毛利率远低于 API,并显著降低了 OpenAI 和 Anthropic 每 MW 的收入。两家公司都清楚这一事实,但选择了两种不同的策略来减少订阅补贴。
对于给定方案,Anthropic 会降低更高端模型的 API 等价价值。Sonnet 5.5 与 Opus 5.5 之间的降幅很小,但到 Fable 5.1 时就变得非常显著。
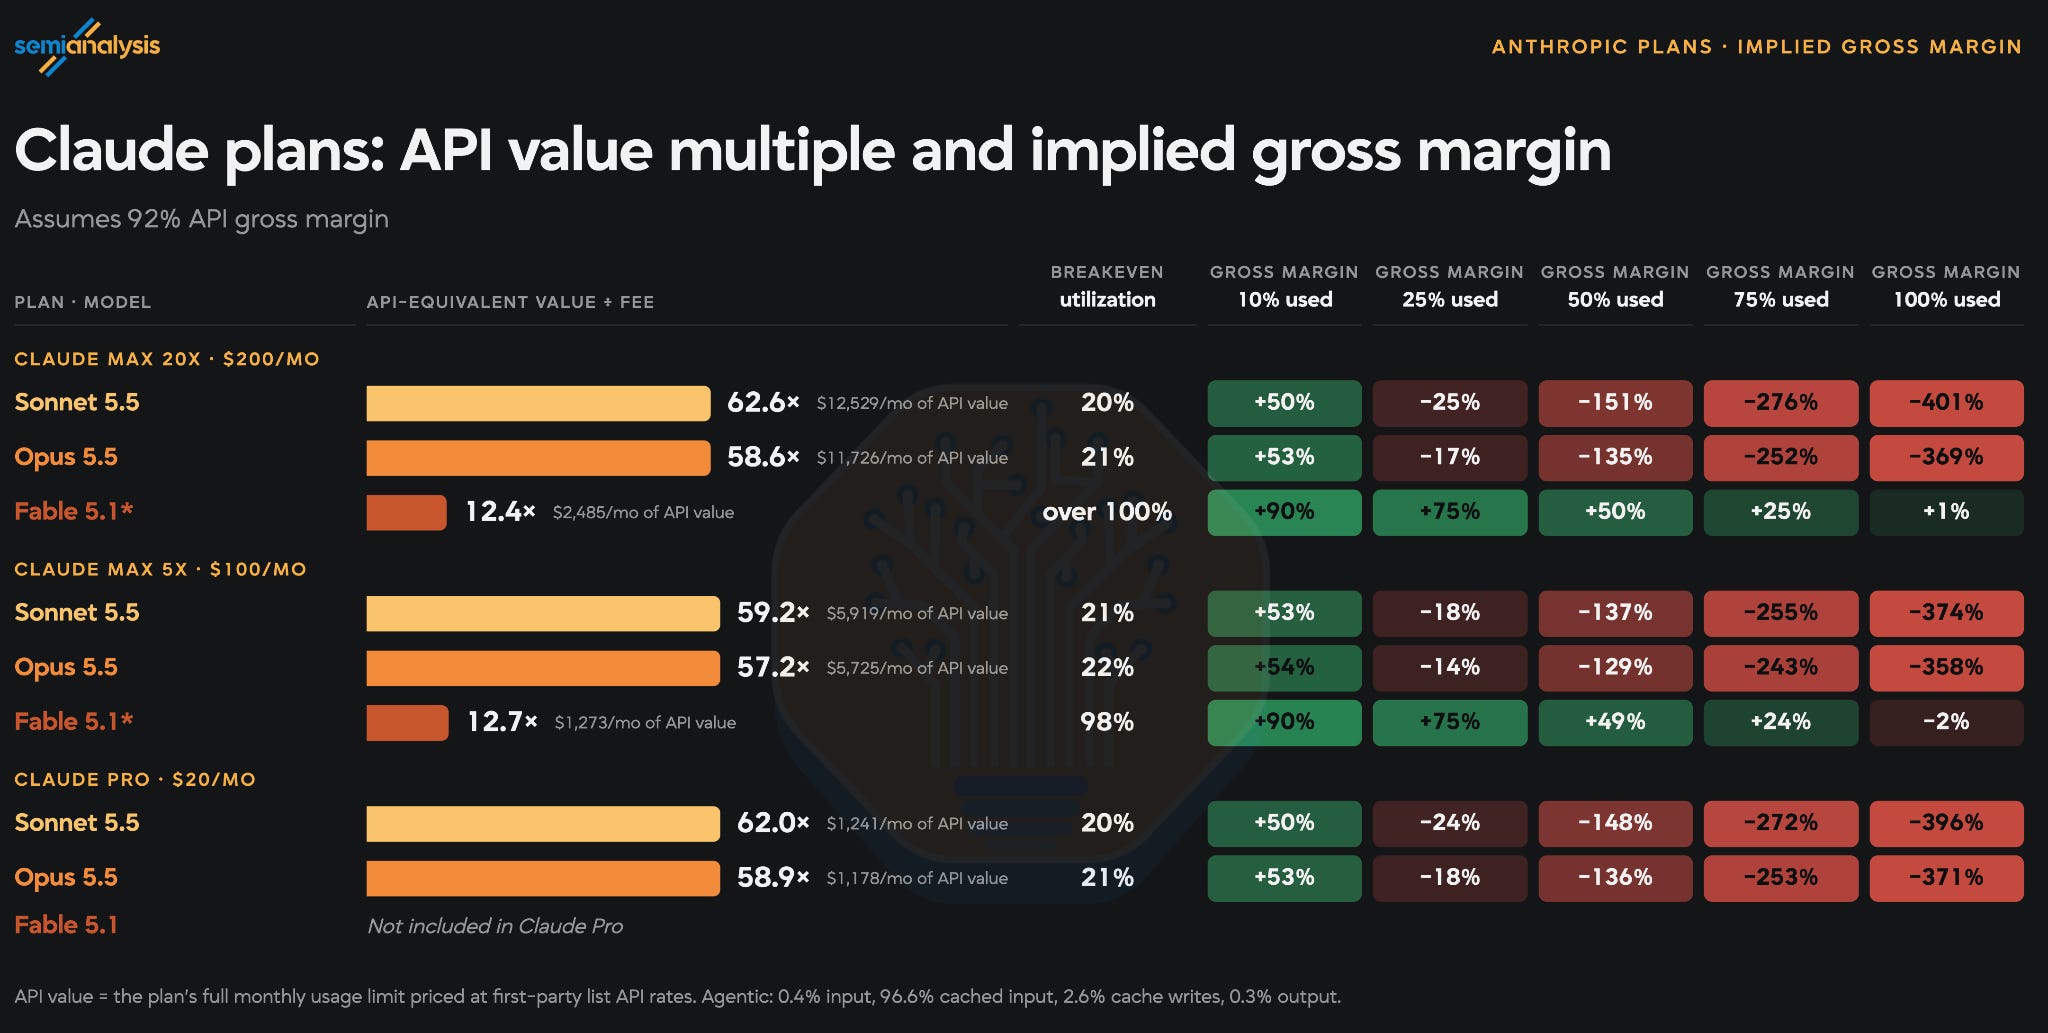
随着你以更高的标价发布更强大的模型,降低 API 等价价值是一种更隐蔽的停止补贴订阅的方式。假设 100% 利用率和 92% 的 API 毛利率,将 Opus 5.5 与 Fable 5.1 的使用量用满,分别对应 -369% 和 1% 的毛利率。如果我们采用更现实的 20% 平均利用率,则毛利率分别升至 6% 和 80%。
换句话说,如果所有人都只使用 Fable,Anthropic 的订阅方案很可能已经拥有类似软件的利润率。随着 Anthropic 找到让模型更小的方法,Opus 级模型的服务成本将随时间推移继续降低,而 Fable 之上的新模型层级将拥有更低的订阅限额(假设它们被包含在内的话)。
另一方面,OpenAI 选择了核选项,直接一刀切地将所有方案的限额降至 Fable 级别。
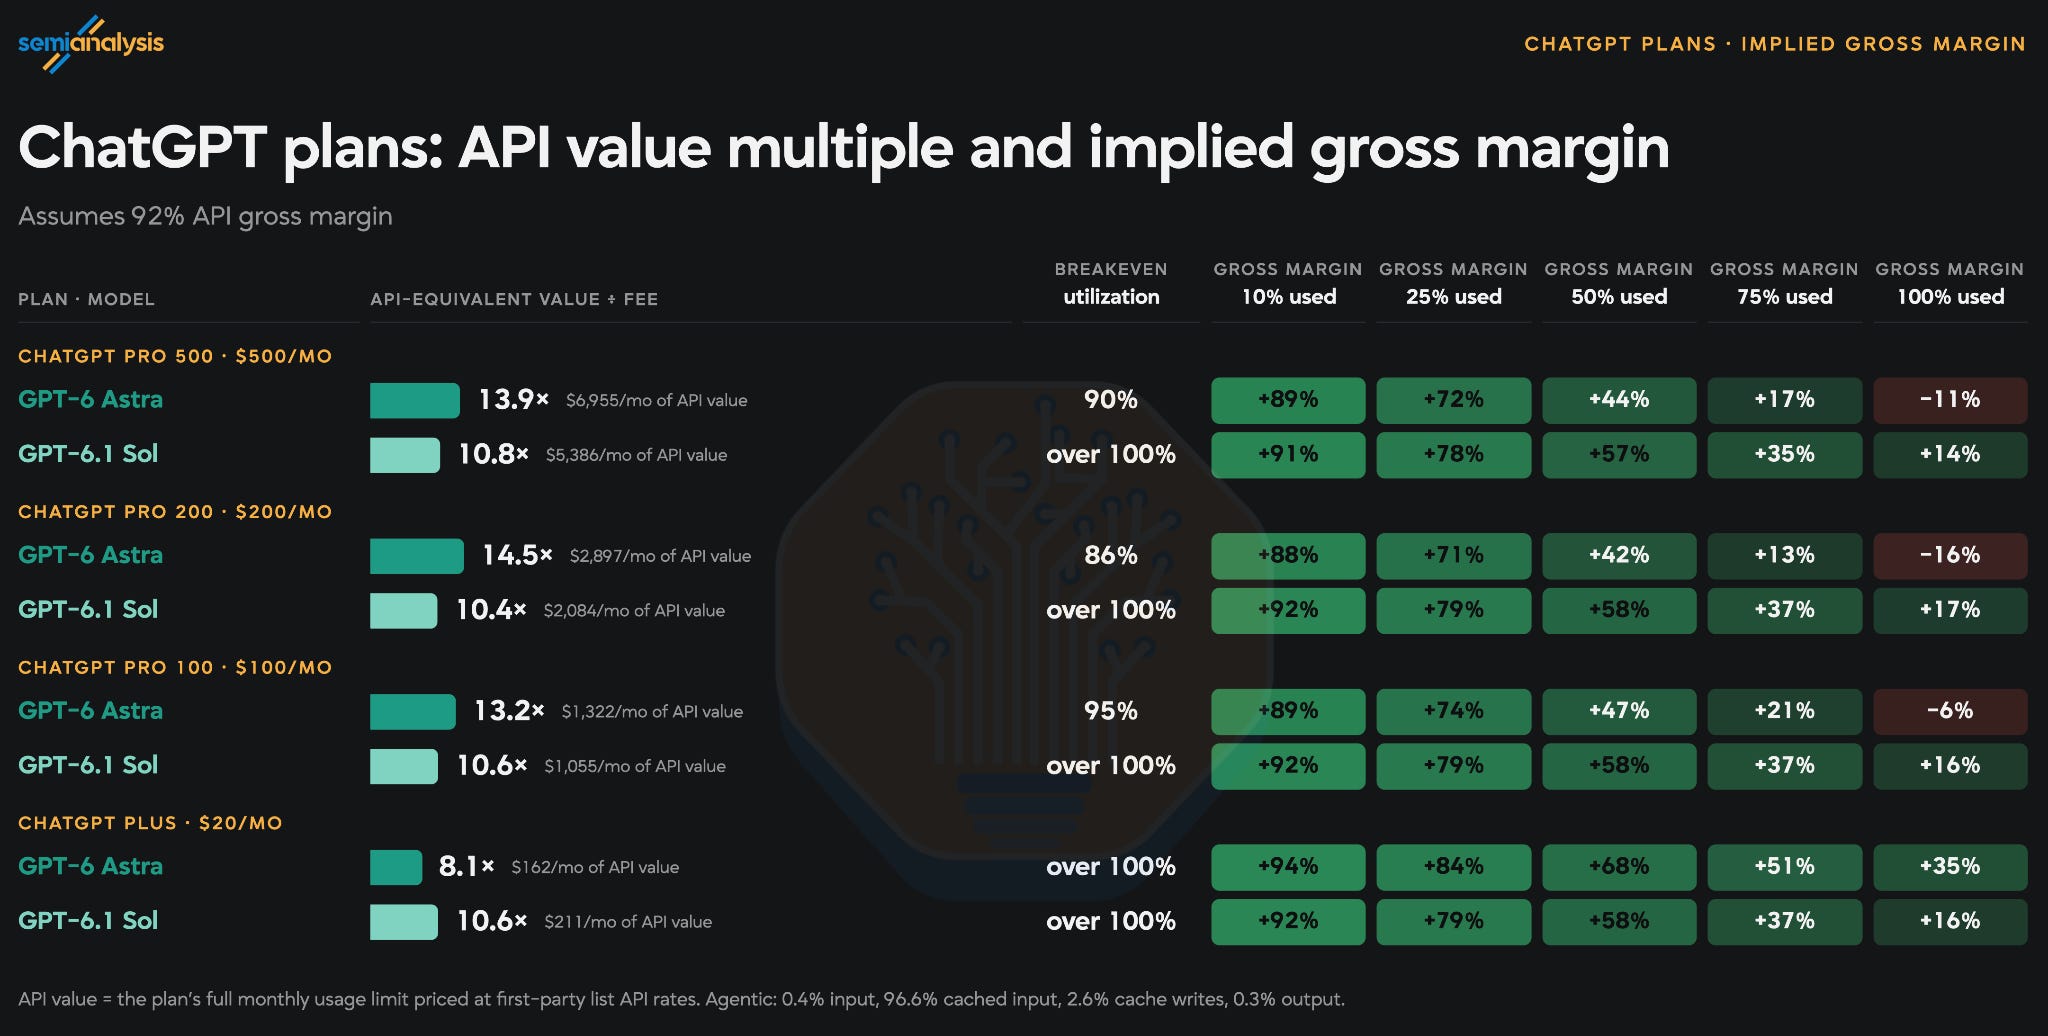
这种做法本应带来的负面影响是公众的强烈反对,但 OpenAI 不知何故几乎完全避免了这一点。这很可能是多种因素的结合:DevDay 的所有正面公关淹没了前一天负面消息,以及对现有方案额外保留一个月的 grandfathering。
中国订阅方案仍然很划算
尽管算力匮乏,中国实验室仍提供补贴订阅方案,但各模型之间的补贴力度差异巨大。
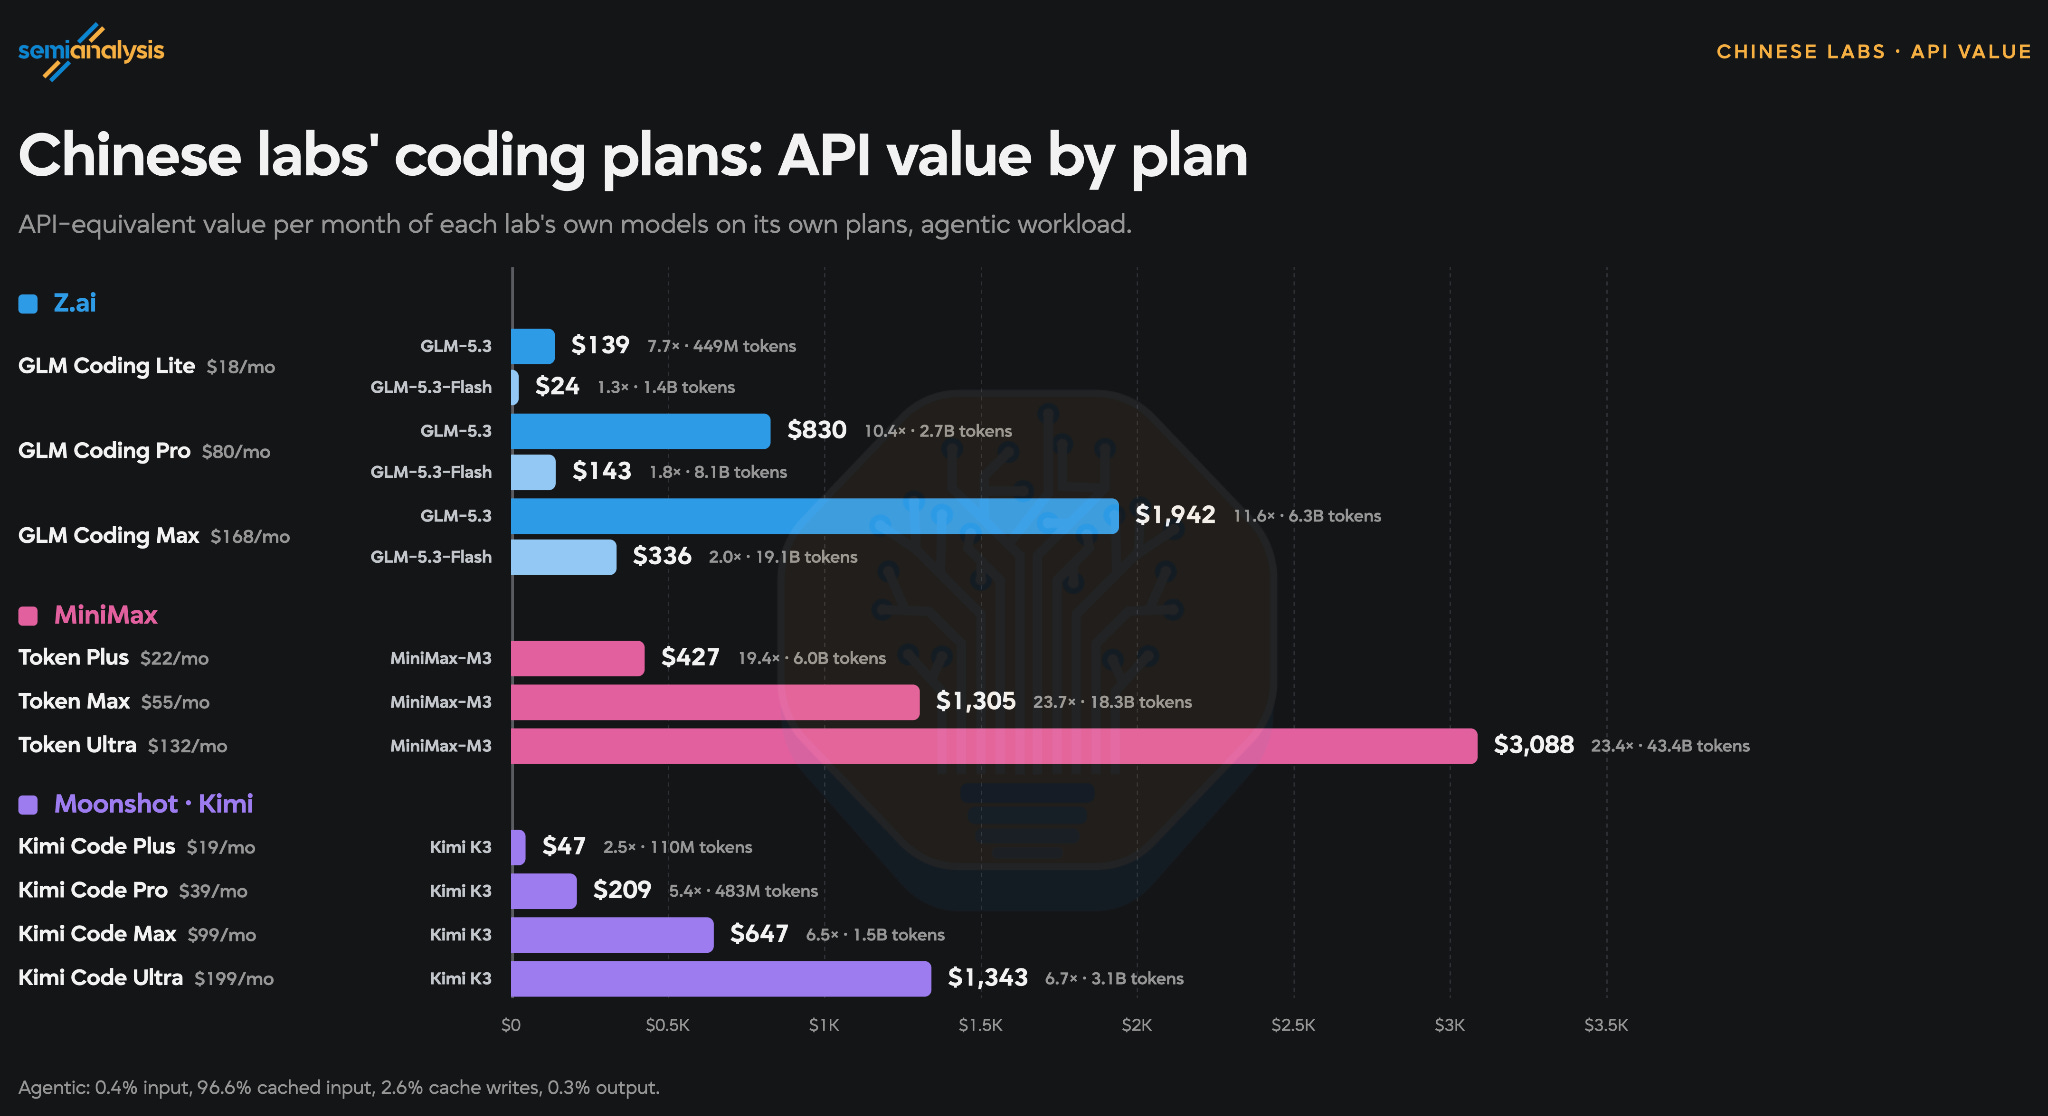
以下是按每美元归一化后,它们与 OpenAI 和 Anthropic 的对比。
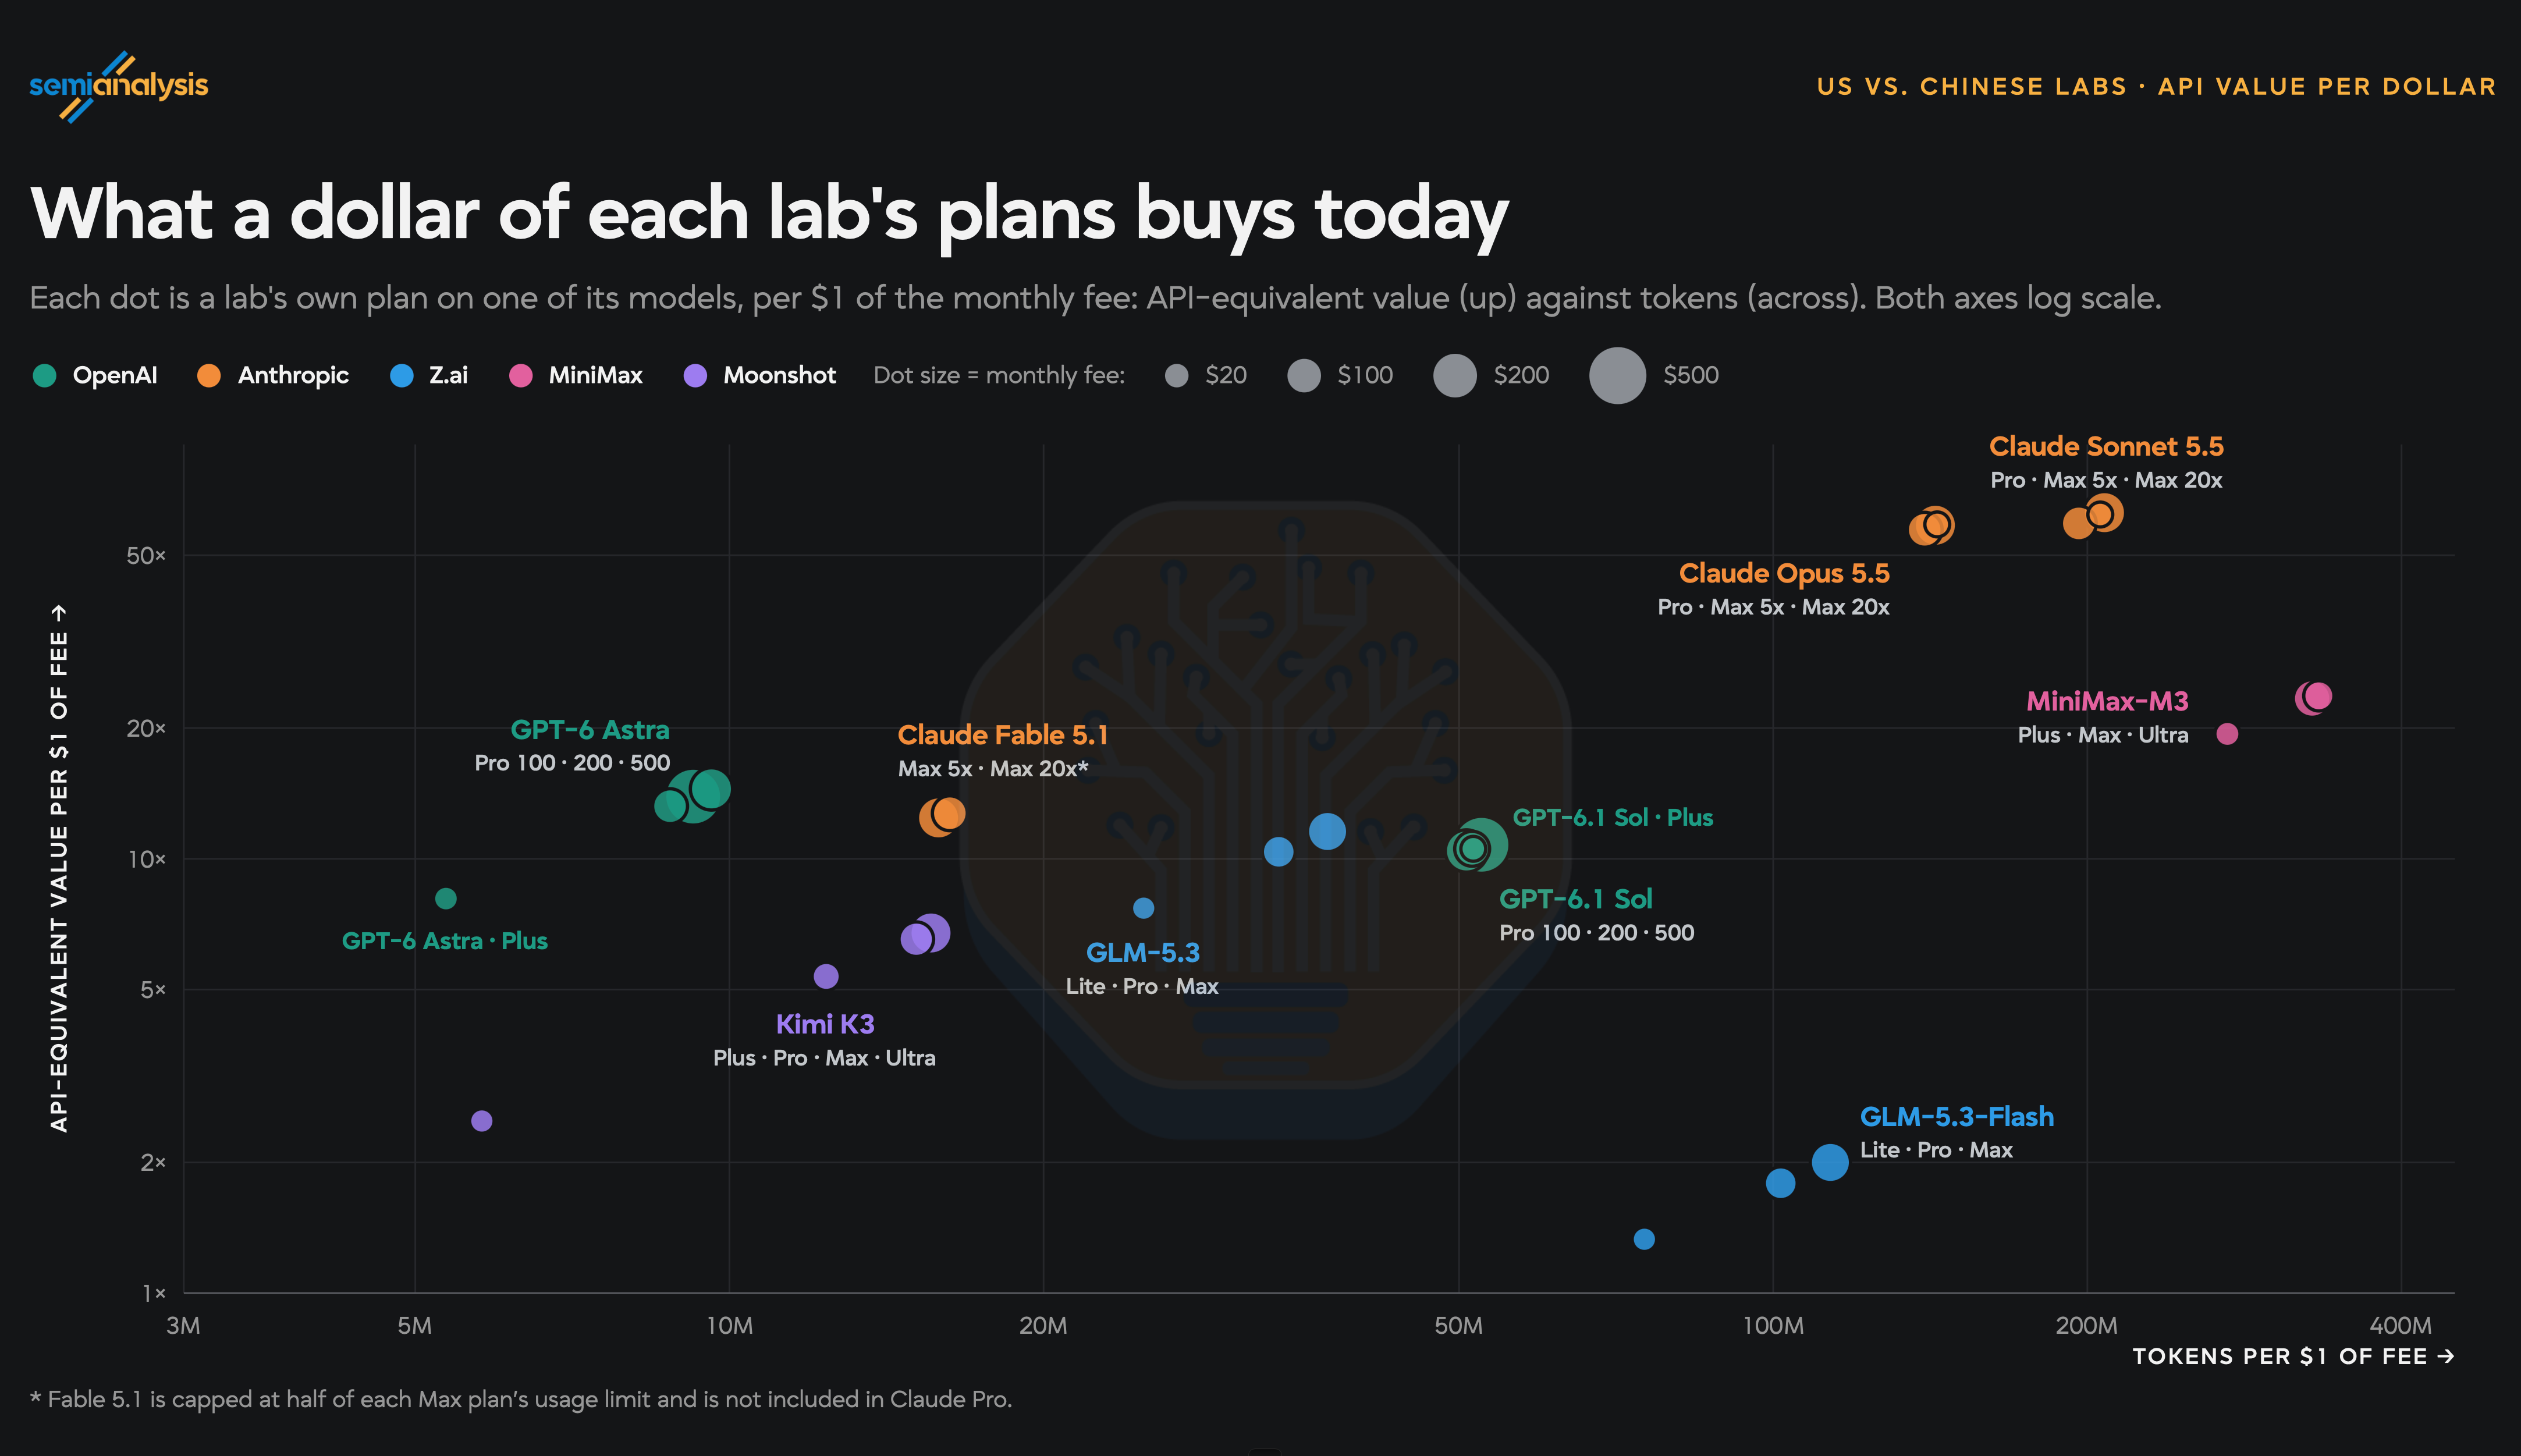
从中国实验室购买更高档位的订阅,每美元价值随之提升。平均而言,每美元的 API 等价价值略低于 OpenAI 的约 12 倍。
第三方方案不如第一方
我们要考虑的最后一项对比,是 OpenAI 和 Anthropic 模型在各自第一方方案上与 Cursor、Cognition(Devin)等第三方封装产品的对比。
来源:SemiAnalysis 长文 RSS · newsletter.semianalysis.com