Reflection 发布 501B-A23B 开源编码模型 Beam
[AINews] Reflection Beam - 501B-A23B American Open Model
Reflection 发布文本-only 的 501B 总参数 / 23B 激活 MoE 模型 Beam,面向编码、智能体和科学任务,从零训练,完整权重将在本月以 Apache 2.0 发布。
汇总了 Reflection Beam 的训练规模、基准成绩与第三方独立评价,读者可借此了解美国开源模型与中文模型的实际差距。
自从 Reflection 与我们一同发布 并定下宏大的编码目标(还暗示了他们的 RL 方法)以来,已经过去一年多了:
但他们保持“隐身”状态的时间比 Thinking Machines 更长,而且并不清楚我们是否还能等到他们发布模型,因为更广泛的开放模型生态并没有为他们放慢哪怕一点点。不过,我们确实等到了:
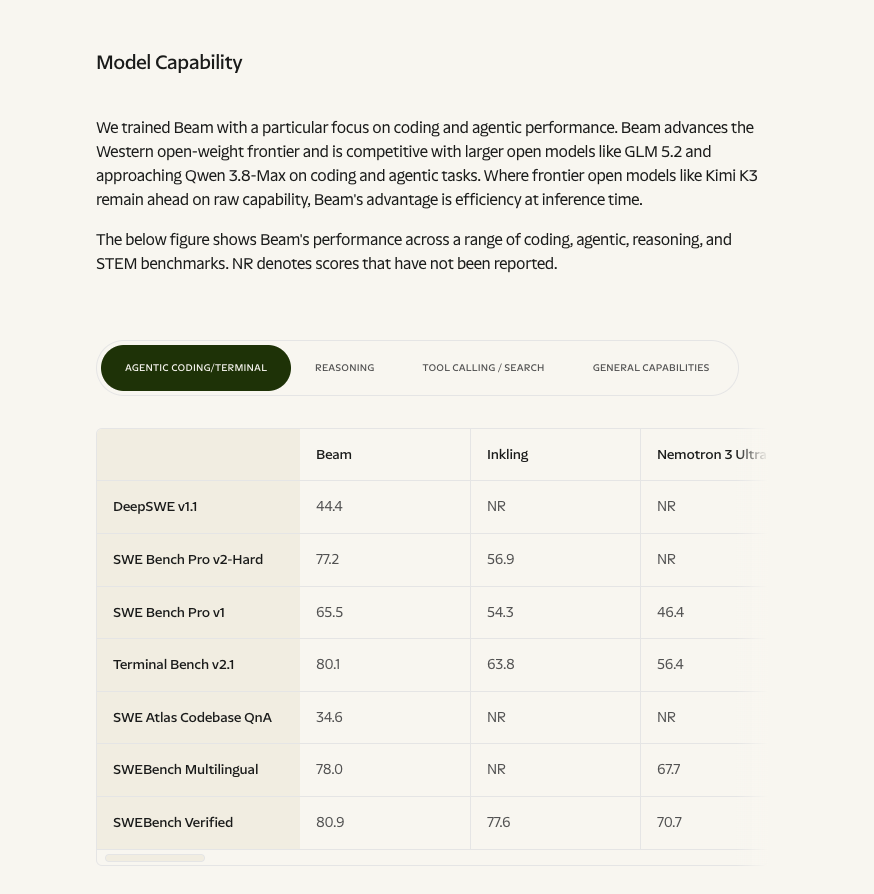
他们将自己与 Inkling、Nemotron 和 GLM 5.2 相比较,但 SOTA 的 GLM 5.3、Kimi K3、Qwen 3.8 Max 和 DeepSeek V4.1 Flash 总体上更胜一筹。不过,由于这是在美国从零开始训练的,市场上有一部分人一直在热切期待这里出现更多选择,更重要的是,Reflection 现已宣布自己作为一个可用的 neolab 正式登场!
2026 年 10 月 3 日至 2026 年 10 月 5 日的 AI 新闻。我们检查了 12 个 subreddit、544 个 Twitter 账号,没有进一步查看 Discord。AINews 网站 可让你搜索所有过往期刊。提醒一下,AINews 现在是 Latent Space 的一个栏目。你可以选择开启/关闭邮件频率!
AI Twitter 回顾
Reflection 的 Beam 引领一波开放权重发布潮
Beam 发布:Reflection 发布了 Beam,这是一个纯文本的 501B 总参数 / 23B 激活参数的 MoE 模型,面向编码、智能体和科学工作。它从零开始训练,采用 Apache 2.0 的完整权重预计本月发布(公告、Laskin)。
训练规模:团队帖子提到 23.8T 预训练 token,部分来自对数亿份 PDF 的 OCR 流水线(数据负责人)。他们还描述了在 10K 块 GB300 上稳定运行的 RL/OPD 训练,在约 100 万个任务上完成了超过 1 亿次 rollout(Damos)。
声称的结果:一份对 Reflection 声明的总结给出 SWE-bench Verified 上 80.9 的成绩、推理效率是 GLM 5.2 的 3–4 倍,以及在约 10,500 块 GB300 上各用四周进行预训练和 RL(总结)。技术报告和 OSS 集成也已承诺(Polozov)。
背景:Axios 提前报道了此次发布。报道称 Reflection 每月为 Colossus 算力支付 1.5 亿美元,外加一项 10 亿美元的 Nebius 协议,并且其他未具名的美国实验室将在本月发布开放模型(Curran)。
独立与批判性解读:Artificial Analysis 已提前获得访问权限,并预计 Beam 将跻身其智能水平下最省 token 的开放模型之列(AA)。
MFU 与架构:Elie Bakouch 估计预训练中 BF16 MFU 仅约 12%。他将该架构解读为 3:1 交错的全局/滑动窗口注意力,并指出其留出代码困惑度优于 DSv4(分析)。
算力对比:Teortaxes 称 Beam 是对 DeepSeek V3 的等 FLOP 复现(帖子)。他推断 4 周内约有 13 亿个 RL 沙箱,同时最多有 17 万个在运行(沙箱)。
定位:观察者将 Beam 定位在 GLM-5.2 水平附近(iScienceLuvr),并在某些基准上低于 DSv4 Flash(批评)。Nathan Lambert 将其与 Nvidia 和 Thinking Machines 归为一类,视为仍然落后于中国同行的美国强力发布(Lambert)。
其他开放与专用模型:
Aleph Alpha Kolibri:总参数 78B / 激活参数 3.46B,Apache 2.0 许可,面向德语和英语构建。自报得分为 AIME 2025 96.9%、GPQA Diamond 84.3% 和 SWE-Bench Verified 66.4%(摘要)。数据集未公开,智能体评测成绩明显低于 Qwen(Jitsev)。
Reka Rho-1:一个 19B 全模态模型,能够理解和生成文本、图像、视频和机器人动作,在 320 块 H100 上从零训练约 3 个月(公告,算力)。
决策模型:Command Code 的 Agr(31B)和 Agr-flash(360M)跳过文本生成,针对工具调用和路由返回带各选项概率的类型化值(Agr)。SemiAnalysis 解释说,TypeSafe 的 Jev 采用同样的无解码方法,主要在路由器角色中取代前沿模型(解读)。
较小规模发布:Upstage 的 Solar Mini 4(35B / 激活 3B,512K 上下文)在 Nous Portal 上免费开放两周(Nous)。Eleven v4 Turbo 以 v4 一半的价格登顶 AA 的 Provider Voice TTS 竞技场(AA)。
OpenAI vs Anthropic:订阅价值、速度与评测
SemiAnalysis 限额测试:SemiAnalysis 测试了 Anthropic、OpenAI、Meta、SpaceXAI、MiniMax、Moonshot、Cursor、Cognition 等公司的套餐。结果发现,Claude 订阅提供的 API 等值价值是 OpenAI 套餐的 5 倍以上(报告)。
OpenAI 容量紧张:用户报告称,新的 $200 订阅注册已暂停,各套餐的使用限额实际上被减半。GPT-6.1 Sol 被定位为高效替代方案(分析)。Theo 描述了 7 月至 9 月间编码模型偏好的逆转(帖子)。
OpenAI 回应:Codex 负责人 Tibo 承诺在 28 天内每天带来有意义的改进或完全重置(承诺)。
第 1 天提速:GPT-6 Astra 和 GPT-6.1 Sol 的默认速度提升约 50%,从约 30 TPS 升至约 50 TPS。该变更覆盖所有订阅入口以及 OpenCode、Pi、Amp 和 Devin 等 Sign in with ChatGPT 合作伙伴(第 1 天,TPS)。
摩擦:已储存的 Codex 重置额度到期时不会按时区调整(报告)。常驻的 dots 智能体仅限 $100+ Pro 套餐使用(批评)。
企业需求(据报道):The Information 报道称,微软将内部 Anthropic 的预计支出削减了三分之一以上。报道还称,Meta 的 Claude Code 用户从约 6 万降至约 3 万,主要原因是推动使用 Meta 自有工具(摘要)。
排行榜:
Agent Arena:Anthropic 在 Code、Work 和 Chat 中均排名第 1。Fable 5.1 在 Code 和 Work 中领先,而 GPT-6 Astra 在 Code 中排名第 2(Arena)。
Design Arena:GPT-6 Astra 在 3D Design、Frontend、Full Stack 和 Image-to-HTML 中排名第 1(Design Arena)。
幻觉:在 AA-Omniscience 上,Gemini 4 Argon 对不知道的问题猜错的比例为 15%,而次优模型为 29%。GPT-6 Astra 的准确率最高,为 61%(数据)。
Agent Harness、RL 环境与开发者工具
多 harness RL(Hugging Face):一个捕获代理支持 OpenAI Chat、OpenAI Responses、Anthropic 和 Gemini 格式。它将调用转发给 vLLM,并为 TRL 记录精确的 token ID 和 logprobs,从而使 10 个未经修改的 harness 成为 RL 环境(Delangue,说明)。
结果:相同权重在 Mini-SWE-Agent 下得分 62%,在 Claude Code 下得分 33%。在 4 个 harness 上训练 LFM2.5-2.6B,将首次尝试解决率从 42% 提升到 54%,工具调用奖励使调用次数减少 31%。在 3,189 条 rollout 上做 SFT 后停滞在 47.5%。
注意事项:该运行仅使用了一个任务族和一个随机种子。
环境托管:RL 环境现在像数据集一样在 HF Hub 上托管并进行版本管理(博客)。
Pi Durable:Earendil 的 harness 围绕一个小型基于任务的工作流引擎构建,因此长时间运行、多玩家的 agent 可以在任意位置挂起和恢复(Pi)。
Agent 记忆:Cognition 推出了 Devin“Dreaming”,它在夜间修剪并链接记忆图。它将以 git 和 markdown 为后端的格式作为 Agent Memory Repo 开源(发布,格式)。
Cursor SDK:此次更新增加了运行中引导、向父级汇报的后台子 agent、可替换的系统提示,以及自定义工具上的 MCP
readOnlyHint和destructiveHint注解(引导,注解)。DeepSeek Harness:v0.2.1-alpha.1 中的实验性 Claude Code Mods 兼容层,用于测试 DSH 的“一切皆插件”架构是否是 Claude Code 扩展点的超集(团队文章)。
路由与访问:
Agent 与训练研究
以验证代替采样:
上下文管理:
自我改进的 harness:
优化与架构:
Dust:一种零阶方法,使用激活扰动“虚拟种群”逼近,有时超过反向传播在 transformer 预训练上的表现。它声称比 EGGROLL 的计算效率高 1,000–10,000 倍(帖子串)。
LOOM:循环 MoE 在 9–12 次循环下稳定训练,而在等 FLOP 下,700M 模型在 5 次循环时最佳(帖子串)。
ImageNet 上的策略梯度:Ian Osband 表明,精确策略梯度在 ImageNet 上达到 4%,而交叉熵为 62%,他认为 RL 损失的失败不只是探索问题(帖子)。
RL 动态:Base Labs 发现 RL 更新的低秩性低于此前声称(rollout)。Datalab 报告,在温度 0 下,仅 RL 就能消除工具调用循环,而 SFT 的循环率为 92%(文章)。
AI for science:Vals AI 报告,90 多个 Opus 5.5 智能体在 3 天内运行 DFT 模拟,并标记出两个室温磁性半导体候选材料,其中一个早在 1999 年就已合成。结果仅为预测,并附有公开记录(帖子串,注意事项)。
智能体支出:Epoch 估计,OpenAI 研究人员的编码智能体支出按 API 价格计算,大约每月翻一番。到 8 月中旬,中位研究人员约为 $600/天(Epoch)。
推理系统与硬件
OpenRouter 定价失真:Horace He 指出,在 inference.net 上 GLM 5.3 的定价为输入 $0.08/M,但输出 $5.00/M。他将此归因于 OpenRouter 的平方反比价格路由,以及对输入价格的明显过度加权(帖子串,路由)。
llama.cpp:
智能体内核工作:Baseten 报告,一个在一周内主要靠自主智能体工作构建的引擎,解码速度比开源基线快 90%,TTFT 低 57%(博客)。
通信:NCCL 和 PyTorch 对称内存加速中小规模集合通信(Bekman)。
中国加速器:阿里巴巴平头哥的镇武 V900 拥有 216 GB 内存和 1,200 GB/s 互连带宽,宣称性能是 M890 的 3 倍,将于 2027 年第一季度出货(SemiAnalysis)。
安全、政策与产业
OpenAI 文本水印:根据《人工智能法案》,OpenAI 将在欧盟为符合条件的 ChatGPT 和 Codex 文本添加不可见的统计水印,并在全球范围内提供可选的 API 开关(公告)。
智能体事件与安全治理:
政策声音:
中国的算力获取:
整合:
AMD 与 World Labs(据报道):据报道,AMD 以 82 亿美元收购了 World Labs(DL Weekly)。
NVIDIA 中立性:SemiAnalysis 在 NVIDIA 收购 SchedMD/SLURM 和 Hugging Face 后,质疑其硬件中立性(SemiAnalysis)。
热门推文(按互动量)
Tibo:连续 28 天每天对 Codex 进行一次改进或重置 — 30.9K
Achiam:禁止某些自主武器 — 11.2K
OpenAI 欧盟文本水印 — 7.7K
Reflection 推出 Beam — 7.4K
HF:将编程测试框架作为强化学习环境 — 2.5K
AI Reddit 回顾
/r/LocalLlama + /r/localLLM 回顾
1. 超大规模下的本地 LLM 硬件
来源:Latent Space · latent.space